pandas按若干个列的组合条件筛选数据的方法
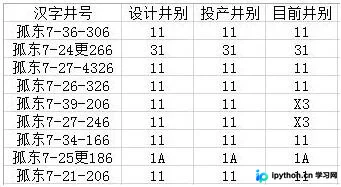
本文介绍如何使用pandas根据多个列的组合条件筛选数据。通过示例展示如何筛选“设计井别”、“投产井别”和“目前井别”均为11的记录,并演示如何通过反向逻辑删除这些行。包含完整的代码实现及文件读写注意事项,适用于需要复杂条件过滤的数据处理场景。
2026-10-14
7

本文介绍如何使用pandas根据多个列的组合条件筛选数据。通过示例展示如何筛选“设计井别”、“投产井别”和“目前井别”均为11的记录,并演示如何通过反向逻辑删除这些行。包含完整的代码实现及文件读写注意事项,适用于需要复杂条件过滤的数据处理场景。
本文介绍利用 pandas 库实现类似 SQL 中 dateadd 和 datesub 功能的日期处理方法。通过 DateOffset 对象,可分别计算当月、当季及当年的第一天与最后一天,并演示如何获取昨日日期、星期几以及生成自定义频率的时间序列。
本文详解Pandas中处理重复记录的两种核心方法:duplicated用于标记重复行,drop_duplicates用于直接删除。通过解析subset、keep及inplace等关键参数,结合DataFrame与Series的具体代码示例,帮助开发者高效完成数据去重与清洗工作。
在使用Pandas处理CSV文件时,Excel中的空白单元格可能被解析为空字符串而非NaN,导致dropna()或fillna()失效。本文介绍通过正则替换空字符串为NULL,并在read_csv中指定na_values参数将其识别为缺失值,从而正确执行缺失值处理的操作流程。
本文介绍了在Python中使用Pandas库创建空DataFrame的两种常见方法。通过指定列名初始化一个无数据的DataFrame,以及直接创建完全空的DataFrame对象。文章提供了具体的代码示例和输出结果,帮助开发者快速掌握数据结构的初始化技巧,适用于需要预先定义数据结构或进行数据处理的场景。
本文介绍Python中利用records库将数据库或文本数据导出至Excel文件的实例。作为数据分析师,掌握Python及Linux命令处理复杂数据筛选排序至关重要。records库由Kenneth Reitz开发,支持对接多种关系数据库,并能便捷地将查询结果导出为Excel、CSV、JSON等格式,代码简洁高效。
本文介绍Python中处理非数值类别数据的三种方法:使用LabelEncoder快速转换、通过字典映射手动指定数值,以及利用get_dummies生成虚拟变量。内容涵盖具体代码实现与适用场景,帮助开发者高效完成数据预处理。
本文详细介绍在 Python 中使用 Pandas 库对 DataFrame 进行行与列求和,并将结果作为新列或新行添加至数据框末尾的具体操作方法。通过导入模块、生成随机数据及应用 apply 函数,实现数据的汇总与扩展,为数据分析提供基础支持。
本文详细介绍Python中Pandas库的核心功能,涵盖Series一维数据与DataFrame二维表格的创建与操作。内容包含安装导入、数据选择切片、缺失值处理、统计函数应用、数据合并及时间序列重采样等关键操作,帮助开发者快速掌握科学计算基础。
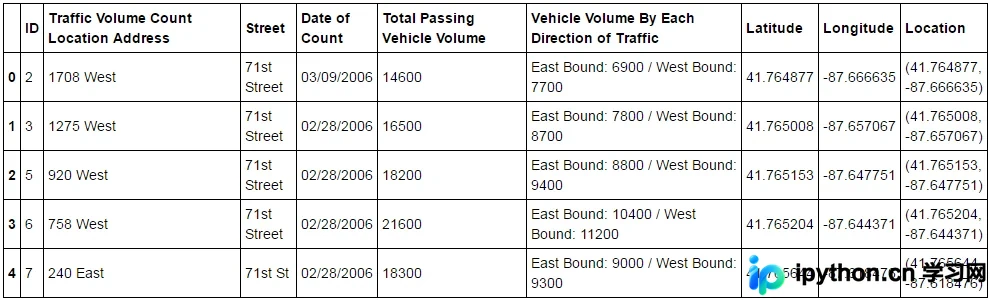
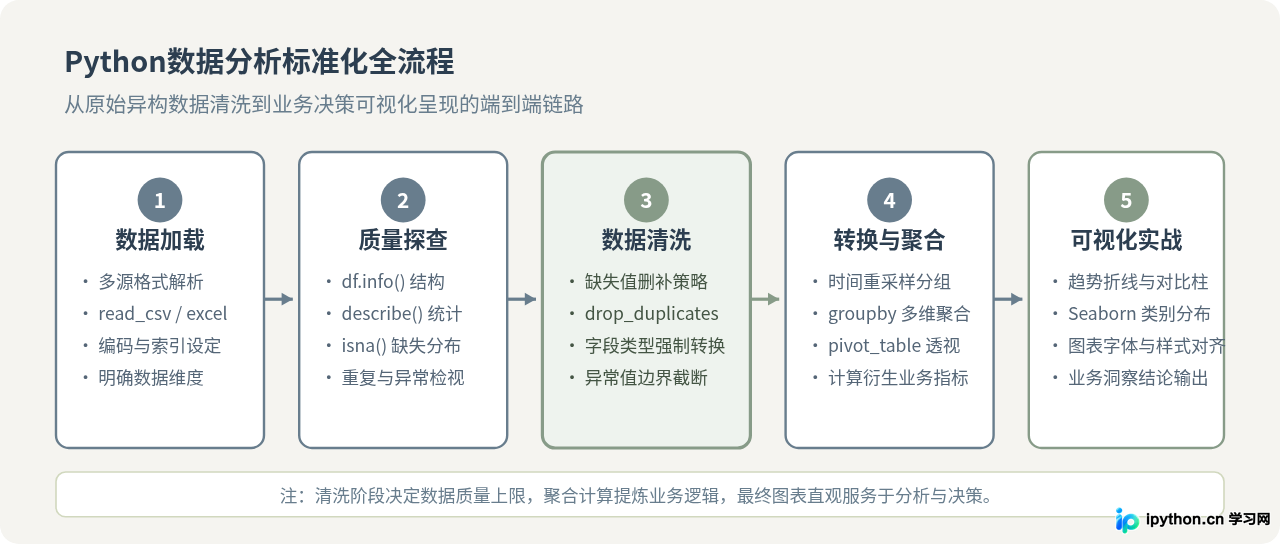
系统梳理Python数据分析端到端实战流程,涵盖原始数据探查、Pandas缺失与异常值清洗、关键策略对比、多维指标聚合与Matplotlib/Seaborn图表可视化。
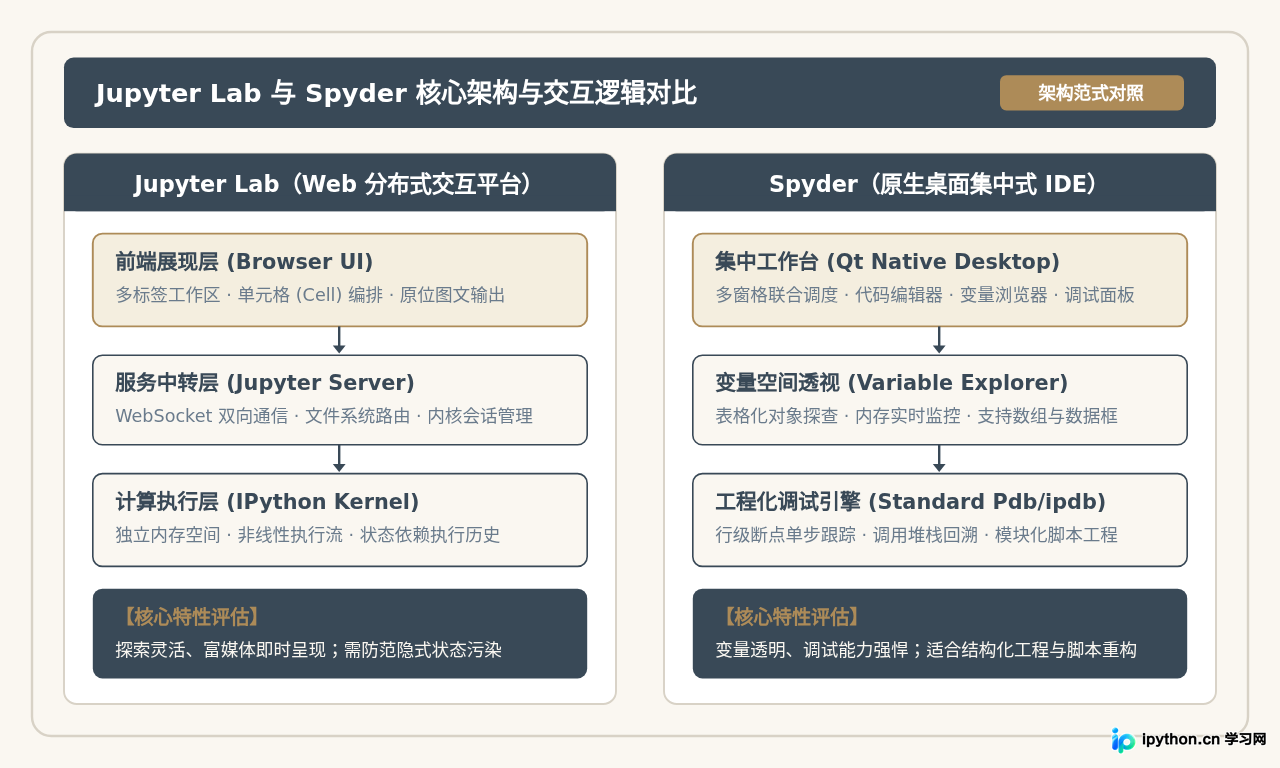
深入对比数据科学从业者常用的Python开发工具Jupyter Lab与Spyder,解析交互式探索与集中式工程调试的核心差异、操作流程与选型依据。
深入解答Python数据分析的掌握程度标准,梳理Pandas在结构化数据清洗、多表合并、分组聚合与数据可视化领域的实战规范与自测清单。