

Python Pandas DataFrame 行列求和及新增行列操作详解
本文详细介绍在 Python 中使用 Pandas 库对 DataFrame 进行行与列求和,并将结果作为新列或新行添加至数据框末尾的具体操作方法。通过导入模块、生成随机数据及应用 apply 函数,实现数据的汇总与扩展,为数据分析提供基础支持。
2026-10-13
7

本文详细介绍在 Python 中使用 Pandas 库对 DataFrame 进行行与列求和,并将结果作为新列或新行添加至数据框末尾的具体操作方法。通过导入模块、生成随机数据及应用 apply 函数,实现数据的汇总与扩展,为数据分析提供基础支持。
本文详细介绍Python中Pandas库的核心功能,涵盖Series一维数据与DataFrame二维表格的创建与操作。内容包含安装导入、数据选择切片、缺失值处理、统计函数应用、数据合并及时间序列重采样等关键操作,帮助开发者快速掌握科学计算基础。
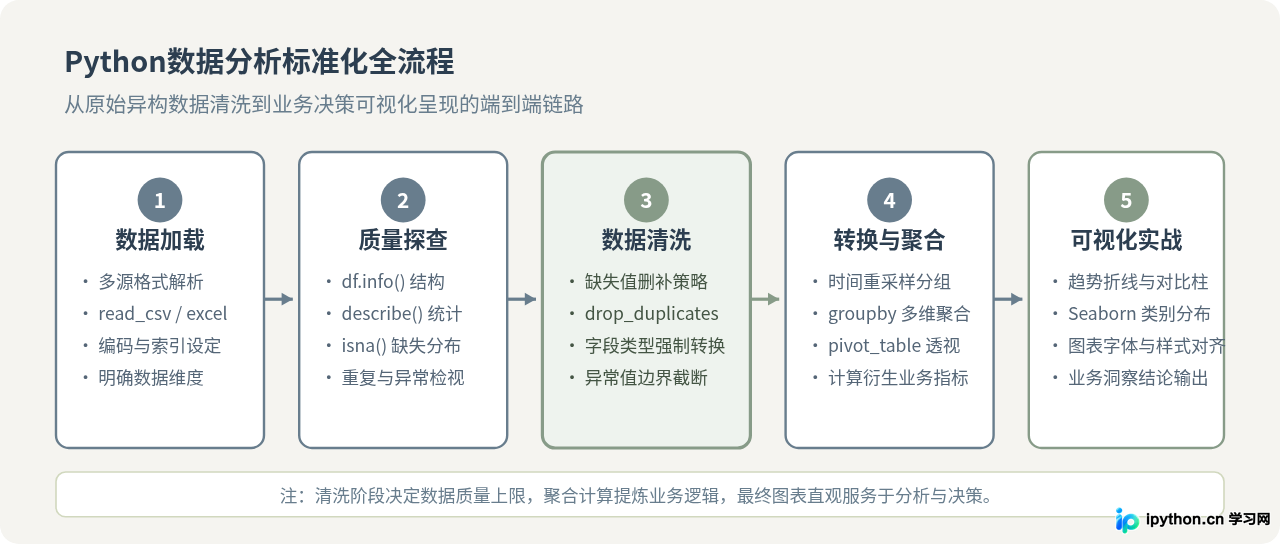
系统梳理Python数据分析端到端实战流程,涵盖原始数据探查、Pandas缺失与异常值清洗、关键策略对比、多维指标聚合与Matplotlib/Seaborn图表可视化。
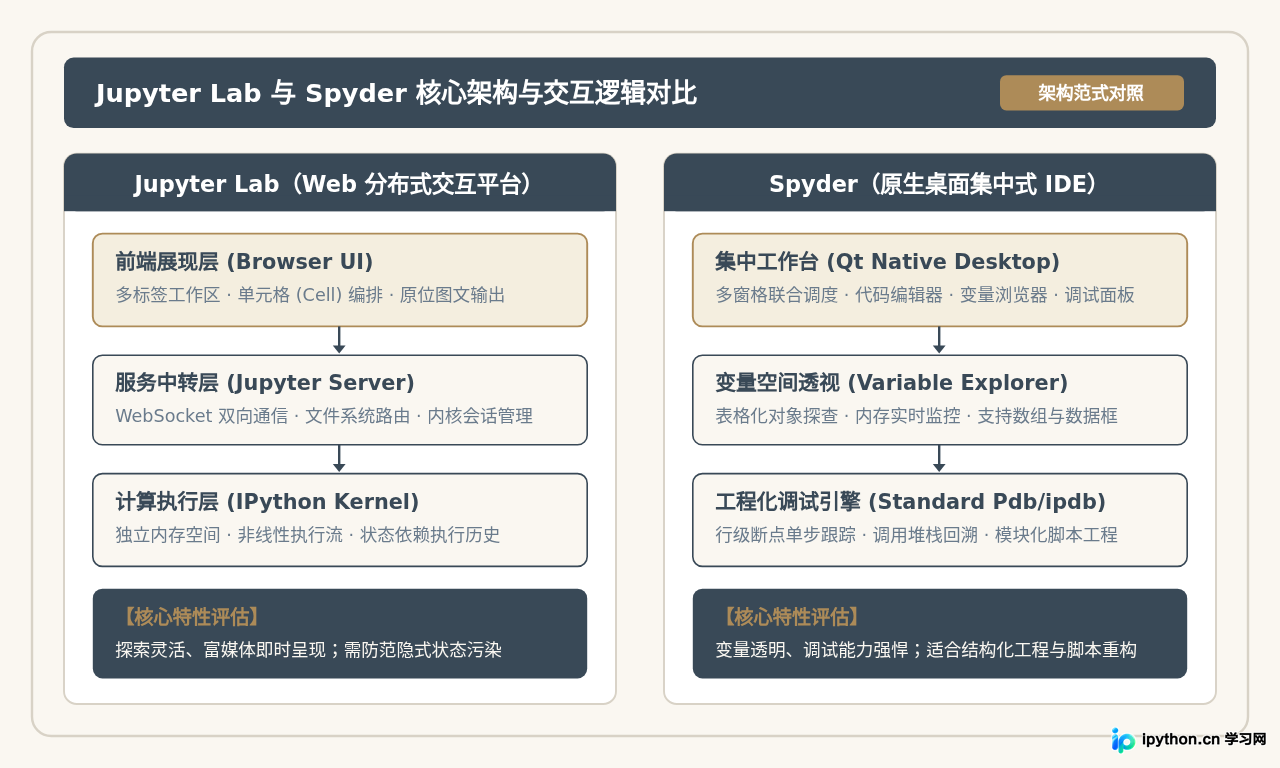
深入对比数据科学从业者常用的Python开发工具Jupyter Lab与Spyder,解析交互式探索与集中式工程调试的核心差异、操作流程与选型依据。
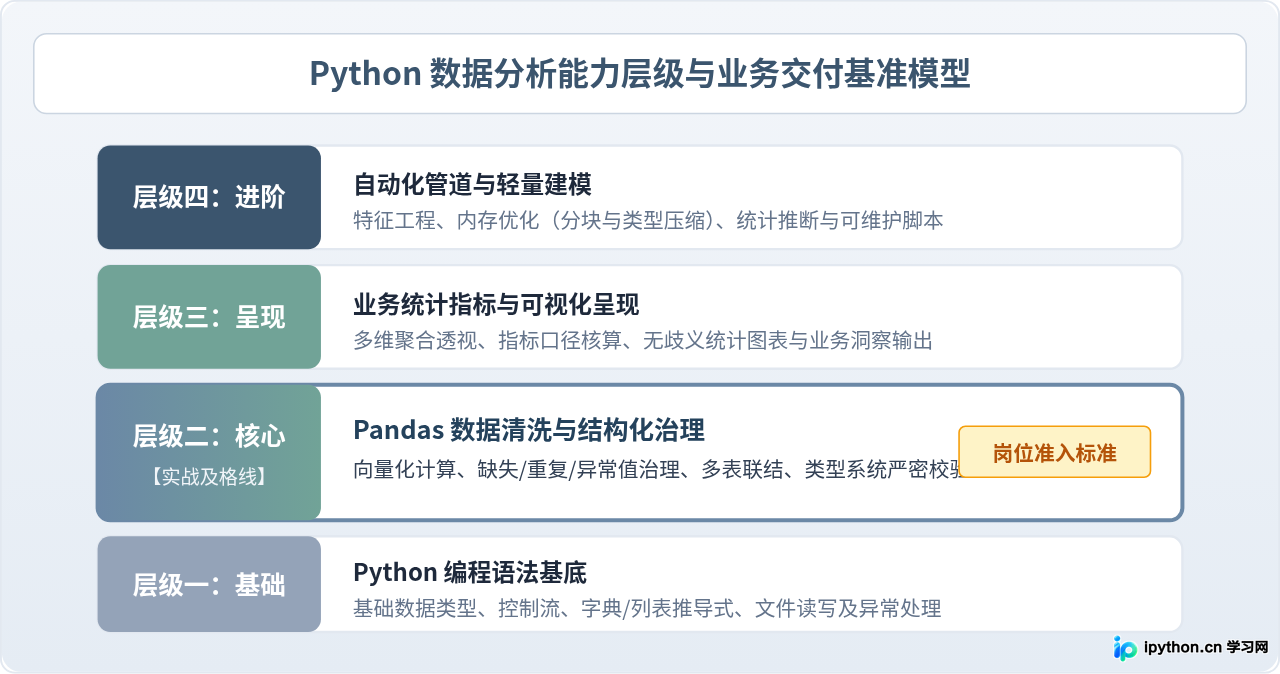
深入解答Python数据分析的掌握程度标准,梳理Pandas在结构化数据清洗、多表合并、分组聚合与数据可视化领域的实战规范与自测清单。
深入解析数据科学领域常用Python编辑器Jupyter Notebook的核心概念、工作原理、基本操作流程与优缺点,帮助读者全面理解交互式计算环境。
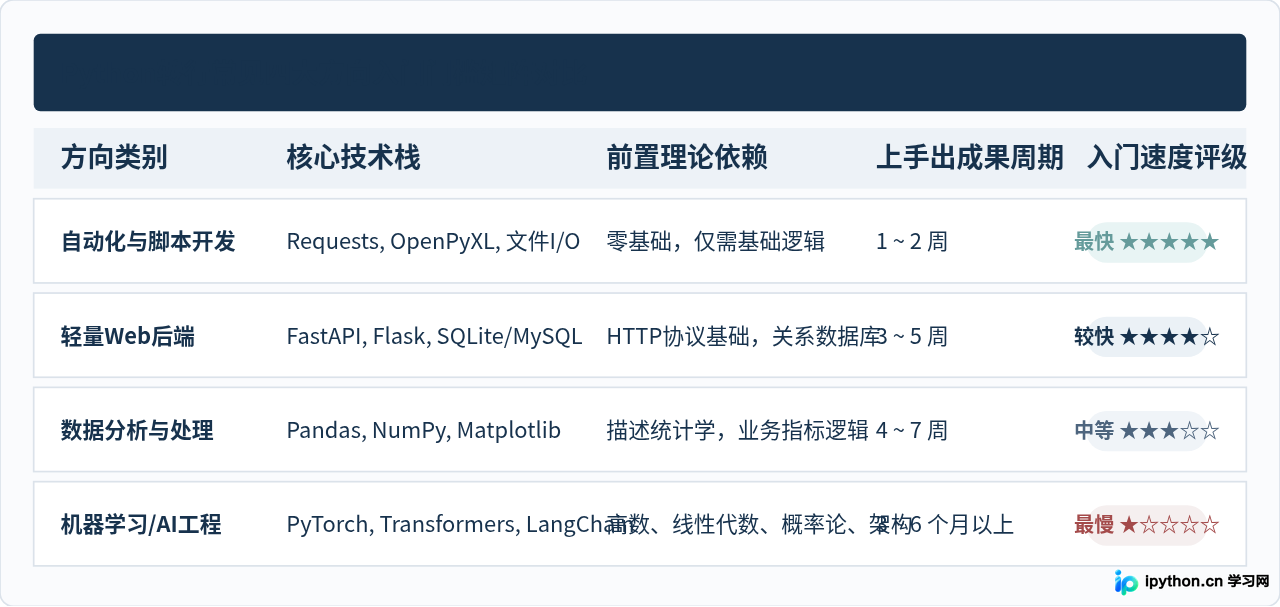
针对零基础转行Python开发群体,客观对比自动化办公、网络爬虫、Web后端与数据分析等主流方向的入门门槛、学习周期与上手路径,给出切实可行的转型建议。
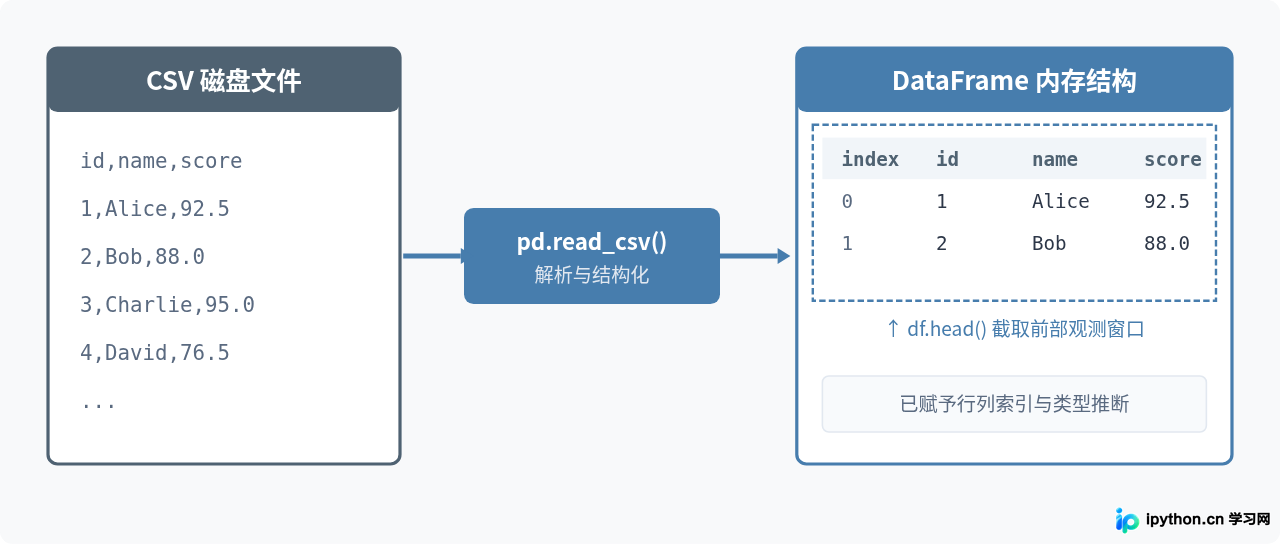
本文详细讲解如何使用Python的pandas库通过read_csv函数读取CSV文件,并使用head()方法高效查看前几行数据,涵盖标准操作流程、参数调整与常见排查方法。
针对日常繁琐的重复性工作,Python提供了强大的办公自动化解决方案。本文通过集成pandas、python-docx、PyPDF2等核心库,详细演示Excel数据处理、Word报告生成、PDF文件合并、SMTP邮件自动分发及批量文件整理的完整操作流程。掌握这些脚本后,可将数小时的手动任务压缩至分钟级,大幅提升职场效率。
本文详解Pandas库处理时间序列数据的三大核心工具:滑动窗口用于捕捉局部动态,重采样用于调整时间粒度,趋势分析用于揭示长期走向。通过实际案例展示如何用简洁代码快速定位异常波动、转换数据频率并建立预测模型,助力物联网、金融和智能制造等领域的高效数据分析。
职场日常常涉及大量重复性数据任务,例如合并数十份销售报表、按候选人名单批量生成录用通知、清理杂乱的下载目录。本文提供基于Python的自动化解决方案,通过调用pandas、docxtpl及系统文件模块,实现Excel数据透视汇总、Word模板自动填充与分类归档。掌握相关参数配置后,可替代人工手动复制粘贴,将耗时数小时的操作压缩至秒级完成。
本文演示如何基于Python从零构建多尺度文本统计模型。通过非重叠窗口提取1至5字符片段,结合Pandas进行频次排序,并利用交叉减法消除长短片段的重复计数。该流程可为自定义分词器设计、文本压缩编码及NLP数据清洗提供可落地的工程参考。