

Python Pandas DataFrame 重置索引与列名的两种方法
本文介绍在Python中使用Pandas库处理DataFrame时,如何高效重置或修改列名。通过两个实例演示了使用rename方法结合inplace参数,以及直接对columns属性进行赋值这两种常用操作,帮助开发者快速掌握数据预处理中的关键技巧。
2026-10-13
7

本文介绍在Python中使用Pandas库处理DataFrame时,如何高效重置或修改列名。通过两个实例演示了使用rename方法结合inplace参数,以及直接对columns属性进行赋值这两种常用操作,帮助开发者快速掌握数据预处理中的关键技巧。
本文详解如何在 Pandas DataFrame 中检测列是否存在空值,并通过 isnull() 与 any() 组合返回 Series 结果。介绍将检测结果转化为 DataFrame 以筛选非空列的方法,以及针对特定列如 nkill 提取含空值记录的技巧。最后演示使用 fillna() 进行原地填充,支持指定数值或统计量(如中位数),并强调 inplace=True 参数对原数据直接修改的作用。
本文详细介绍在 Python 中导入 CSV 文件的三种常用方法。首先通过标准库 csv 结合 NumPy 数组处理基础数据;其次利用 NumPy 的 loadtxt 函数处理无表头且类型统一的数据;最后重点推荐 Pandas 库的 read_csv 函数,因其返回 DataFrame 结构,便于后续数据清洗与机器学习建模,是实际开发中的首选方案。
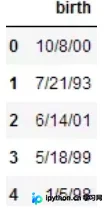
本文介绍在Python数据挖掘中,如何利用Pandas库将出生日期Series转换为年龄。通过pd.to_datetime格式化日期,结合datetime获取当前年份并相减,生成age特征变量,有效降低数据维度并提升算法训练效果。
Python 3.x 已不再支持 MySQLdb,推荐使用 PyMySQL 库进行数据库交互。本文介绍了通过 pip3 install PyMySQL 安装库的方法,并展示了利用 pymysql 建立连接、执行 SQL 查询并将结果转换为 Pandas DataFrame 的完整代码示例,解决 No module named 'MySQLdb' 报错问题。
本文详解Python中离散变量One-Hot编码的两种主流实现方式。通过对比pandas的get_dummies与sklearn的LabelEncoder结合OneHotEncoder,解析字符串与数值型变量的处理差异。文章包含具体代码示例,展示从数据导入、特征查看到编码生成的完整流程,帮助开发者根据数据类型选择合适方案。
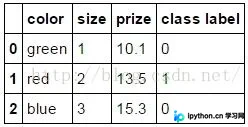
本文介绍在pandas中利用get_dummies函数对离散特征进行one-hot编码的方法。针对无序分类特征如颜色,可直接使用get_dummies生成独热向量;针对有序特征如尺码,则建议先通过字典映射转换为数值。文章提供了具体的DataFrame构建、映射及编码代码示例,帮助开发者高效完成数据预处理。
本文系统梳理了Python中处理CSV文件的两种主流方式:内置csv模块与第三方Pandas库。详细解析了csv.writer、csv.DictWriter等核心类的创建与读写方法,涵盖数据写入、读取及方言注册;同时深入讲解Pandas中read_csv、to_csv等导入导出接口,以及数据筛选、清洗、分组聚合、合并与统计等高频操作,助力开发者高效处理结构化数据。
本文详解Python Pandas库中DataFrame的drop函数,用于删除指定的行或列。通过axis参数控制删除方向(0为行,1为列),并解释inplace参数对原数据的影响。提供代码示例展示如何删除指定索引的行或特定列,帮助开发者高效处理数据。
本文总结Pandas读取CSV文件时常见的OSError错误,主要原因为文件路径包含中文导致无法正确加载。提供两种解决方案:修改为全英文路径或在文件名前添加u前缀,推荐优先使用第一种方案以彻底避免编码问题。
本文介绍如何利用Python的openpyxl库与正则表达式,解决Excel中非规律性数据的提取难题。通过定义日期和邮箱的正则模式,遍历指定单元格范围提取关键信息,并将结果写入新建的工作表中,最终实现自动化数据整理与保存,适用于需要统计特定时间段项目用时的场景。
本文详细介绍 Python 中 Pandas 库 DataFrame 对象的基础操作方法。内容涵盖如何基于列表、数组和字典创建 DataFrame,以及如何执行索引访问、行列求和、元素变换等常用计算。此外,文章还演示了通过 append 方法扩充行与列的具体步骤,并深入解析了使用 join 函数进行内连接、外连接等多种数据合并策略,帮助开发者高效掌握数据处理核心技能。