

Python pandas多级索引取值实战:重置列与直接索引法
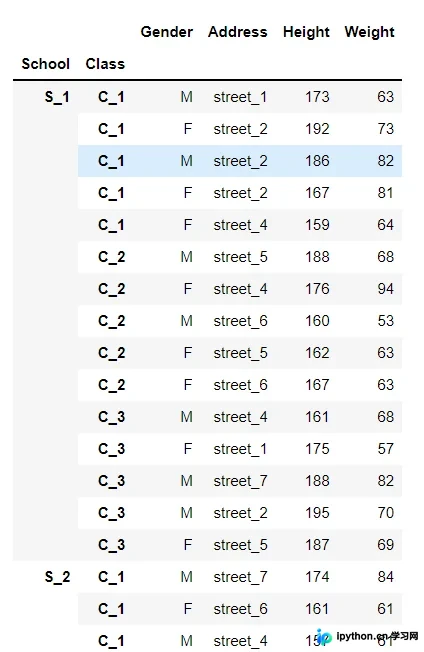
本文详解pandas中多级索引数据的提取技巧。通过重置索引为列并结合布尔条件或query方法,以及利用链式调用和元组索引直接取值,解决多层级数据查找问题。文章对比两种方法的操作步骤与注意事项,帮助开发者高效处理复杂索引结构。
2026-10-16
7

本文详解pandas中多级索引数据的提取技巧。通过重置索引为列并结合布尔条件或query方法,以及利用链式调用和元组索引直接取值,解决多层级数据查找问题。文章对比两种方法的操作步骤与注意事项,帮助开发者高效处理复杂索引结构。
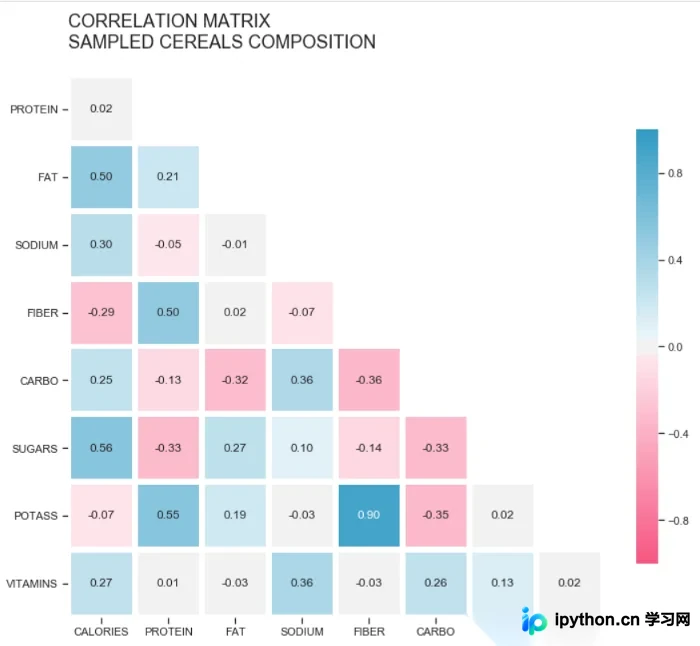
本文详细介绍如何使用Python的Seaborn库绘制高质量热力图。内容涵盖从导入Pandas和Numpy进行数据预处理开始,通过corr()计算相关性矩阵,利用Mask矩阵去除冗余上三角区域,以及调整参数显示具体数值。此外,还深入讲解了如何使用diverging_palette优化发散型调色板,提升视觉表现力,最终生成带有标题和格式优化的专业级相关性热力图。
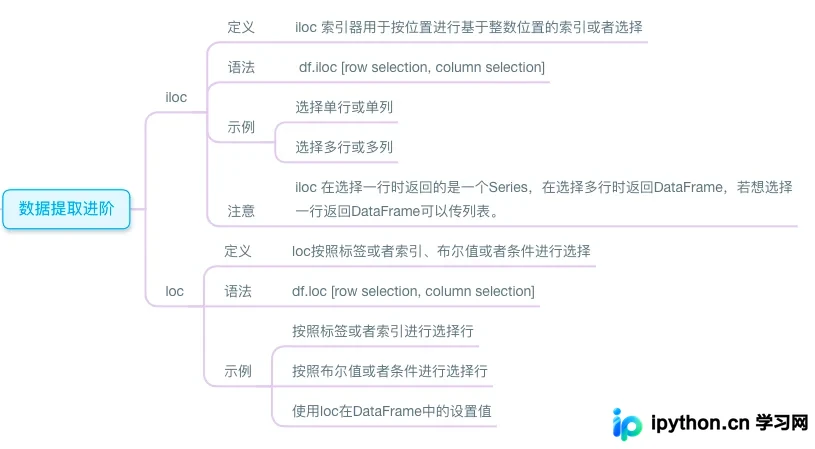
本文详解Python Pandas库中iloc和loc两种核心索引器的用法。iloc基于整数位置进行数据选取,返回Series或DataFrame;loc基于标签、索引或布尔条件进行筛选。通过具体代码示例,展示如何根据位置或标签选择单行、多列及设置值,帮助开发者高效处理数据。
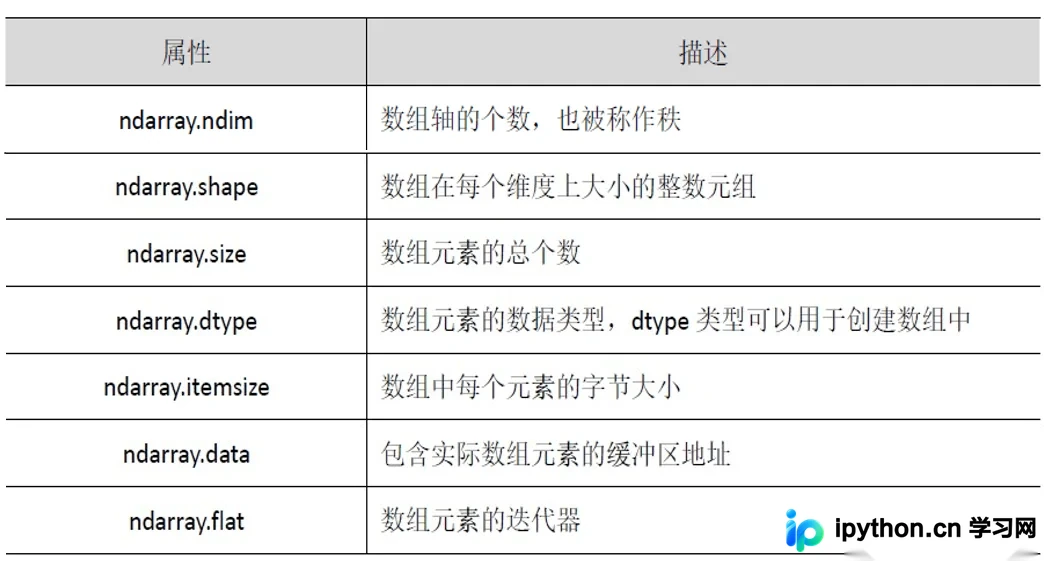
本文详解Python中Numpy库的基础应用,涵盖ndarray多维数组的创建、核心属性(ndim、shape、dtype等)解析,以及array、arange、zeros等常用创建函数的用法。同时介绍数组的索引与切片技巧,帮助读者快速掌握Numpy在数据分析中的关键操作。
本文介绍Python数据分析的核心工具链。首先讲解Jupyter Notebook的基本操作与帮助获取方法;随后深入NumPy数组的创建、索引及形状变换;接着详解SciPy稀疏矩阵(CSR/LIL)在机器学习中的高效存储与格式转换;最后演示Matplotlib在Jupyter中的内联绘图及多种图表类型,为机器学习预处理提供基础支持。
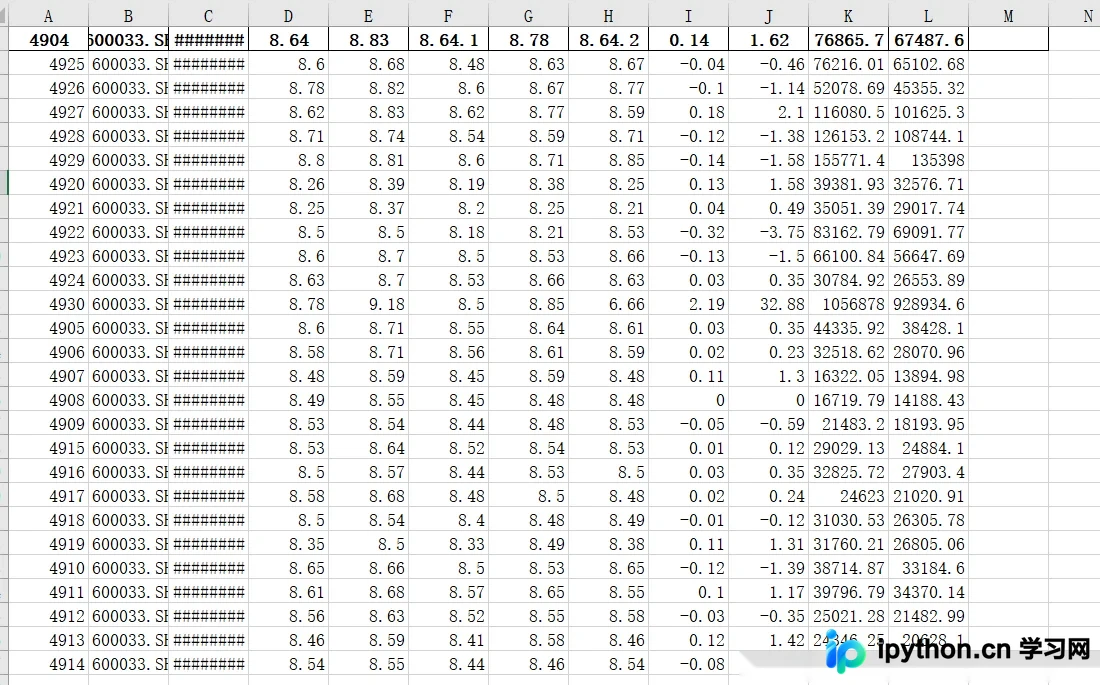
本文总结了pandas中创建DataFrame的三种主要方式:通过列表或数组、通过字典参数以及直接读取Excel和CSV文件。文章详细讲解了各方法的代码实现与参数设置,并指出实际工作中直接读取数据文件是最高效且常用的做法,适合初学者快速掌握数据框构建技巧。
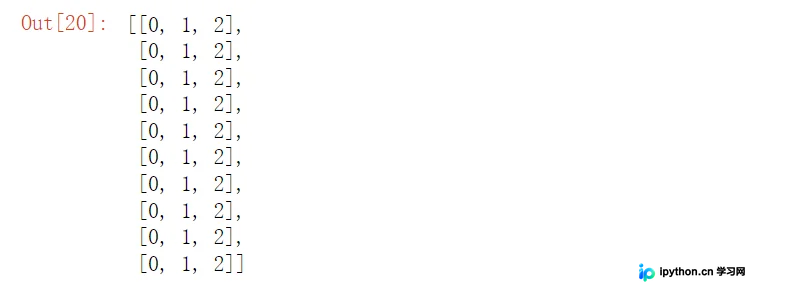
本文深入解析Python Pandas库中loc和iloc两个核心索引函数的区别。loc基于标签(Label)进行数据选取,支持切片包含右边界;iloc基于整数位置(Position)进行索引,遵循左闭右开原则。通过具体代码示例对比两者在行列选取时的不同表现,帮助开发者准确掌握数据筛选技巧。
本文介绍利用Pandas库实现Excel文件的批量拆分与合并操作。通过iloc方法将大文件按行数均分保存,结合os模块遍历读取子文件并添加来源标记,最终使用pd.concat合并为单一Excel。
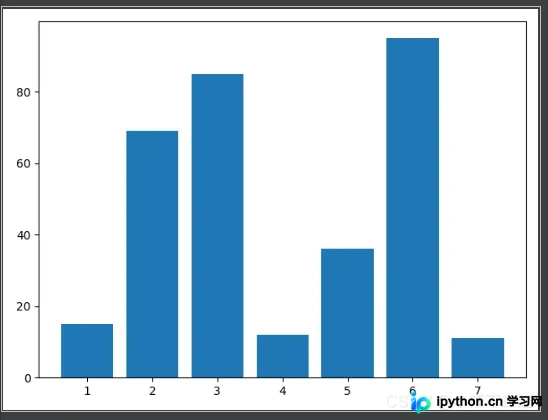
本文详细介绍Python中matplotlib库的核心绘图函数。涵盖bar()绘制柱形图、barh()绘制条形图、plot()绘制折线图及pie()绘制饼图与圆环图。重点解析width、color、linewidth、marker、explode等关键参数的用法,帮助读者快速掌握基础图表绘制技巧。
本文详细介绍如何使用Python pandas库计算数据的方差和标准差。内容涵盖对全表、单独行列以及多行列的操作方法,通过具体代码示例展示df.var()和df.std()函数的用法及axis参数的影响,帮助开发者快速掌握统计计算技巧。
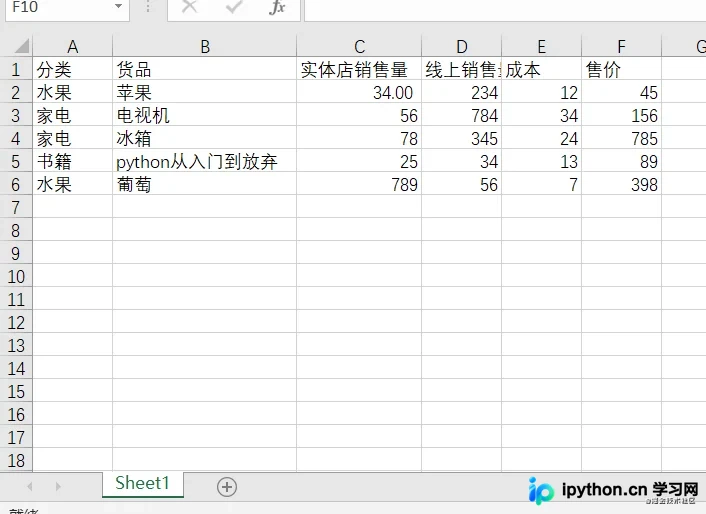
本文深入解析 Pandas 中的 GroupBy 操作,涵盖数据分割、聚合、转换与过滤四大核心环节。详细讲解如何按单列或多列分组,处理 NaN 值,利用 as_index 控制索引,以及应用 sum、mean 等通用聚合函数。此外,还介绍了 NamedAgg 的精准定义、transform 数据转换技巧及 apply 灵活操作,助力高效数据分析。
本文详细介绍Pandas中read_sql函数的用法,涵盖将SQL查询或数据库表读取为DataFrame的基本操作。重点解析params参数的两种传递方式:列表与字典,并结合SQLAlchemy连接PostgreSQL数据库,通过具体代码示例展示如何安全高效地传递查询参数,避免SQL注入风险。