

Pandas DataFrame重排与旋转:pivot、stack、melt及交叉表详解
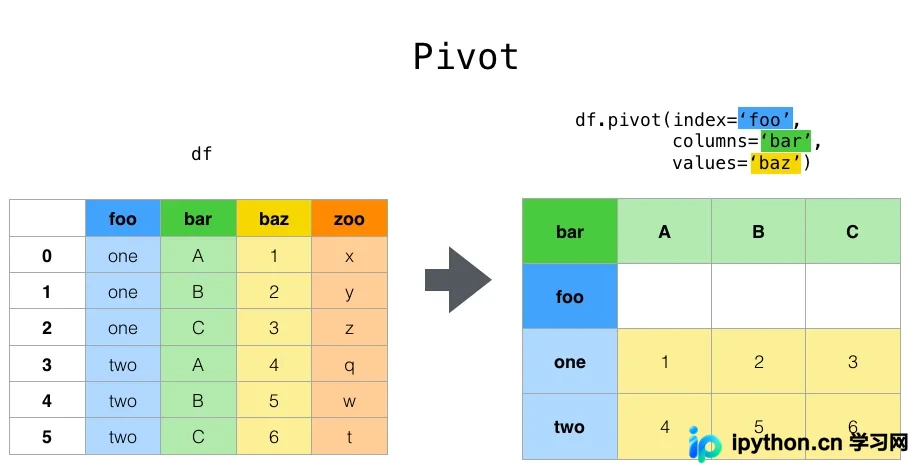
本文深入解析Pandas中DataFrame的重排与旋转技术。详细讲解pivot函数的索引、列及值重组机制,对比stack与unstack在层级索引转换中的反向操作,阐述melt将宽表转为长表的标志变量用法,并介绍pivot_table聚合统计、crosstab交叉计数及get_dummies独热编码的具体实现与参数配置。
2026-10-14
7

本文深入解析Pandas中DataFrame的重排与旋转技术。详细讲解pivot函数的索引、列及值重组机制,对比stack与unstack在层级索引转换中的反向操作,阐述melt将宽表转为长表的标志变量用法,并介绍pivot_table聚合统计、crosstab交叉计数及get_dummies独热编码的具体实现与参数配置。
本文详解如何使用Python爬取《哆啦A梦:伴我同行2》的豆瓣短评,并通过jieba库进行中文分词、去停用词处理,最终利用wordcloud库生成可视化词云图。教程涵盖requests请求、正则解析、词典动态调整及词频统计等核心步骤,适合爬虫初学者练手。
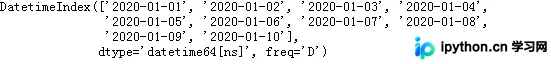
本文详解Python中处理日期数据的三种核心方法:利用pd.date_range生成指定频率的日期序列,通过pd.to_datetime快速将字符串列转换为datetime64类型,以及使用strftime和切片提取年月日等时间成分。涵盖频率设置、批量转换及格式符号对照,适用于数据清洗与时间序列分析场景。
本文详细介绍NumPy中ndarray多维数组的核心操作。涵盖从随机生成、列表转换到使用zeros、empty和arange创建数组的方法;解析shape、ndim、dtype等关键属性;演示类型转换与截断机制;深入讲解数组数学运算、基础切片、布尔索引及花式索引(Fancy indexing)的高级用法,并介绍reshape、transpose和swapaxes等数组变换技巧,助力高效进行数据分析。
本文针对500万行级别的大规模数据,系统对比了Pandas中iloc、at、apply及Series直接处理的速度差异。实测显示,iloc耗时约5小时,at优化至10分钟,而转为Series处理仅需37秒。此外,文章通过数值实验深入剖析了loc、at、iloc、iat及直接访问values数组在读取与修改场景下的性能表现,指出直接获取二维数组再定位是最高效方案,并提供了相应的代码实现与优化建议。
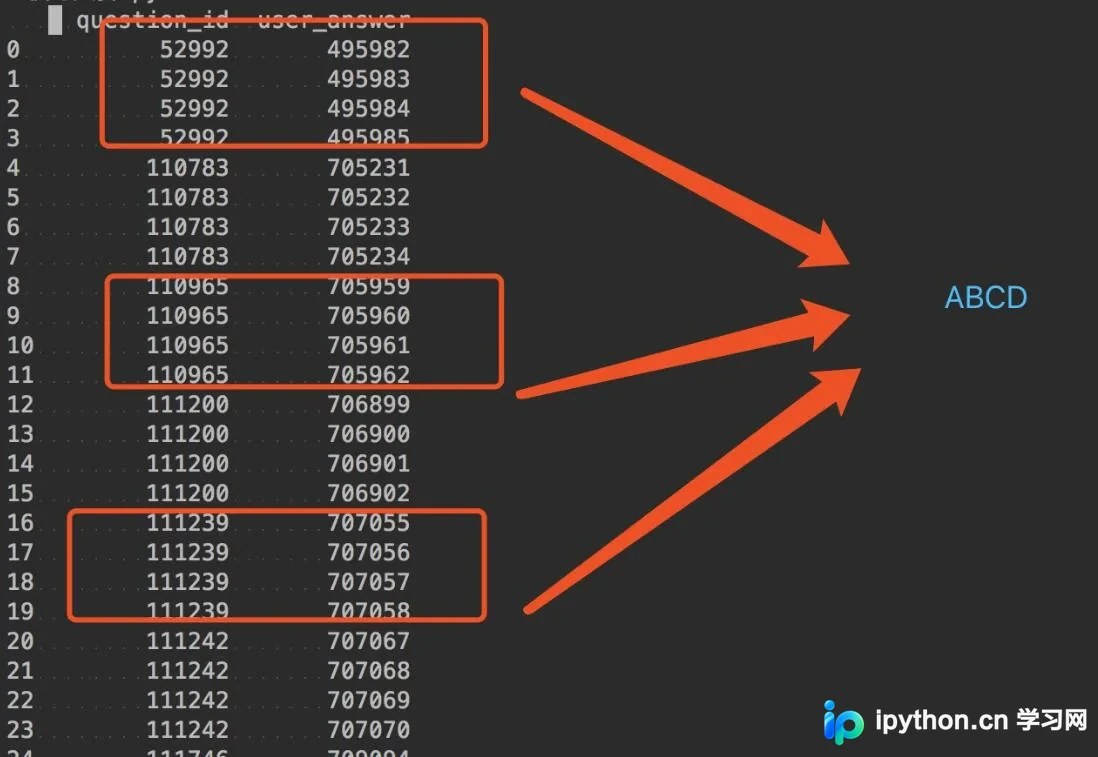
本文介绍如何利用pandas实现分组后提取第N行数据,并通过示例将question_id对应的user_answer转换为ABCD选项。同时详细解析nlargest()函数的用法,包括获取最大前几行、处理重复值及分组求和等场景,帮助读者掌握高效的数据筛选技巧。
本文介绍如何使用Python pandas库进行分组排序并获取组内第二大或最大的数据。通过groupby结合apply函数,可自定义逻辑提取特定排名数值;对于按列排序后取最大行的需求,可利用sort_values配合groupby的first或head方法实现高效数据筛选。
本文介绍如何使用pandas的concat函数在纵向拼接多个DataFrame时忽略原有索引。通过设置ignore_index=True参数,可生成连续的新索引,避免NaN值。同时涵盖横向拼接的axis=1用法,帮助处理不同列名的数据合并问题。
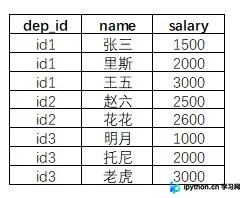
本文介绍如何在pandas中实现类似SQL row_number()的组内排序与排名功能。通过groupby结合rank或apply排序方法,可为DataFrame指定列按分组添加序号。示例涵盖薪资与班级得分场景,提供多种实现代码及注意事项,帮助开发者高效处理分组数据。
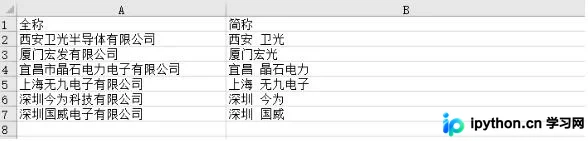
本文介绍如何利用Python的Pandas库处理包含数万条记录的Excel文件,自动根据预设的供应商全称与简称对应关系填充数据。通过构建字典映射并遍历数据列,实现批量填写简称的功能。文章同时探讨了字符串匹配中因括号、空格等细微差异导致的匹配失败问题,为后续优化提供思路。
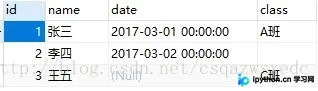
本文详解Python向MySQL插入NULL值的方法,区分%s占位符加不加引号的差异。深入对比数据库中NULL与空字符的区别,以及Python中None、Pandas中NaN与数据库NULL的对应关系,帮助开发者避免数据读取与写入时的类型错误。
本文介绍在 Pandas 中快速筛选包含特定字符列的三种常用方法:利用 if 判断结合列表推导式、使用 str.contains 配合列表解析,以及调用 DataFrame 的 filter 函数。重点解析 filter 函数的 like、regex 和 item 参数,展示如何结合行与列条件进行精准数据提取,并提供完整代码示例供参考。