Python处理CSV、Excel、TXT及DAT文件的完整指南
本文详解Python处理CSV、Excel、TXT及DAT文件的方法。涵盖csv库与pandas读取写入技巧,对比xlrd与pandas在Excel处理上的差异,演示TXT逐行读取与DAT格式转换。通过代码示例解析数据提取、列表转换及自动化参数化应用,帮助开发者高效处理各类数据文件。
2026-10-13
6

本文详解Python处理CSV、Excel、TXT及DAT文件的方法。涵盖csv库与pandas读取写入技巧,对比xlrd与pandas在Excel处理上的差异,演示TXT逐行读取与DAT格式转换。通过代码示例解析数据提取、列表转换及自动化参数化应用,帮助开发者高效处理各类数据文件。
本文介绍在Python数据分析中使用matplotlib库绘制多个子图时,如何有效调整子图间距。通过plt.subplot定义子图位置,并配合plt.tight_layout()自动优化布局,解决子图重叠问题。文章提供三种典型场景的代码示例,包括基础双行布局、5x5网格及10x10大图展示,帮助开发者快速掌握子图排版技巧。
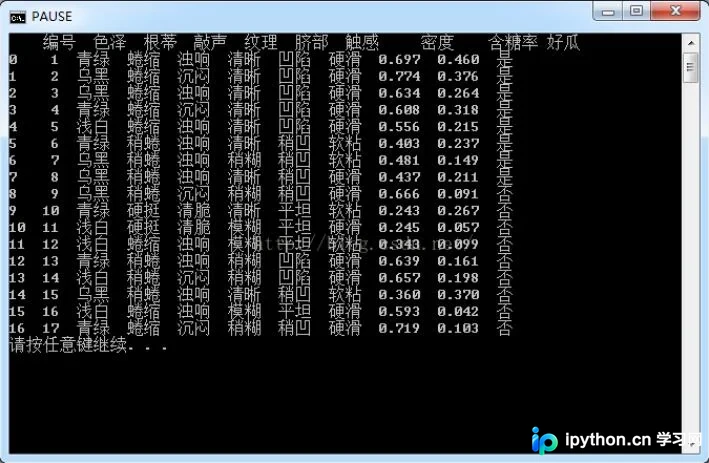
本文介绍如何利用pandas库直接读取包含中文字符的CSV数据集,避免手动批量替换清理数据的繁琐过程。通过示例演示如何加载数据、按行号选取数据、提取指定列以及获取特定单元格值,为处理类似西瓜书等包含中文标签的数据集提供简洁方案。
本文介绍如何使用Python的Pandas库结合SQLAlchemy和cx_Oracle驱动,从Oracle数据库中获取数据并转换为DataFrame对象。通过具体代码示例,展示了数据库连接、SQL查询执行及数据加载的全过程,为数据处理提供实用参考。
Python 3.x 已不再支持 MySQLdb,推荐使用 PyMySQL 库进行数据库交互。本文介绍了通过 pip3 install PyMySQL 安装库的方法,并展示了利用 pymysql 建立连接、执行 SQL 查询并将结果转换为 Pandas DataFrame 的完整代码示例,解决 No module named 'MySQLdb' 报错问题。
本文详细介绍pandas中Series和DataFrame的唯一值判断、值计数统计以及成员资格判定方法。通过is_unique获取唯一性,利用value_counts统计频次,并使用isin进行子集筛选与填充操作,提供完整代码示例供参考。
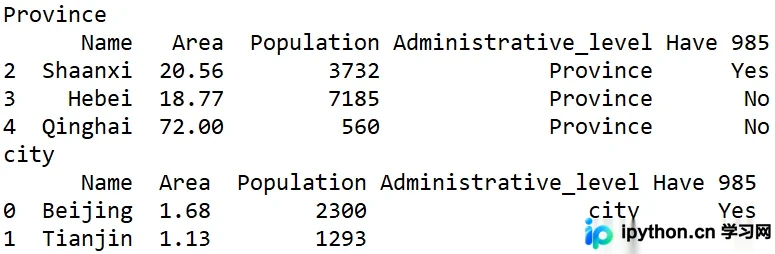
本文介绍Python中pandas库DataFrame的groupby分组功能。通过创建包含行政级别和985高校信息的示例数据,演示如何按单个属性(行政级别)及多个属性(行政级别与是否有985高校)进行分组聚合。代码展示了groupby的基本用法及结果输出,帮助开发者掌握数据分组的核心操作。
在使用pandas读取CSV文件时,常因索引列处理不当出现“Unnamed: 0”列。本文介绍利用列索引重命名或drop方法处理此类冗余列的技巧,并汇总了DataFrame选取行与列的多种常用方法,包括切片、索引器及特定行/列获取函数,帮助提升数据处理效率。
本文深入解析 Python 中日期与时间数据的处理机制,涵盖 datetime 模块基础、字符串与日期互转方法及 Pandas 的 to_datetime 应用。重点讲解以时间戳为索引的 Series 和 DataFrame 的构建、算术对齐、高级切片技巧,以及针对重复时间索引数据的聚合处理方案,助力高效进行时间序列数据分析。
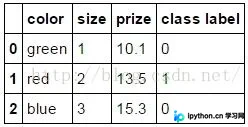
本文详解Python中离散变量One-Hot编码的两种主流实现方式。通过对比pandas的get_dummies与sklearn的LabelEncoder结合OneHotEncoder,解析字符串与数值型变量的处理差异。文章包含具体代码示例,展示从数据导入、特征查看到编码生成的完整流程,帮助开发者根据数据类型选择合适方案。
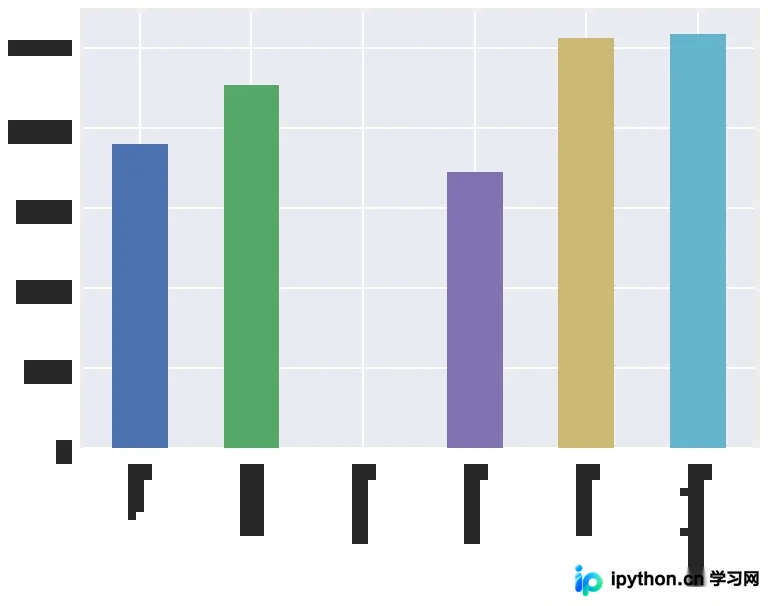
本文介绍如何在pandas中使用groupby进行分组统计后,按照自定义的特定顺序输出结果。通过定义索引列表并应用于groupby对象,可确保数据按期望顺序排列,进而生成符合逻辑的柱状图,便于后续对比分析与绘图展示。
本文介绍在pandas中利用get_dummies函数对离散特征进行one-hot编码的方法。针对无序分类特征如颜色,可直接使用get_dummies生成独热向量;针对有序特征如尺码,则建议先通过字典映射转换为数值。文章提供了具体的DataFrame构建、映射及编码代码示例,帮助开发者高效完成数据预处理。