Python数据分析实战:从数据清洗到建模分析全流程指南
本文详细介绍基于Python的数据分析与建模流程。内容涵盖数据读取、空值与异常值处理(删除、填充、四分位数法)、静态结构分析、数据分区间及对比分析等核心步骤。通过具体代码示例,帮助读者掌握使用Pandas和Numpy进行高效数据预处理与特征工程的方法,适用于实际业务场景中的数据科学实践。
2026-10-13
6


本文详细介绍基于Python的数据分析与建模流程。内容涵盖数据读取、空值与异常值处理(删除、填充、四分位数法)、静态结构分析、数据分区间及对比分析等核心步骤。通过具体代码示例,帮助读者掌握使用Pandas和Numpy进行高效数据预处理与特征工程的方法,适用于实际业务场景中的数据科学实践。
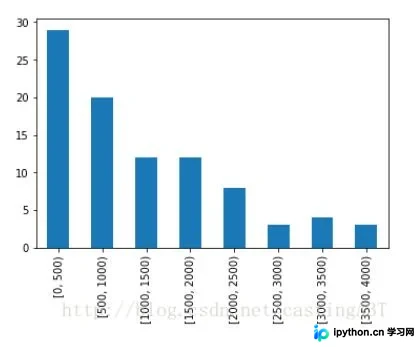
本文通过具体代码示例,演示如何利用pandas库对销售数据进行区间划分(分箱)并计算各区间频率。主要涉及pd.cut函数的区间设置、value_counts统计频数,以及通过DataFrame操作计算频率百分比与累计频率,最终结合matplotlib生成条形图可视化结果。
本文详细介绍Python中pandas库的安装方法及核心数据结构。通过pip命令快速安装pandas后,深入解析Series和DataFrame两种主要数据对象的创建方式。内容涵盖从列表、字典生成Series,利用Matplotlib进行可视化,以及DataFrame的行列索引、数据读取与切片操作,帮助初学者掌握数据处理基础。
本文深入解析Python数据分析的八大核心第三方库。涵盖Pandas的高效数据处理、Numpy的底层数组运算、Matplotlib的可视化绘图,以及SciPy、Scikit-Learn、Keras、Scrapy和Gensim在科学计算、机器学习、爬虫和自然语言处理中的应用,助您构建完整的数据分析技术栈。
本文深入解析Numpy中数组转置的三种方式:transpose函数、T属性及swapaxes轴交换。通过2x2x4及更高维度的具体代码示例,详细展示各元素索引在转置前后的变化规律,帮助开发者理解多维数组内存布局与轴对换机制,掌握高效的数据处理技巧。
本文介绍使用pandas库处理矢量数据时的替换操作。通过Series对象的replace方法,可高效实现单个数值或字典映射的批量替换,避免手动查找数据对象的繁琐步骤。示例展示了整数替换及NaN处理,适用于Python数据分析场景。
本文系统介绍Python中Pandas库DataFrame的核心操作方法。涵盖数据查看、属性获取、行列切片、数据替换、条件筛选(含模糊匹配)、数据转换、读取存储、聚合统计及数据集合并等关键功能。通过Excel读取、排序、去重等具体代码实例,帮助开发者快速掌握数据预处理与清洗技巧。
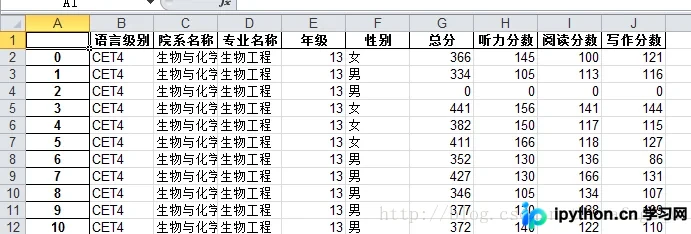
本文基于Python的Pandas和Matplotlib库,对某学校近9000条四六级考试成绩进行清洗与分析。通过数据预处理、分组统计及可视化绘图,展示了各学院平均分、过关人数分布及男女生通过率差异,为教育数据分析提供完整代码示例与结果解读。
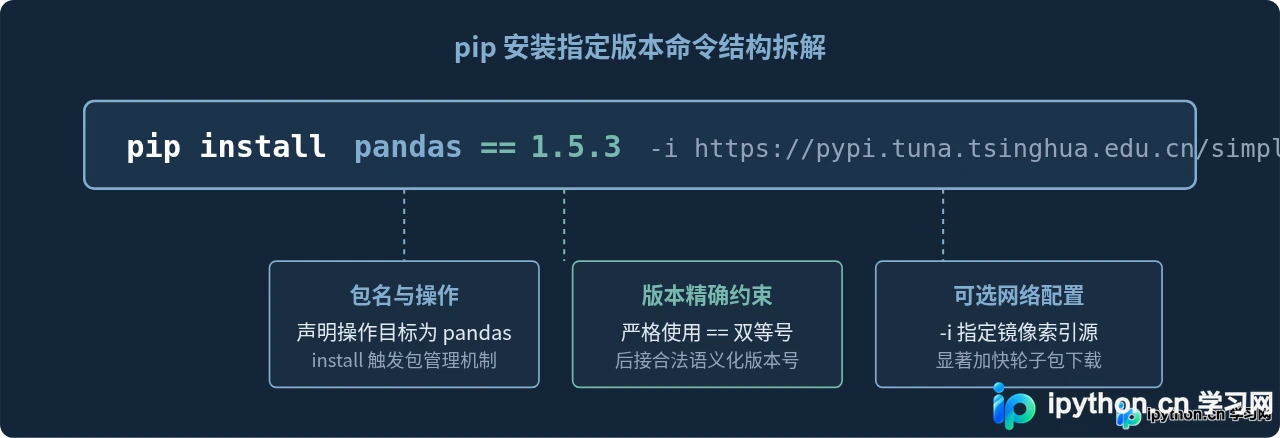
本文详细介绍在Python环境中安装指定版本pandas库的具体命令与操作流程,涵盖pip和conda安装方式、Python版本兼容关系、镜像加速及安装验证方法。
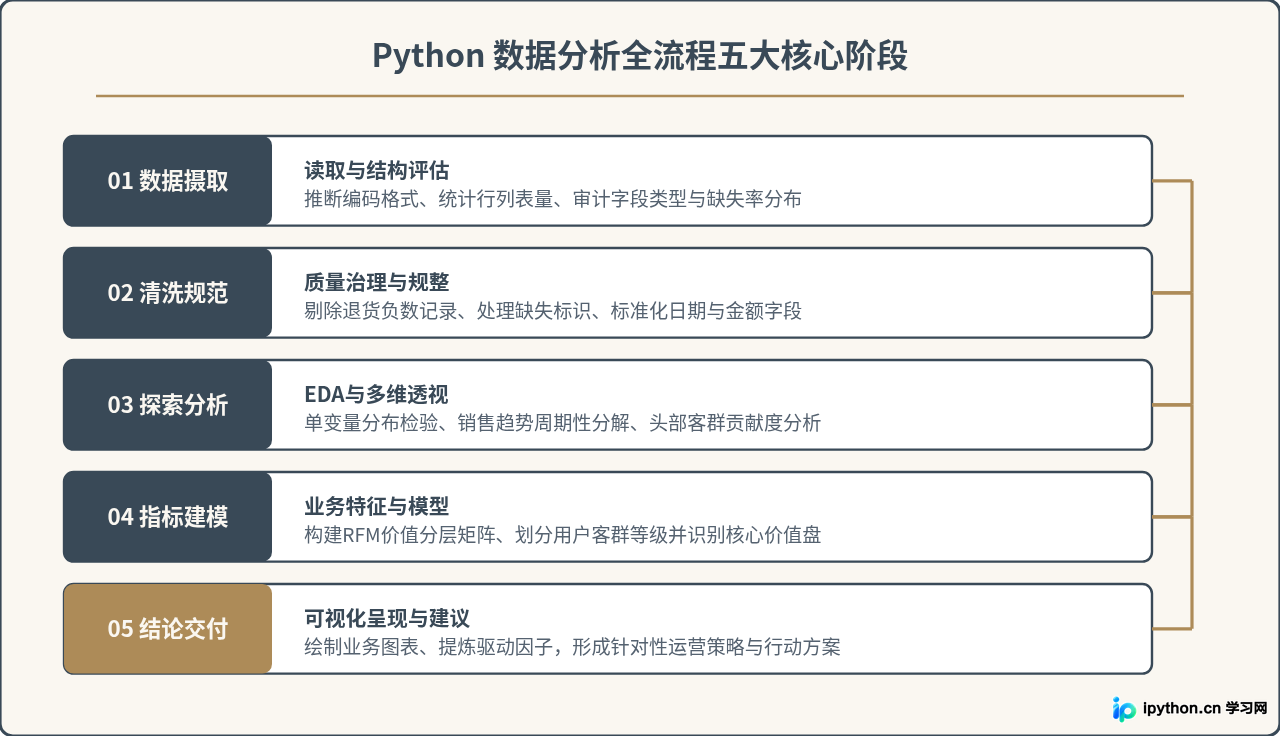
基于真实零售交易数据集,系统实战Python数据分析全流程:涵盖数据读取评估、清洗预处理、探索性数据分析(EDA)、RFM业务特征建模与图表结论落地,提供完整可复现代码与实战避坑要点。
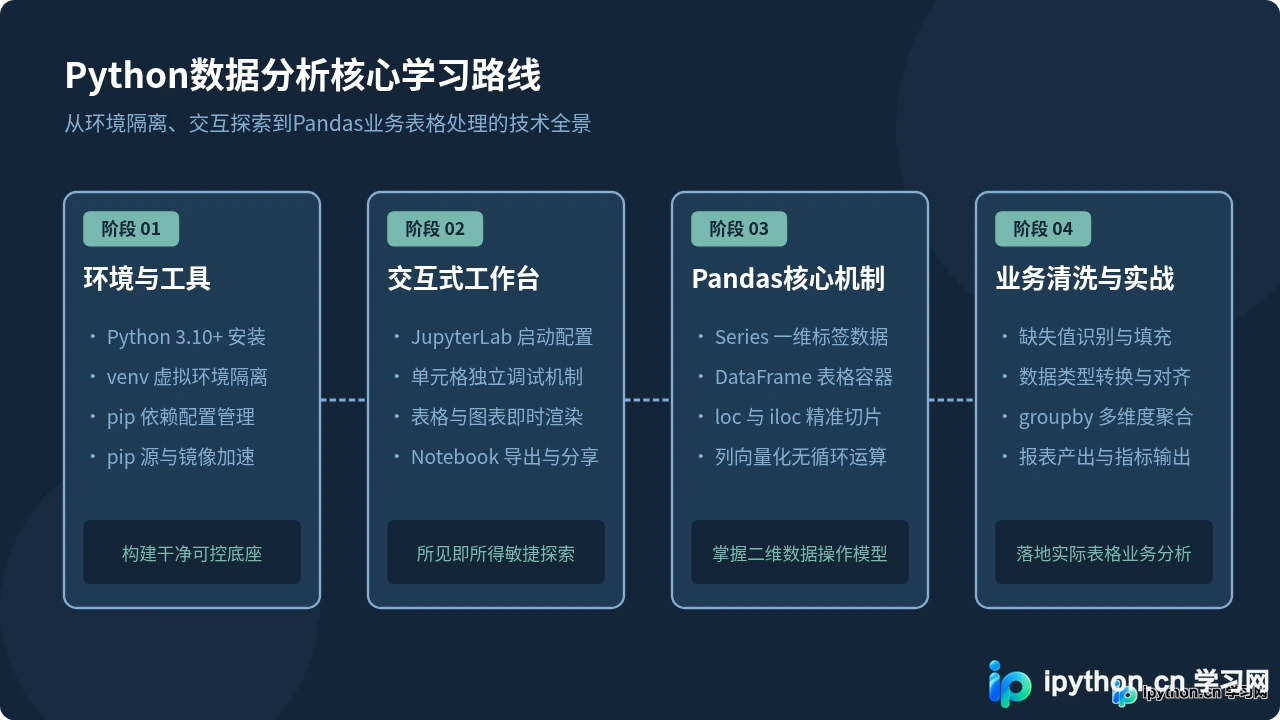
面向新手的Python数据分析实用学习路线,梳理从Python虚拟环境配置、Jupyter交互工具使用,到Pandas核心数据结构、数据清洗与聚合统计实战的完整路径。
本文基于Python的Pandas库,对北京2006至2019年高考录取分数线进行统计分析。通过数据爬取与本地文件读取,利用groupby、max、min及mean等方法,计算文理科最高最低分、一本与二本分数线差值及历年平均分。结合Matplotlib进行可视化展示,为考生填报志愿提供数据支持。