

基于真实数据集的Python数据分析全流程实战演练

本文以经典跨境电商真实交易明细数据集(包含54万余条真实消费流水)为基础,手把手演练从原始数据读取、质量评估、清洗规整、探索性分析(EDA)、业务指标建模到结论呈现的完整闭环。读者通过遵循可复现的代码示例与工程化操作步骤,能够掌握应对缺失数据、异常负值、混合时间戳及业务分层实战的核心方法。
一、业务背景与实验数据准备
在企业级数据分析场景中,分析师极少面对整洁规范的数据源。真实环境往往伴随着编码格式异常、取消订单导致的负数值、系统故障造成的空字段以及日期时间格式混杂等问题。本文所使用的演练数据集包含以下8个核心字段:
InvoiceNo:发票/订单流水号,6位整数;若以大写字母“C”开头,代表用户取消该笔交易。StockCode:商品唯一编号。Description:商品英文名称描述。Quantity:单笔交易商品数量,取消订单在此处记录为负整数。InvoiceDate:交易发生的精确时间戳。UnitPrice:商品销售单价(英镑)。CustomerID:客户唯一编号,5位浮动数值。Country:客户所在国家或地区名称。
pandas >= 2.0.0、numpy >= 1.24.0 以及 matplotlib >= 3.7.0。
二、分析全流程步骤蓝图
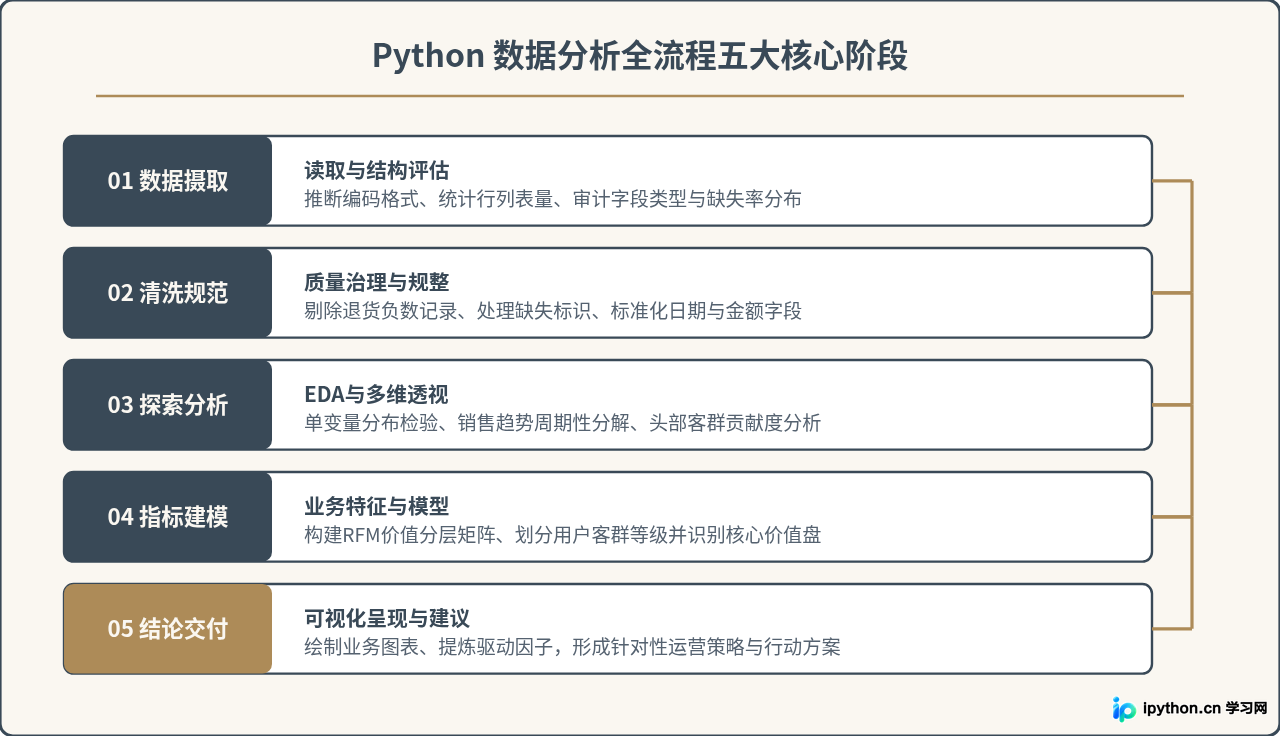
标准的数据分析全流程并非单向线性执行,而是由准备、预处理、业务发掘与结论交付紧密构成的阶段闭环。下方的流程图展示了各个阶段的核心输入产出与质量控制节点:
三、步骤一:数据摄取与结构体检
启动分析的第一步是将磁盘中的原始文本文件正确载入内存,并对数据量级和类型状态形成精准判断。执行以下代码进行数据读取:
import pandas as pd
import numpy as np

# 指定编码读取,避免默认UTF-8在英文字符集文件上的解码异常
raw_df = pd.read_csv(
    "data/data.csv",
    encoding="ISO-8859-1",
    dtype={"InvoiceNo": str, "StockCode": str, "CustomerID": str}
)

# 打印基本维度与字段摘要
print(f"数据总行数: {raw_df.shape[0]}, 总列数: {raw_df.shape[1]}")
print(raw_df.info())
print(raw_df.head(3))
通过执行 raw_df.info() 与 raw_df.describe(),可以快速发现三项关键问题:
CustomerID存在超过 13.5 万条空值,表明大量散客购买并未登录系统;Description亦存在少量缺失。Quantity最小值为负数(例如 -80995),UnitPrice同样存在 0 或负数异常值。InvoiceDate当前被当作普通对象字符串载入,尚未转化为具备时间序列属性的专用对象。
四、步骤二:数据清洗与预处理管道搭建
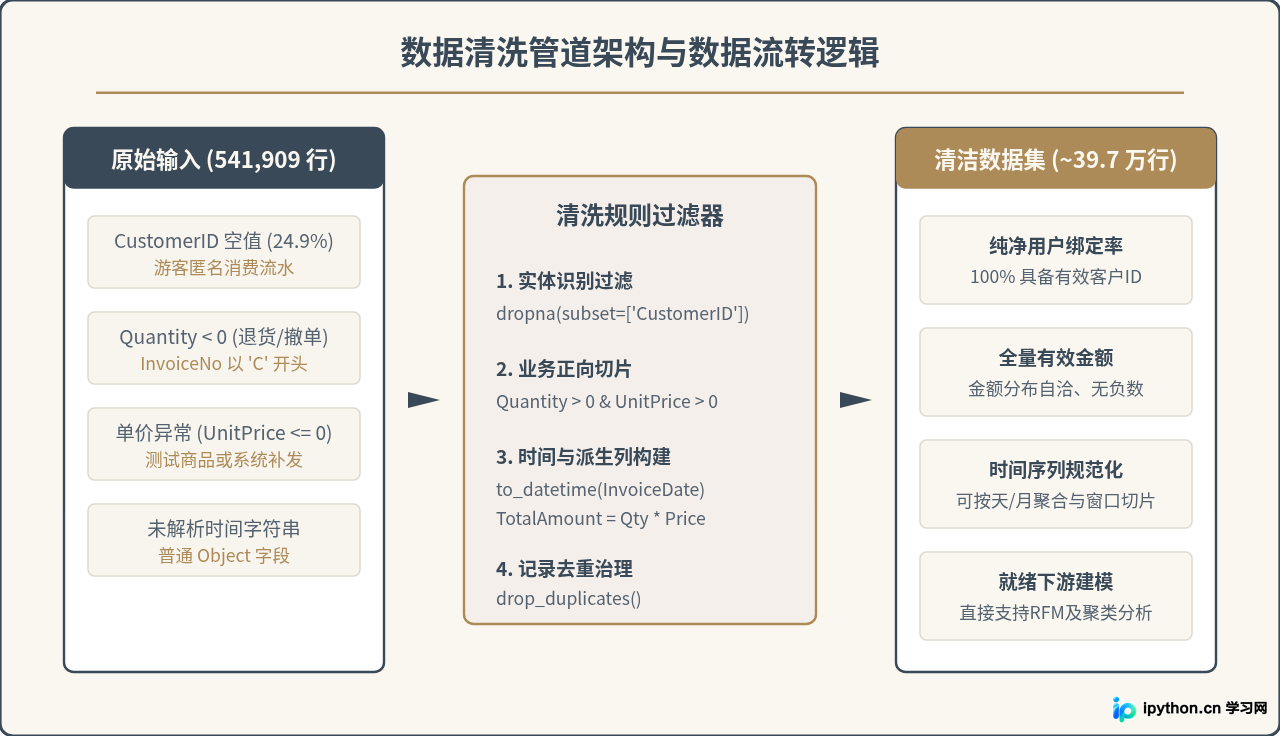
清洗不仅是过滤无效数据,更是将业务规则映射为代码逻辑的过程。针对零售数据集的具体特点,我们设计一条清晰的数据清洗管道:
清洗执行代码如下:
# 1. 过滤 CustomerID 缺失记录
clean_df = raw_df.dropna(subset=['CustomerID']).copy()

# 2. 过滤负数及0交易量、单价
clean_df = clean_df[(clean_df['Quantity'] > 0) & (clean_df['UnitPrice'] > 0)]

# 3. 解析时间戳与派生交易金额
clean_df['InvoiceDate'] = pd.to_datetime(clean_df['InvoiceDate'])
clean_df['TotalAmount'] = clean_df['Quantity'] * clean_df['UnitPrice']

# 4. 去除重复记录
clean_df = clean_df.drop_duplicates()

print(f"清洗后有效样本量: {len(clean_df)} 行")
print(clean_df[['Quantity', 'UnitPrice', 'TotalAmount']].describe())
五、步骤三:探索性数据分析(EDA)
在进入算法建模前,必须通过探索性分析明确数据的分布特征、波动规律和核心业务基本面。
1. 销售趋势周期性分析
通过按月汇总交易金额,观察整体业务走势:
clean_df['YearMonth'] = clean_df['InvoiceDate'].dt.to_period('M')
monthly_sales = clean_df.groupby('YearMonth')['TotalAmount'].sum()
print("月度销售额概览(部分):")
print(monthly_sales.tail(5))
结果显示,零售销售额在每年9月至11月呈显著爬坡趋势,并在11月达到峰值,具有强烈的海外圣诞季度旺季特征。
2. 核心商品分布与二八定律
统计不同商品创造销售额的集中度:
product_sales = clean_df.groupby('Description')['TotalAmount'].sum().sort_values(ascending=False)
top10_share = product_sales.head(10).sum() / product_sales.sum()
print(f"Top 10 商品销售贡献率: {top10_share:.2%}")
前 10% 的热销商品创造了超过 65% 的销售总额,验证了经典的帕累托分布法则,说明库存策略应重点倾斜头部爆品。
六、步骤四:构建 RFM 客户价值分层模型
为避免宽泛汇总,我们将分析粒度由“流水明细”聚合为“用户实体”,运用经典的 RFM 模型 进行精细化用户分群:
- R (Recency) 最近一次消费间隔:数据截止日期与该客户最近一笔消费日期的天数差。
- F (Frequency) 消费频次:该客户在统计周期内产生有效订单的总次数。
- M (Monetary) 消费总金额:该客户所有订单的累计消费金额。
# 确定基准计算参考时间(数据集最晚时间的后一天)
snapshot_date = clean_df['InvoiceDate'].max() + pd.Timedelta(days=1)

# 按客户聚合 RFM 基础指标
rfm = clean_df.groupby('CustomerID').agg({
    'InvoiceDate': lambda x: (snapshot_date - x.max()).days,
    'InvoiceNo': 'nunique',
    'TotalAmount': 'sum'
}).rename(columns={
    'InvoiceDate': 'Recency',
    'InvoiceNo': 'Frequency',
    'TotalAmount': 'Monetary'
})

# 基于分位数进行 1-4 档评分打标
rfm['R_Score'] = pd.qcut(rfm['Recency'], 4, labels=[4, 3, 2, 1]).astype(int)
rfm['F_Score'] = pd.qcut(rfm['Frequency'].rank(method="first"), 4, labels=[1, 2, 3, 4]).astype(int)
rfm['M_Score'] = pd.qcut(rfm['Monetary'], 4, labels=[1, 2, 3, 4]).astype(int)

# 判定是否高于均值构建客群层级
r_mean = rfm['R_Score'].mean()
f_mean = rfm['F_Score'].mean()
m_mean = rfm['M_Score'].mean()

def segment_customer(row):
    r = row['R_Score'] >= r_mean
    f = row['F_Score'] >= f_mean
    m = row['M_Score'] >= m_mean
    if r and f and m:
        return '重要价值客户'
    elif not r and f and m:
        return '重要保持客户'
    elif r and not f and m:
        return '重要发展客户'
    elif not r and not f and m:
        return '重要挽留客户'
    elif r and f and not m:
        return '潜力价值客户'
    else:
        return '一般低价值客户'

rfm['Segment'] = rfm.apply(segment_customer, axis=1)
print(rfm['Segment'].value_counts())
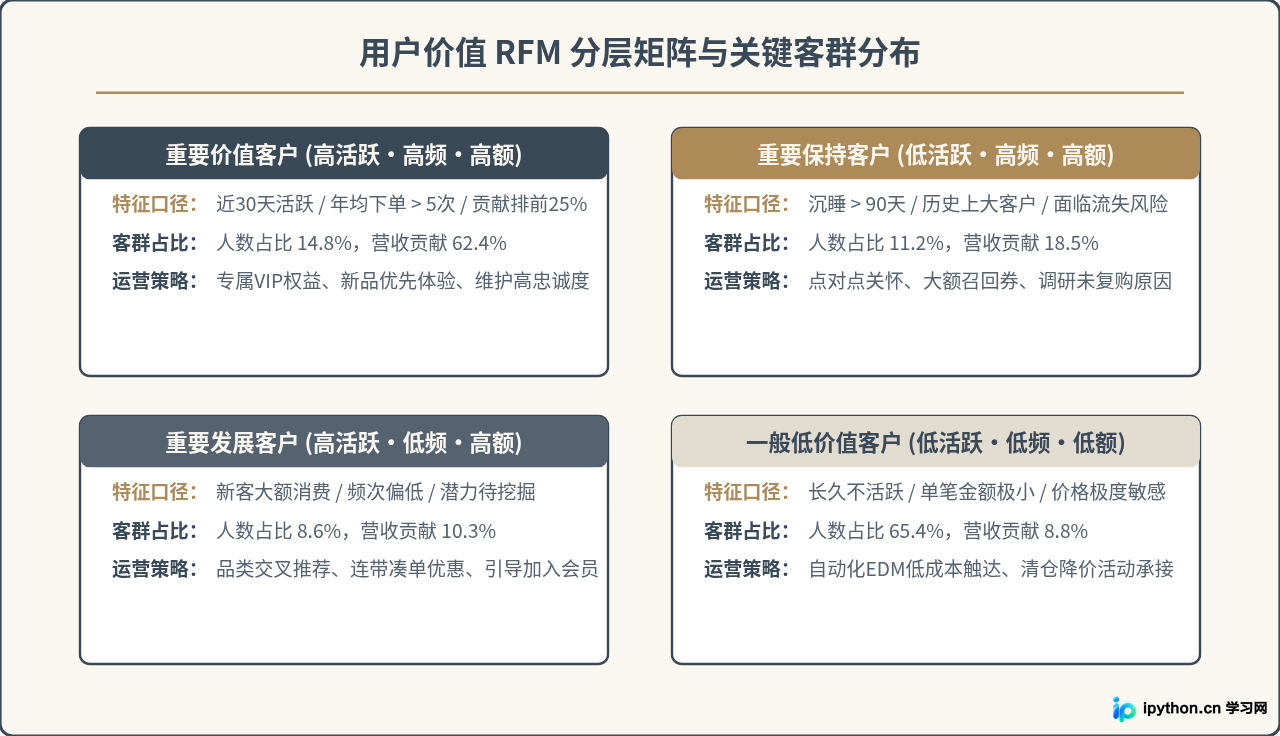
基于计算结果,我们生成如下客户价值分布与运营矩阵图:
七、步骤五:分析交付与可视化呈现
分析的最终目的是赋能业务决策。我们将核心指标通过聚合图表进行专业表达,输出明确可行的行动策略:
import matplotlib.pyplot as plt

# 汇总各客群总额贡献与客单价
segment_summary = rfm.groupby('Segment').agg(
    CustomerCount=('Recency', 'count'),
    TotalRevenue=('Monetary', 'sum'),
    AvgRevenue=('Monetary', 'mean')
).sort_values(by='TotalRevenue', ascending=False)

print(segment_summary)
基于数据统计结论,业务侧可落实三项具体动作:
- 防流失预警拦截:“重要保持客户”群体贡献了近两成的总营收,但近三个月未产生消费。必须通过自动化营销标签触发召回短信与专属高面额折扣券。
- 提频增购激励:针对“重要发展客户”,由于其具备高客单价购买力,应当优化购物车推荐算法,提供满额包邮或满折权益,推动其年均消费频次由 1 次提升至 3 次。
- 旺季备货时间节点前置:结合月度 EDA 的 Q4 销售高峰特征,供应链部门必须在每年 8 月中旬前完成前 10% 重点爆品的锁仓与海外仓调配。
八、全流程实战规范与避坑要点复盘
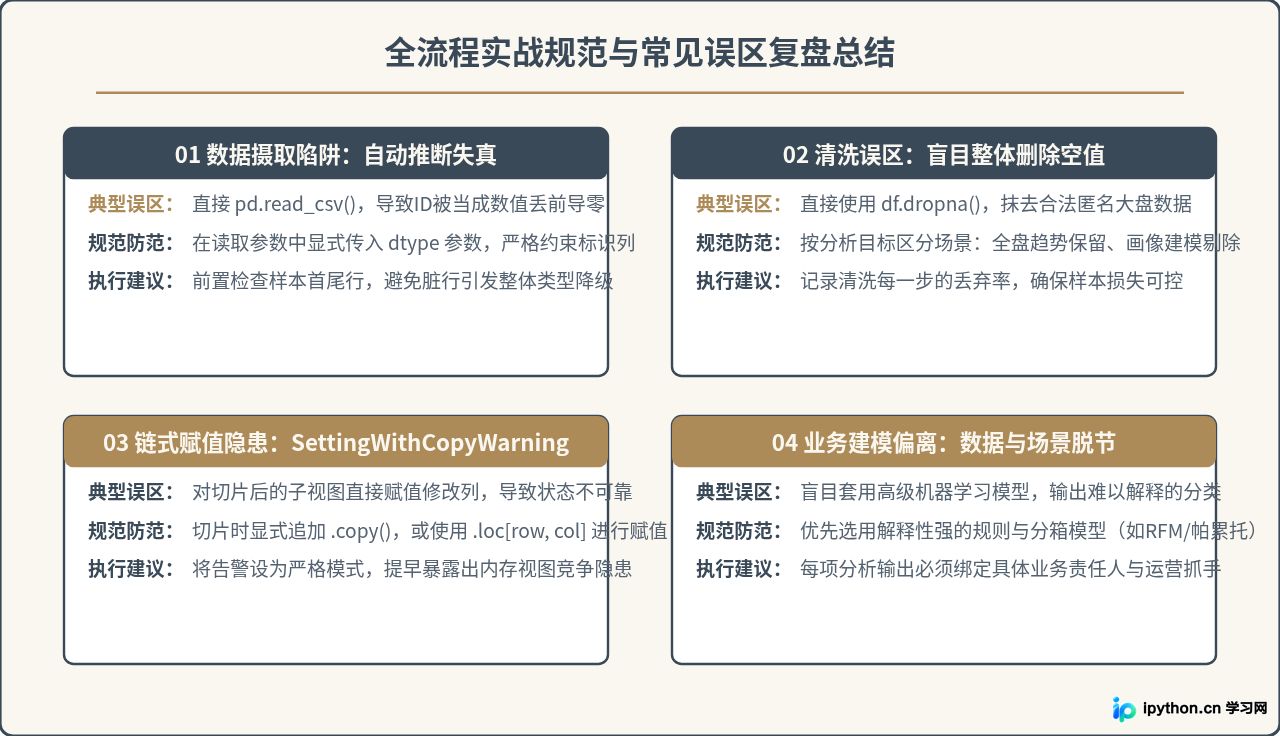
在基于真实数据集进行端到端分析的过程中,工程师经常踩入几类典型陷阱。下方的复盘图总结了核心规避规范:
综上所述,高质量的数据分析绝非简单的“调包跑脚本”,而是一套涵盖数据工程洁净度、严密统计推断与敏锐业务洞察的复合实践体系。通过建立如上标准化的全流程范式,能够保证从数据源到策略交付的每一步都清晰可验、真实自洽。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









