Pandas DataFrame 基础操作与数据处理实战
本文详细介绍Pandas中DataFrame的核心用法,涵盖从创建、索引选取、行列删除到数学运算与Groupby聚合的完整流程。通过具体代码示例,解析如何处理多维数据、执行映射与聚合操作,并演示导出CSV文件的注意事项,助力高效进行Python数据分析。
2026-10-15
5


本文详细介绍Pandas中DataFrame的核心用法,涵盖从创建、索引选取、行列删除到数学运算与Groupby聚合的完整流程。通过具体代码示例,解析如何处理多维数据、执行映射与聚合操作,并演示导出CSV文件的注意事项,助力高效进行Python数据分析。
本文深入解析Python Pandas库中read_sql_query函数的使用方法。详细说明了如何将SQL查询结果高效转换为DataFrame,并逐一解读sql、con、index_col、coerce_float、params及parse_dates等关键参数的配置技巧。结合MySQL连接实例,展示如何安全传递参数并处理日期格式,帮助开发者快速掌握数据库交互与数据清洗的核心技能。
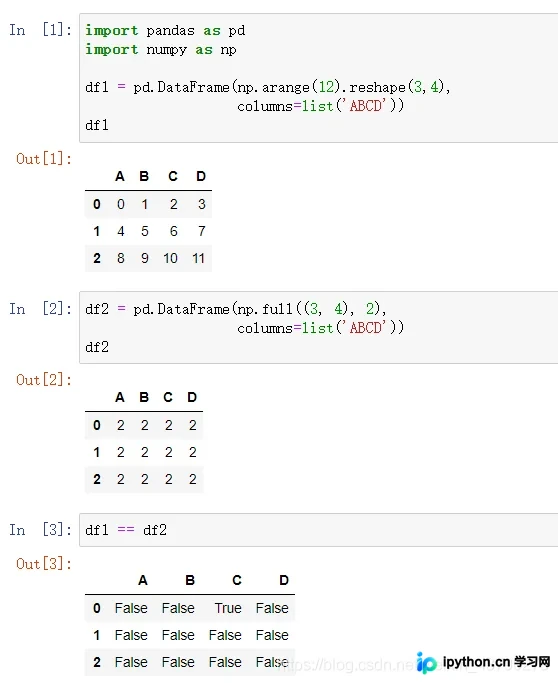
本文详细介绍Python中pandas库的比较操作,涵盖比较运算符与比较方法的使用场景。通过对比两个DataFrame、Series以及标量数据的比较方式,解析索引对齐、形状匹配及数据类型限制等关键细节,帮助开发者高效处理数据比对任务。
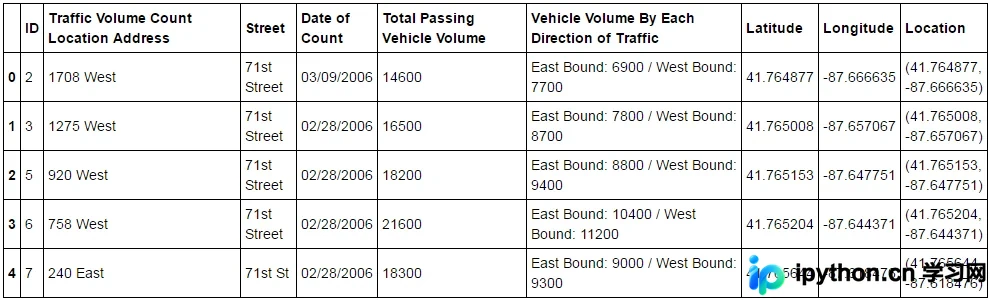
本文详细介绍Python中Pandas库的核心功能,涵盖Series一维数据与DataFrame二维表格的创建与操作。内容包含安装导入、数据选择切片、缺失值处理、统计函数应用、数据合并及时间序列重采样等关键操作,帮助开发者快速掌握科学计算基础。
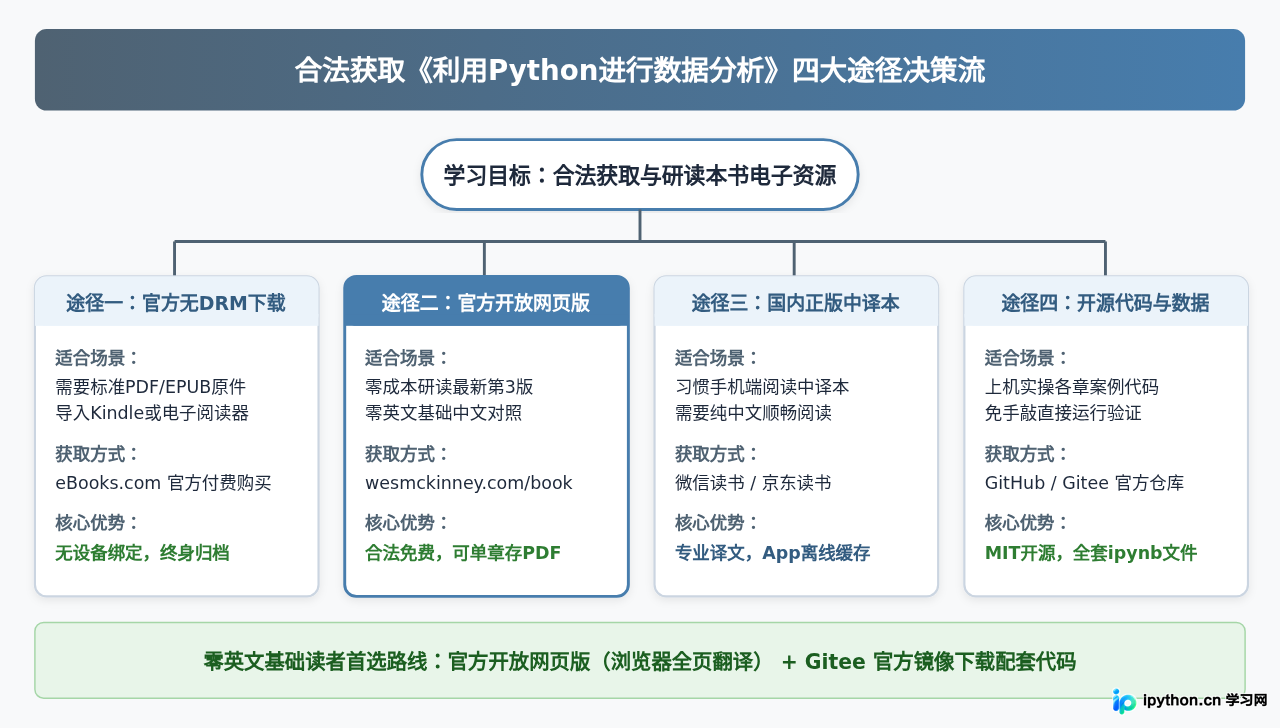
详细介绍合法获取与下载《利用Python进行数据分析》电子书PDF与EPUB的四大正规途径,包括官方DRM-Free文件下载、作者开放网页版中文化阅读与离线单章导出、国内平台正版中译本以及开源配套代码下载,面向零英文基础读者提供完整指引。
深入解答Python数据分析的掌握程度标准,梳理Pandas在结构化数据清洗、多表合并、分组聚合与数据可视化领域的实战规范与自测清单。
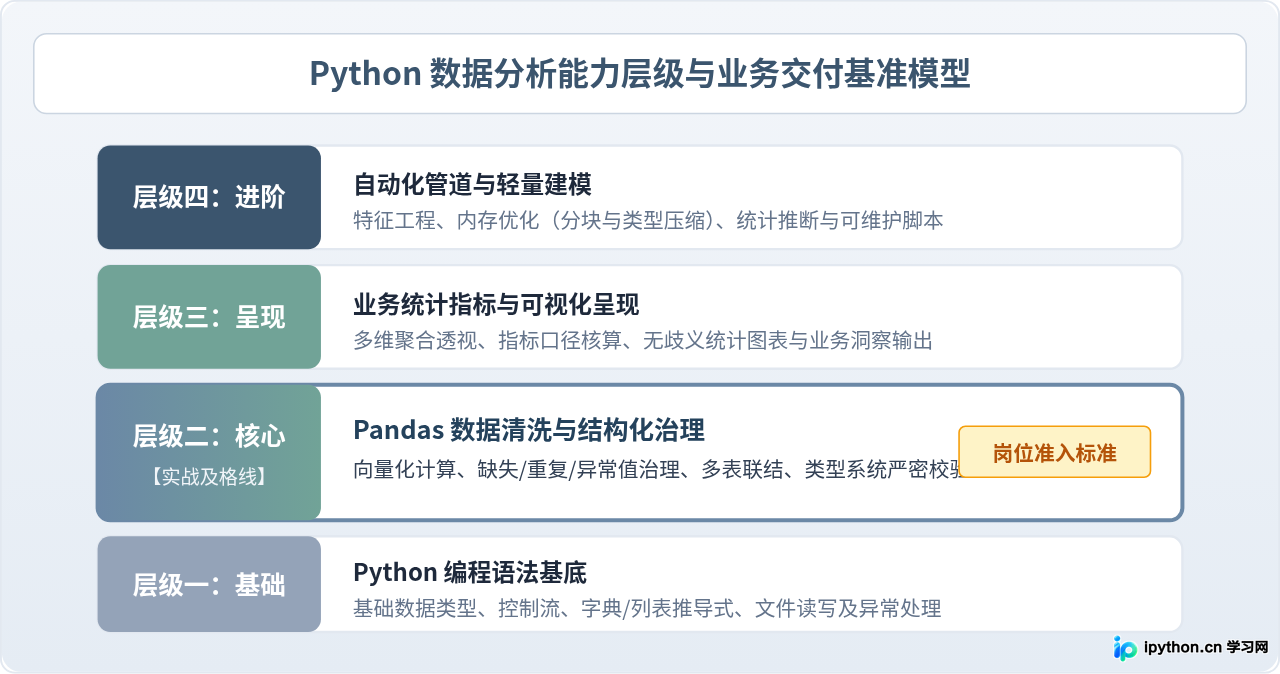
本文详细介绍在Windows、macOS和Linux操作系统下使用pip安装pandas数据分析库的完整方法,涵盖环境检查、虚拟环境隔离、镜像源加速与常见报错排查。
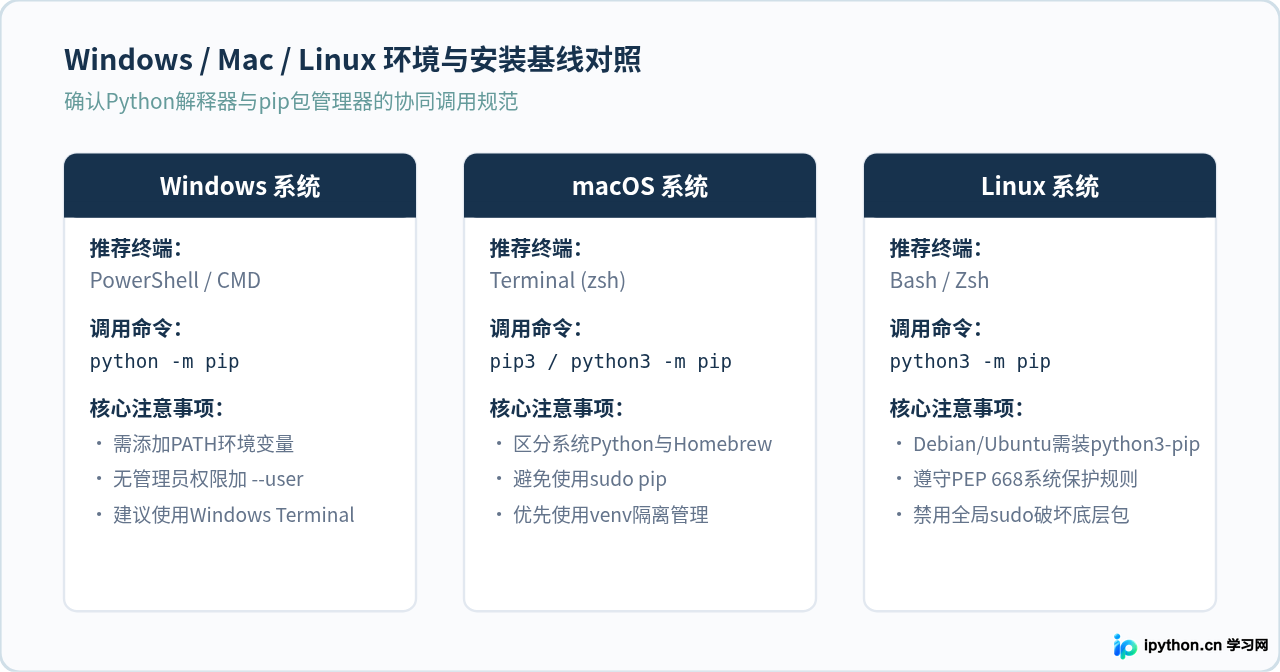
从零开始学习Python数据分析,不需要先成为全栈程序员。本文系统梳理从Python核心语法、数值计算与表格处理核心库,到数据清洗与可视化所需的具体基础知识与学习路径。
本文详细讲解在Python中进行数据统计分析的核心流程。通过NumPy与SciPy库实现描述性统计、t检验、卡方检验及方差分析,结合Matplotlib完成线性回归拟合与数据可视化。代码可直接运行,附带关键参数说明,帮助快速掌握从数据预处理到结论输出的标准操作。
本文详解NumPy库中unique()函数的核心参数与实操流程,涵盖一维与多维数组去重、首次出现索引提取、输入矩阵重建及元素频次统计方法。提供可直接运行的代码示例与避坑指南,帮助开发者高效完成数据清洗、重复值过滤与分布特征查询。
本文基于公交IC卡刷卡数据集,演示使用Python进行数据分析的完整流程。涵盖数据导入、时间格式转换、早晚高峰刷卡量统计、各小时刷卡趋势折线图绘制、乘客搭乘时间函数构建、交易类型占比饼图生成,以及线路、司机与车辆信息的分类存储与高频服务者分析。
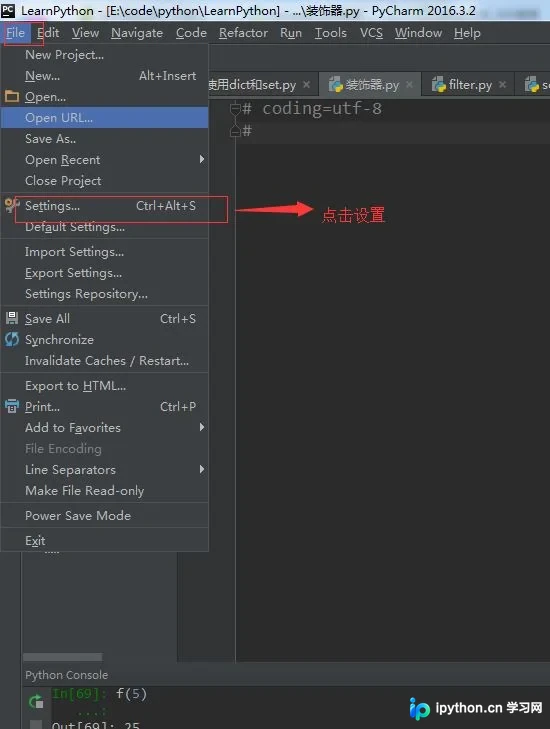
本文详细讲解如何在PyCharm中配置IPython 4.2.1交互环境,解决原生Python编码效率低的问题。通过安装指定版本IPython、修改控制台设置以及编写和绑定宏快捷键,实现多行代码快速执行,提升Python数据分析的开发体验。