
Python数据分析入门:Matplotlib绘图可视化实战指南
本文介绍Python数据分析中常用的Matplotlib可视化库。通过具体代码示例,详细讲解直方图、堆叠图、饼图、散点图、箱线图及雷达图等多种图表的绘制方法。内容涵盖参数设置、中文显示处理及数据呈现技巧,帮助读者快速掌握数据可视化基础技能。
2026-10-15
6


本文介绍Python数据分析中常用的Matplotlib可视化库。通过具体代码示例,详细讲解直方图、堆叠图、饼图、散点图、箱线图及雷达图等多种图表的绘制方法。内容涵盖参数设置、中文显示处理及数据呈现技巧,帮助读者快速掌握数据可视化基础技能。
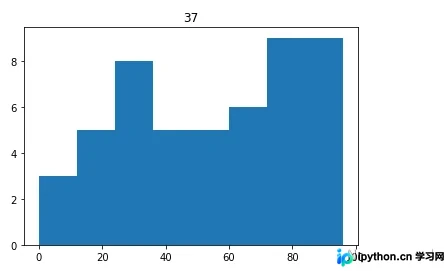
本文详细介绍基于Python的数据分析与建模流程。内容涵盖数据读取、空值与异常值处理(删除、填充、四分位数法)、静态结构分析、数据分区间及对比分析等核心步骤。通过具体代码示例,帮助读者掌握使用Pandas和Numpy进行高效数据预处理与特征工程的方法,适用于实际业务场景中的数据科学实践。
本文详细介绍Python数据分析库Pandas的核心数据结构,包括Series、DataFrame和Panel的定义与区别,重点讲解DataFrame作为二维表格型数据容器的应用。同时提供Pandas的安装命令及模块导入的标准写法,帮助开发者快速上手处理金融时间序列及多维数据集。
本文详细介绍Pandas中DataFrame的核心用法,涵盖从创建、索引选取、行列删除到数学运算与Groupby聚合的完整流程。通过具体代码示例,解析如何处理多维数据、执行映射与聚合操作,并演示导出CSV文件的注意事项,助力高效进行Python数据分析。
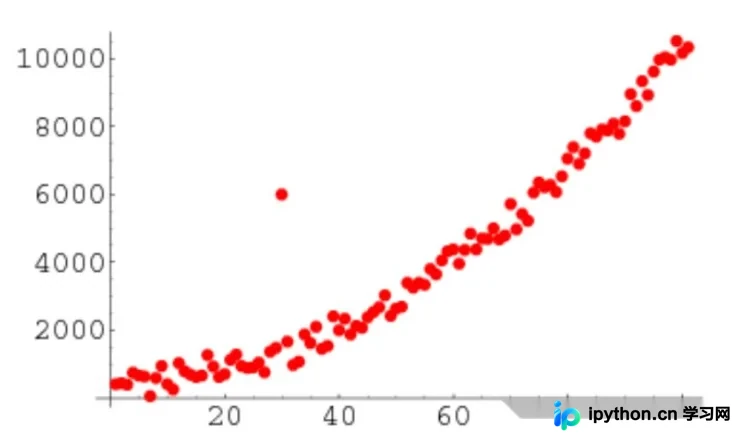
本文详解Python中异常值的定义及两种主流检测方法:基于正态分布的3σ原则和基于四分位距的箱型图法。通过Pandas库对啤酒数据集进行实战演练,展示如何定位并处理如abv字段中的极端离群值,提供完整的代码实现与索引定位技巧,帮助开发者掌握数据清洗核心技能。
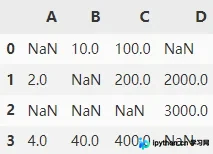
本文详解Python Pandas中缺失值的检测与处理技巧。通过info()、isnull()等方法识别NaN数据,并深入解析dropna()删除策略(axis、how、thresh、subset参数)及fillna()填充方法(直接指定、ffill/bfill前向/后向填充、limit限制)。掌握这些核心参数,高效完成数据清洗。
本文深入解析Python Pandas库中read_sql_query函数的使用方法。详细说明了如何将SQL查询结果高效转换为DataFrame,并逐一解读sql、con、index_col、coerce_float、params及parse_dates等关键参数的配置技巧。结合MySQL连接实例,展示如何安全传递参数并处理日期格式,帮助开发者快速掌握数据库交互与数据清洗的核心技能。
本文系统介绍Pandas中Dataframe的多种数据选取方法,涵盖df[]单维选取、df.loc[]标签索引、df.iloc[]整数索引、df.ix[]混合索引以及df.at[]和df.iat[]单元格选取。通过具体代码示例解析切片规则、布尔筛选及返回值类型,帮助开发者高效进行数据过滤与提取。
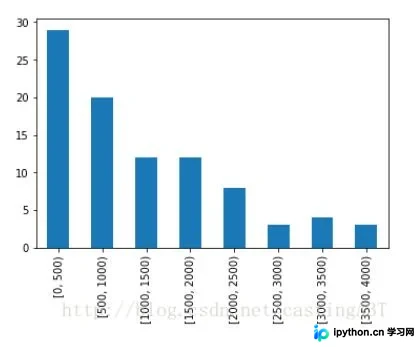
本文通过具体代码示例,演示如何利用pandas库对销售数据进行区间划分(分箱)并计算各区间频率。主要涉及pd.cut函数的区间设置、value_counts统计频数,以及通过DataFrame操作计算频率百分比与累计频率,最终结合matplotlib生成条形图可视化结果。
本文详细介绍Python中pandas库的安装方法及核心数据结构。通过pip命令快速安装pandas后,深入解析Series和DataFrame两种主要数据对象的创建方式。内容涵盖从列表、字典生成Series,利用Matplotlib进行可视化,以及DataFrame的行列索引、数据读取与切片操作,帮助初学者掌握数据处理基础。
本文深入解析Python数据分析的八大核心第三方库。涵盖Pandas的高效数据处理、Numpy的底层数组运算、Matplotlib的可视化绘图,以及SciPy、Scikit-Learn、Keras、Scrapy和Gensim在科学计算、机器学习、爬虫和自然语言处理中的应用,助您构建完整的数据分析技术栈。
本文深入解析Numpy中数组转置的三种方式:transpose函数、T属性及swapaxes轴交换。通过2x2x4及更高维度的具体代码示例,详细展示各元素索引在转置前后的变化规律,帮助开发者理解多维数组内存布局与轴对换机制,掌握高效的数据处理技巧。