Python利用BeautifulSoup CSS选择器爬取京东商品信息实战
本文详解如何使用Python的Beautiful库结合CSS选择器高效抓取京东商品信息。通过解析搜索URL参数、利用urllib.quote编码关键词,并编写具体的CSS提取逻辑,快速获取商品名称、链接、图片及价格。适合希望掌握轻量级网页解析技术的开发者参考。
2026-10-13
5

本文详解如何使用Python的Beautiful库结合CSS选择器高效抓取京东商品信息。通过解析搜索URL参数、利用urllib.quote编码关键词,并编写具体的CSS提取逻辑,快速获取商品名称、链接、图片及价格。适合希望掌握轻量级网页解析技术的开发者参考。
本文详解Python爬虫中PyQuery模块的基本用法。PyQuery基于lxml,提供类似jQuery的API解析HTML/XML。内容涵盖模块安装、三种初始化方式(字符串、URL、文件)、丰富的CSS选择器(标签、类、ID、属性、伪类)及DOM操作(查找、过滤、添加/移除Class)。通过豆瓣新书爬取实例,演示如何定位元素、提取文本属性及处理分页逻辑,适合Python初学者快速掌握网页数据抓取技巧。
在Django开发中,修改JS或CSS文件后浏览器仍显示旧版本,通常因浏览器缓存导致。本文以Chrome为例,详解如何通过清除浏览数据中的缓存文件来解决此问题,确保前端资源及时更新。
本文深入解析Django中Widget的作用,区分其与Field在验证与渲染上的职责。详细演示如何通过widget参数指定Textarea、SelectDateWidget等控件,并重点讲解利用attrs字典为特定字段添加CSS类或HTML属性(如size)的方法,帮助开发者实现更美观、功能更丰富的表单界面。
本文详细介绍Django模板语言(DTL)中加载CSS、JS及图片等静态文件的标准流程。涵盖{% load static %}的使用、settings.py中INSTALLED_APPS与STATIC_URL的配置、app内static目录规范、STATICFILES_DIRS全局路径设置,以及未启用staticfiles时的URL映射方案,帮助开发者解决静态资源加载问题。
本文梳理了 CSS 文字特效的实现方法。首先解析历史上用于 Internet Explorer 的专有滤镜(如 glow、blur、dropshadow)的原理及局限,并指出其兼容性差的问题。随后重点介绍现代标准 CSS3 技术,包括 filter 属性(用于高斯模糊、阴影等)、text-shadow(用于投影)、background-clip 和 mask-image(用于蒙版)。提供跨浏览器兼容的示例代码,帮助开发者在无需 JavaScript 的情况下实现高质量的视觉设计效果。
本文介绍如何利用CSS的@media print规则优化网页打印效果。通过定义独立的打印样式表,可控制页面断点(page-break-after)、隐藏屏幕专用UI元素,并结合ActiveX或现代浏览器API实现打印预览与调用。重点解决报表导出时的布局错乱与多余内容干扰问题,确保纸质输出清晰专业。
jQuery css() 方法用于动态设置或返回被选元素的一个或多个CSS样式属性。通过传入键值对对象可同时配置多种样式,或仅指定属性名来获取当前计算后的样式值,是前端DOM操作中灵活控制页面视觉表现的核心手段。
本文介绍如何通过JavaScript函数动态修改元素的className属性,结合预定义的CSS类来实现样式的动态切换。相比直接操作样式或查找替换,该方法通过“应用一套逻辑处理多种元素”的思路,更易于维护。代码演示了如何在HTML元素上绑定onmouseover和onmouseout事件,并在鼠标经过与离开时分别应用不同的边框颜色样式。
本文介绍如何利用Python结合HBuilder开发环境,对MUI框架下的APP登录页面进行视觉美化。重点讲解两种背景图片引入方式(CSS文件引用与内联Style)以及输入框的样式优化,帮助开发者提升软件界面美观度。
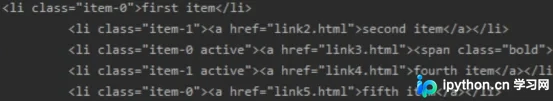
本文详细介绍Python中PyQuery库的安装与基础用法。通过pip3安装后,利用PyQuery类实现HTML字符串、文件或网络响应的初始化。重点演示如何使用CSS选择器精准定位并提取DOM元素内容,帮助开发者快速掌握这一灵活的数据解析工具。
本文介绍如何在Jupyter Notebook中调整输出窗口的显示效果。通过工具栏的Cell菜单,用户可以切换Toggle Scrolling以查看完整长输出或清除内容。此外,针对主题更换后可能出现的字符截断问题,提供修改custom.css文件中div.output_area的padding值(如13px)的解决方案,确保输出内容完整显示。