

Python爬虫实战:PyQuery模块基础与DOM操作详解

本文详解Python爬虫中PyQuery模块的基本用法。PyQuery基于lxml,提供类似jQuery的API解析HTML/XML。内容涵盖模块安装、三种初始化方式(字符串、URL、文件)、丰富的CSS选择器(标签、类、ID、属性、伪类)及DOM操作(查找、过滤、添加/移除Class)。通过豆瓣新书爬取实例,演示如何定位元素、提取文本属性及处理分页逻辑,适合Python初学者快速掌握网页数据抓取技巧。
本文详细介绍了Python爬虫开发中PyQuery模块的基础使用方法,旨在为读者提供一份实用的参考指南。
- PyQuery模块简介
- PyQuery的使用
- 模块安装
- 模块导入
- 解析对象初始化
- CSS选择器应用
- 后代元素选取
- 获取文本与属性
- PyQuery执行DOM操作、CSS操作
- DOM节点操作
- CSS样式操作
- PyQuery爬取豆瓣新书实战案例
首发时间:2018-03-09 21:26
- PyQuery允许对XML和HTML文档进行类似jQuery的查询操作。
- 该模块底层依赖lxml库,从而实现高效的XML和HTML解析与操作。
- 可以说,PyQuery就是Python环境下的jQuery实现。
1. 安装模块
pip3 install pyquery2. 导入模块
from pyquery import PyQuery as pq3. 解析对象初始化
【使用PyQuery初始化解析对象,PyQuery是一个类,直接将要解析的对象作为参数传入即可】
- 解析对象为字符串时字符串初始化:默认情况下是字符串,如果字符串包含http或https前缀,将被视为URL。
textParse = pq(html) - 解析对象为网页时url初始化:建议使用关键字参数url=。
# urlParse = pq('http://www.baidu.com') #1 urlParse = pq(url='http://www.baidu.com') #2 - 解析对象为文件时文件初始化:建议使用关键字参数filename=。
fileParse = pq(filename="L:\demo.html") - 解析完成后,即可使用相关函数或变量进行筛选,支持使用CSS选择器等方式进行过滤。
4. CSS选择器
- 利用标签获取:
result = textParse('h2').text() - 利用类选择器:
result3=textParse(".p1").text() - 利用id选择:
result4=textParse("#user").attr("type") - 分组选择:
result5=textParse("p,div").text() - 后代选择器:
result6=textParse("div a").attr.href - 属性选择器:
result7=textParse("[class='p1']").text() - CSS3伪类选择器:
result8=textParse("p:last").text()
(更多用法可参考标准CSS文档)
5. 在选定元素之后的元素再选取
- find():用于找出指定的子元素,该方法可接受参数,参数格式需符合任何jQuery选择器的语法。
- filter():用于对结果集进行过滤,找出指定元素,同样可接受任何jQuery选择器语法的参数。
- children():获取所有直接子元素,可接受任何jQuery选择器语法的参数进行过滤。
- parent():获取父元素,可接受任何jQuery选择器语法的参数。
- parents():获取所有祖先元素,可接受任何jQuery选择器语法的参数。
- siblings():获取兄弟元素,可接受任何jQuery选择器语法的参数。
from pyquery import PyQuery as pq

html="""
<html>
<head>
</head>
<body>
<h2>This is a heading</h2>
<p class="p1">This is a paragraph.</p>
<p class="p2">This is another paragraph.</p>
<div>
123
<a id="a1" href="http://www.baidu.com" rel="external nofollow" rel="external nofollow" rel="external nofollow" >hello</a>
</div>
<input type="Button" >
<input id="user" type="text" >
</body>
"""

###初始化
textParse = pq(html)
# urlParse = pq('http://www.baidu.com') #1
# urlParse = pq(url='http://www.baidu.com') #2
# fileParse = pq(filename="L:\demo.html")

##获取
result = textParse('h2').text()
print(result)
result2= textParse('div').html()
print(result2)
result3=textParse(".p1").text()
print(result3)
result4=textParse("#user").attr("type")
print(result4)
result5=textParse("p,div").text()
print(result5)
result6=textParse("div a").attr.href
print(result6)
result7=textParse("[class='p1']").text()
print(result7)
result8=textParse("p:last").text()
print(result8)
result9=textParse("div").find("a").text()
print(result9)
result12=textParse("p").filter(".p1").text()
print(result12)
result10=textParse("div").children()
print(result10)
result11=textParse("a").parent()
print(result11)
6. 元素的文本、属性等内容的获取
attr(attribute):用于获取指定属性的值。
result2=textParse("a").attr("href")attr.xxxx:直接通过属性名获取属性xxxx的值。
result21=textParse("a").attr.href
result22=textParse("a").attr.class_
text():获取文本内容,若存在子元素,仅返回直接文本节点。
result1=textParse("a").text()html():获取HTML内容,功能与text类似,但会返回包含标签的完整HTML字符串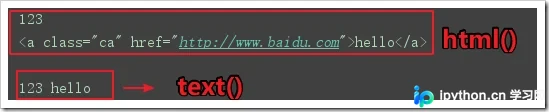 。
result3=textParse("div").html()补充说明1:
元素迭代:如果返回结果是多个元素,想要逐个迭代处理每个元素,可以使用items()方法。
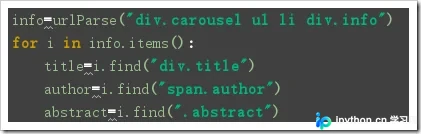
补充说明2:PyQuery是jQuery的Python化版本,语法基本相通,想了解更多细节可参考jQuery官方文档。
DOM操作
add_class():用于增加class属性。
remove_class():用于移除class属性。
remove():用于删除指定的元素节点。
from pyquery import PyQuery as pq

html="""
<html>
<head>
</head>
<body>
<h2>This is a heading</h2>
<p id="p1" class="p1">This is a paragraph.</p>
<p class="p2">This is another paragraph.</p>
<div style="color:blue">
123
<a class="ca" href="http://www.baidu.com" rel="external nofollow" rel="external nofollow" rel="external nofollow" >hello</a>
</div>
<input type="Button" >
<input id="user" type="text" >
</body>
"""

textParse=pq(html)
textParse('a').add_class("c1")
print(textParse('a').attr("class"))

textParse('a').remove_class("c1")
print(textParse('a').attr("class"))

print(textParse('div').html())
textParse('div').remove("a")
print(textParse('div').html())
CSS操作
- attr():设置属性
- 设置格式:attr("属性名","属性值")
- css():设置css
- 设置格式1:css("css样式","样式值")
- 格式2:css({"样式1":"样式值","样式2":"样式值"})
from pyquery import PyQuery as pq

html="""
<html>
<head>
</head>
<body>
<h2>This is a heading</h2>
<p id="p1" class="p1">This is a paragraph.</p>
<p class="p2">This is another paragraph.</p>
<div style="color:blue">
123
<a class="ca" href="http://www.baidu.com" rel="external nofollow" rel="external nofollow" rel="external nofollow" >hello</a>
</div>
<input type="Button" >
<input id="user" type="text" >
</body>
"""

textParse=pq(html)
textParse('a').attr("name","hehe")
print(textParse('a').attr("name"))

textParse('a').css("color","white")
textParse('a').css({"background-color":"black","postion":"fixed"})
print(textParse('a').attr("style"))
这些操作的应用场景:
【有时可能需要对获取的数据样式进行处理后再存储,例如获取到的数据样式不满意,可以自定义格式】
【有时需要逐层清理后再筛选指定结果,例如在<div>123<a></a></div>中,若只想获取123,可先删除<a>标签再获取】
首先使用浏览器审查元素功能,定位目标元素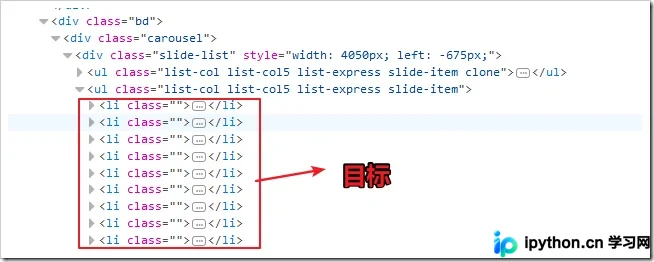 。
确认需要爬取的具体信息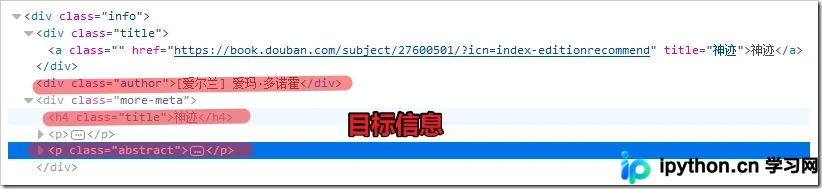 。
需要注意的是,豆瓣新书列表存在分页,实际目标元素应为li的上一级ul: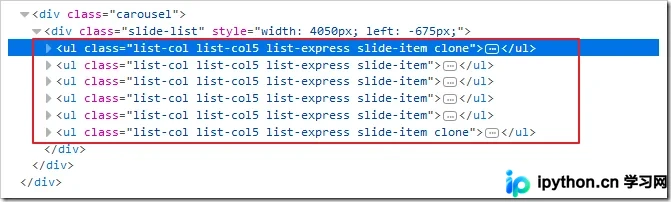 。
使用PyQuery筛选并提取结果:
from pyquery import PyQuery as pq

urlParse=pq(url="https://book.douban.com/")

info=urlParse("div.carousel ul li div.info")

file=open("demo.txt","w",encoding="utf8")
for i in info.items():
  title=i.find("div.title")
  author=i.find("span.author")
  abstract=i.find(".abstract")
  file.write("标题:"+title.text()+"\n")
  file.write("作者:"+author.text()+"\n")
  file.write("概要:"+abstract.text()+"\n")
  file.write("-----------------\n")
  print("\n")
file.close()
更多关于Python相关内容可查看本站专题:《Python Socket编程技巧总结》、《Python正则表达式用法总结》、《Python数据结构与算法教程》、《Python函数使用技巧总结》、《Python字符串操作技巧汇总》、《Python入门与进阶经典教程》及《Python文件与目录操作技巧汇总》
希望本文所述内容对大家学习Python程序设计有所帮助。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









