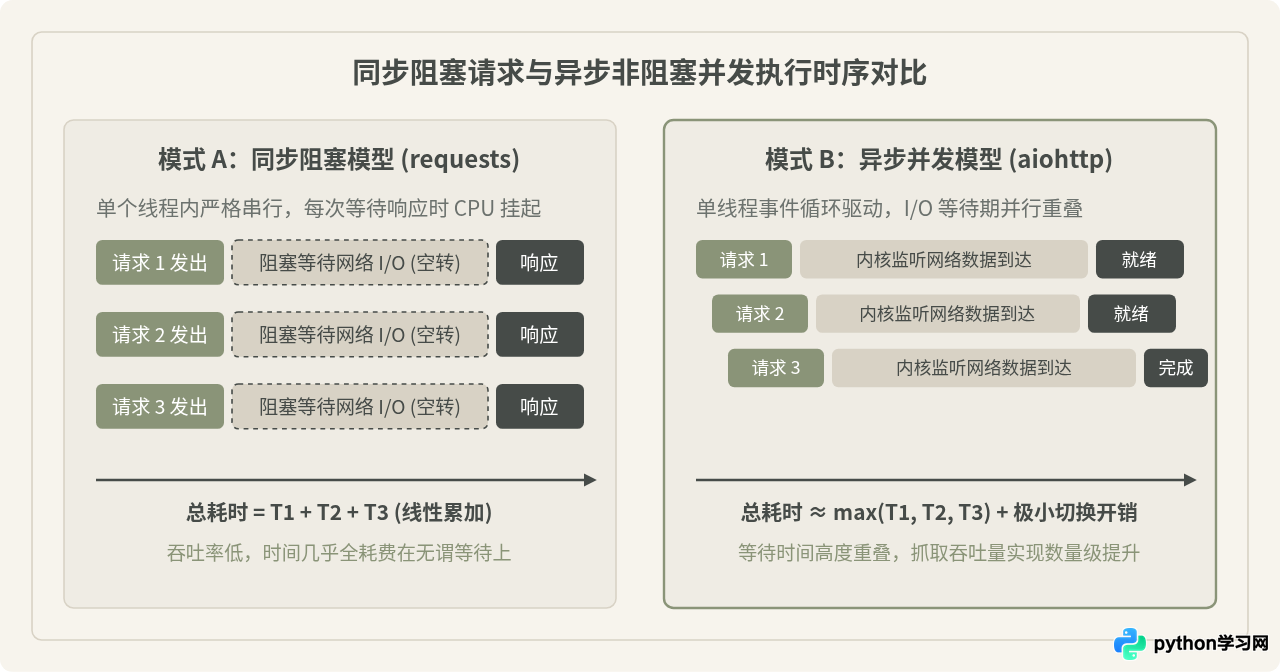
Python整站爬取速度慢怎么办?并发下载与链接去重优化策略
解决Python整站爬取速度慢的问题,详细讲解基于aiohttp的并发下载优化与基于Set/Redis/布隆过滤器的链接去重策略。
2026-09-18
55

解决Python整站爬取速度慢的问题,详细讲解基于aiohttp的并发下载优化与基于Set/Redis/布隆过滤器的链接去重策略。
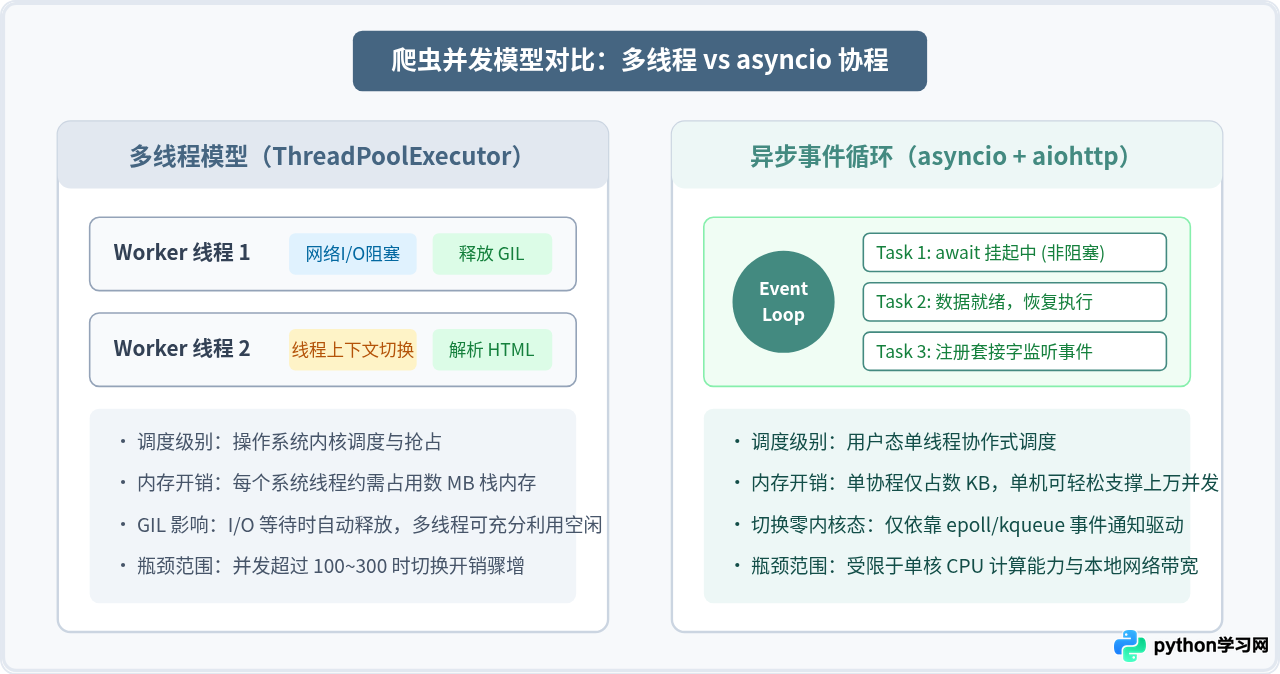
深入解析Python爬虫在海量网络请求场景下的并发抓取优化方案,系统对比ThreadPoolExecutor多线程与asyncio异步事件循环机制,通过完整实战代码、信号量限流与连接池治理,实现稳定高效的数据采集。
深入解析如何利用Python的asyncio标准库与aiohttp异步HTTP客户端构建高性能网络数据抓取系统,涵盖事件循环原理、连接池优化、并发限流与异常重试机制。
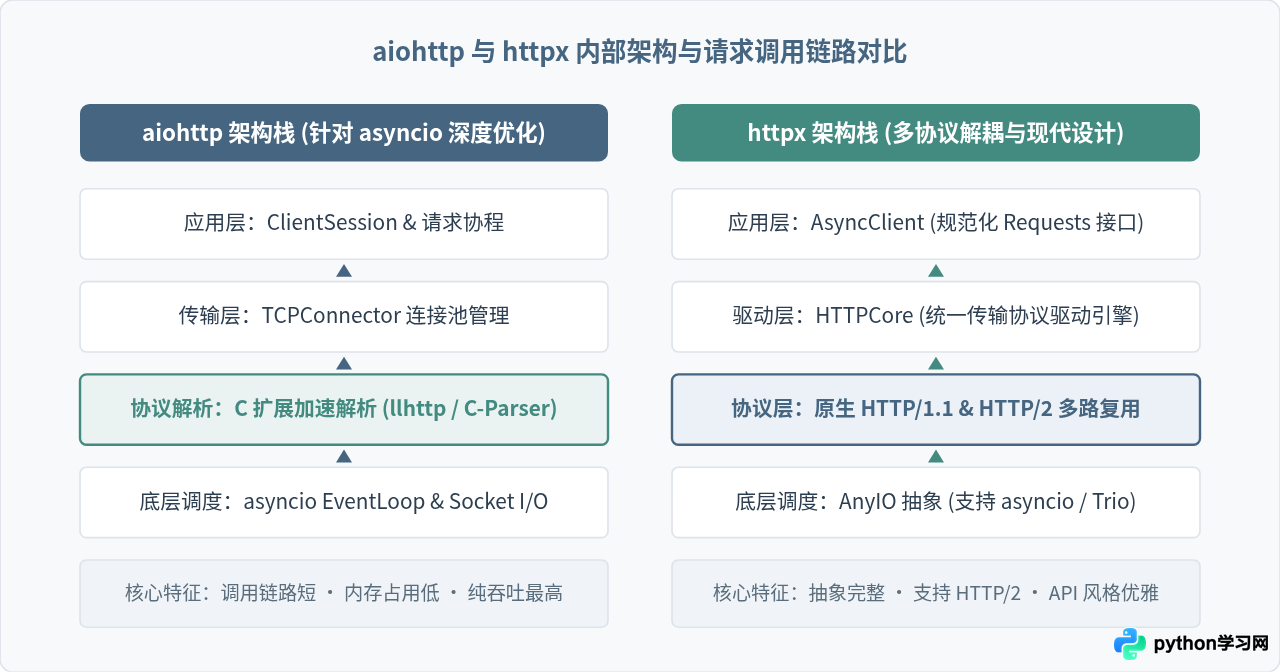
深入对比Python主流异步网络库aiohttp与httpx在高并发爬虫场景下的表现,从底层架构、吞吐量(RPS)、内存占用、连接池复用机制到实际代码调优,提供清晰实用的选型指南。
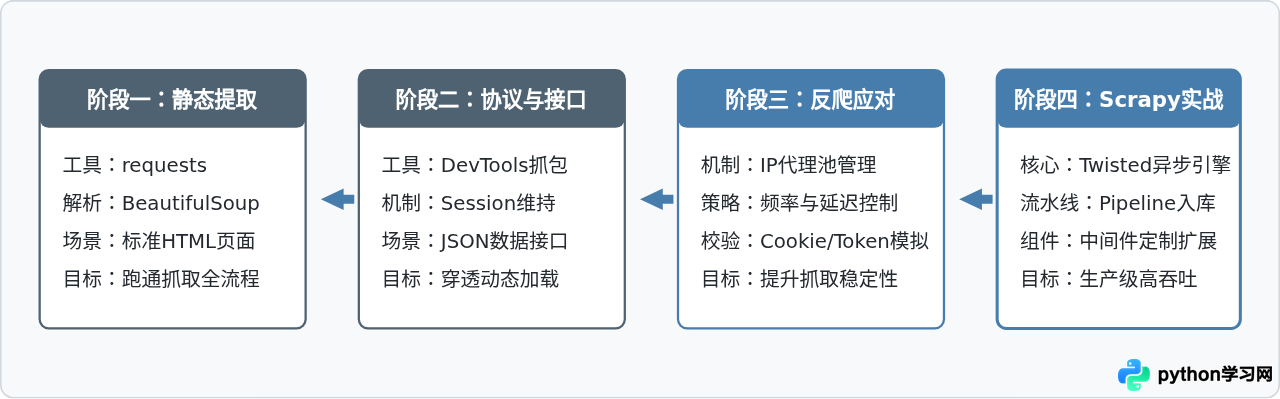
系统梳理Python网络爬虫的核心实现路径,从轻量级requests静态网页抓取、HTML解析与反爬对抗,深入进阶到Scrapy工业级异步框架的工程化实操与架构应用。
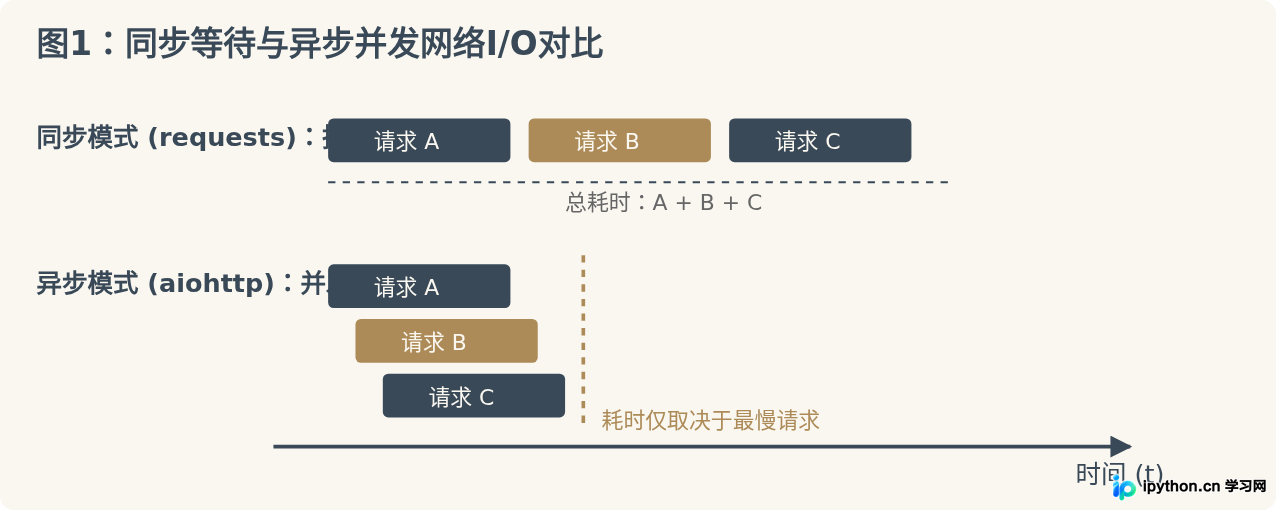
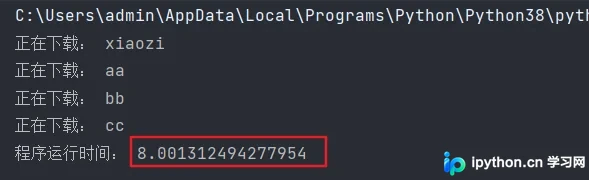
本文详细解析Python异步爬虫中处理多个URL请求时的性能优化方案。通过对比单线程阻塞、多线程及线程池三种方式,展示了如何利用并发机制减少等待时间。重点介绍了线程池在降低系统开销方面的优势,并提供了具体的代码示例与运行结果分析,帮助开发者选择合适的并发策略。
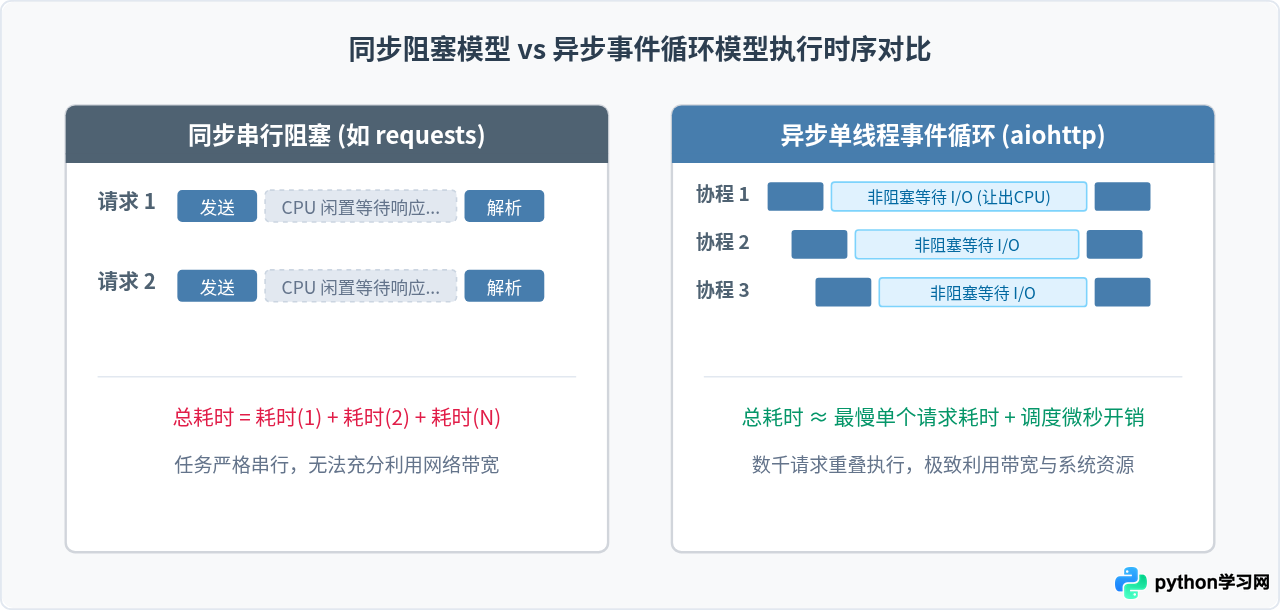
深入讲解如何使用 Python 标准库 asyncio 与第三方异步 HTTP 客户端 aiohttp 突破网络 I/O 阻塞瓶颈,通过非阻塞事件循环、信号量限流、连接池复用及异常容错设计,构建稳定高效的高并发抓取架构。
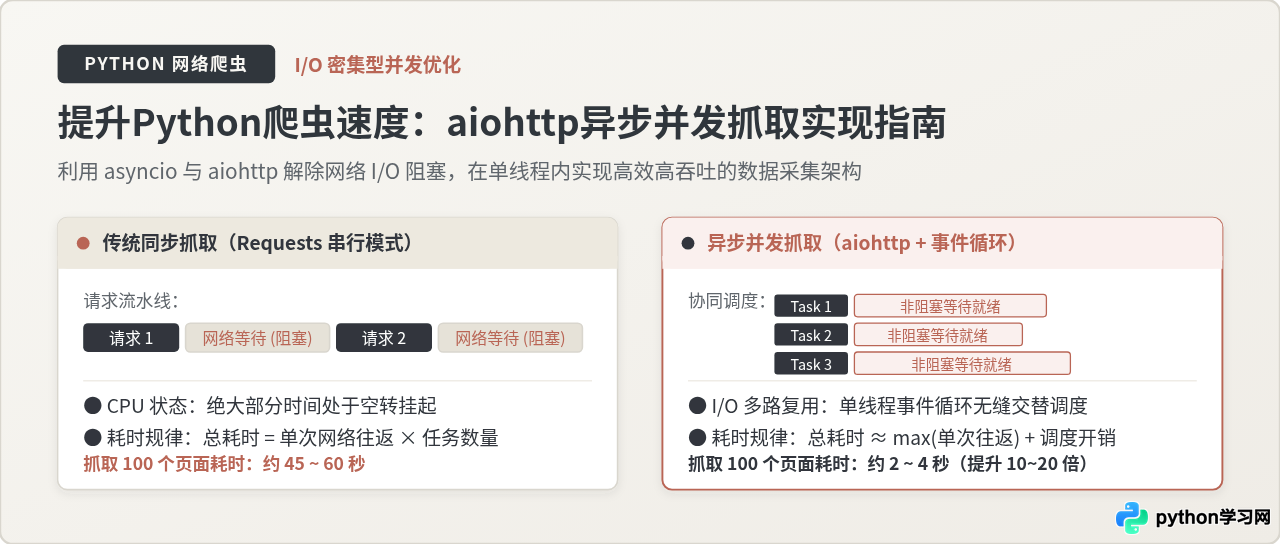
深入讲解如何使用Python的asyncio标准库与aiohttp库构建高效的异步并发网络爬虫,包含连接池复用、并发度控制、超时异常处理及常见避坑指南。