

Python爬虫100例:从requests静态抓取到Scrapy框架实战
系统梳理Python网络爬虫的核心实现路径,从轻量级requests静态网页抓取、HTML解析与反爬对抗,深入进阶到Scrapy工业级异步框架的工程化实操与架构应用。
网络数据采集的核心是将无序的网络响应转换为结构化数据的工程过程。掌握Python爬虫并不需要盲目堆砌代码案例,而是需要建立一条清晰的认知递进链路:从最基础的HTTP网络请求与静态DOM解析切入,理清请求头配置、状态码处理与编码规则,再逐步过渡到会话保持、反爬对抗,最终升级为支持异步并发调度、流水线清洗和分布式扩展的Scrapy工业级框架。本文将以模块化实战的方式拆解这一技术演进过程。
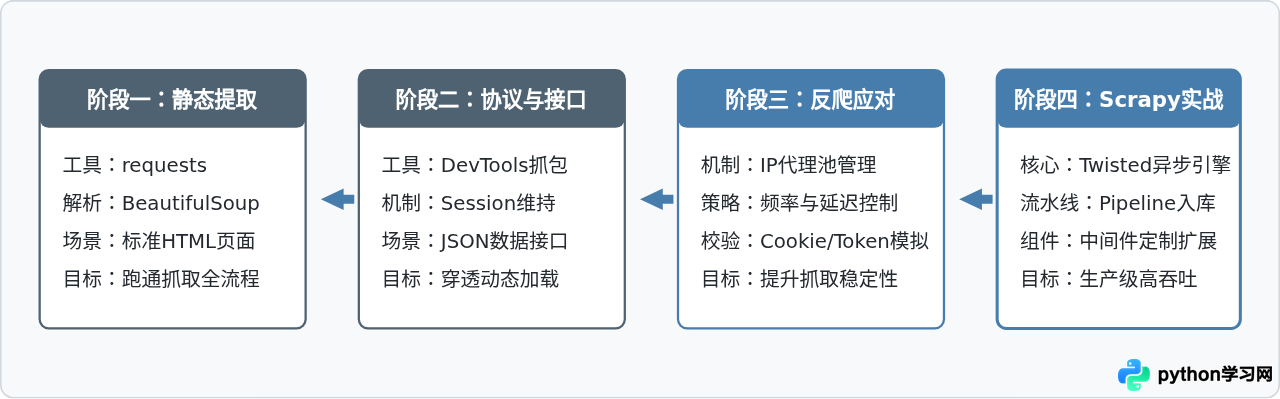
一、爬虫开发能力递进模型
编写爬虫程序通常经历从单脚本探测到工程化架构设计的转变。在初期阶段,开发者关注的是单一URL的数据提取;随着抓取规模上升,网络波动、反爬机制、并发吞吐与数据清洗校验成为主要矛盾。清晰的技术分层能帮助开发者在不同业务需求下选择最经济的技术方案。
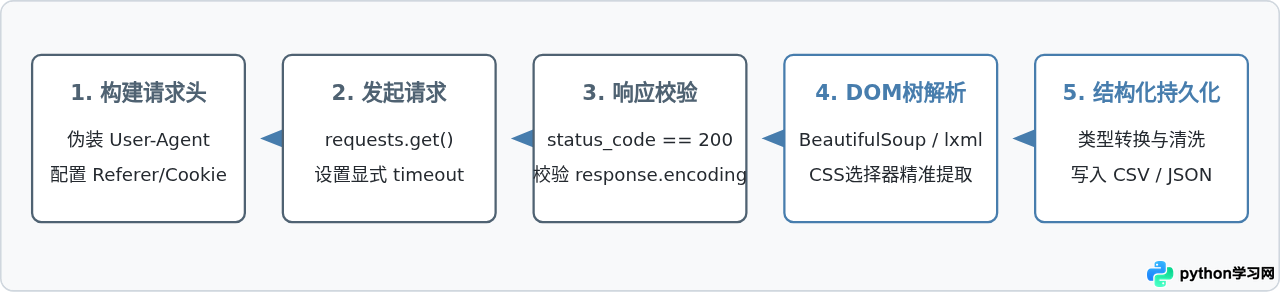
二、requests 静态抓取标准作业流程
静态页面是指客户端发起HTTP请求后,服务端返回的HTML文档中已直接包含所需文本或属性数据的页面。使用 requests 库配合 BeautifulSoup 是构建静态采集器的经典组合。在实施采集时,必须遵循严谨的步骤链条,避免因缺少请求头、字符集解码错误或超时未处理导致程序崩溃。
完整静态抓取代码范式
以下示例演示一个经过健壮性封装的静态页面爬取函数,涵盖超时控制、异常捕获、自动推导字符集及 CSS 选择器解析:
import requests
from bs4 import BeautifulSoup

def fetch_article_list(page_url):
    headers = {
        "User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/120.0.0.0 Safari/537.36",
        "Accept-Language": "zh-CN,zh;q=0.9,en;q=0.8"
    }

    try:
        response = requests.get(page_url, headers=headers, timeout=10)
        # 触发 HTTP 状态码异常(如 403, 404, 500)
        response.raise_for_status()

        # 若页面出现乱码,使用 apparent_encoding 重新指派
        if response.encoding.lower() in ("iso-8859-1", "ascii"):
            response.encoding = response.apparent_encoding

        soup = BeautifulSoup(response.text, "html.parser")
        items = []

        # 假设提取列表项
        article_nodes = soup.select("article.post-item")
        for node in article_nodes:
            title_node = node.select_one("h2.title > a")
            date_node = node.select_one(".post-meta time")

            if title_node:
                title = title_node.get_text(strip=True)
                link = title_node.get("href", "")
                publish_date = date_node.get_text(strip=True) if date_node else "N/A"
                items.append({
                    "title": title,
                    "link": link,
                    "publish_date": publish_date
                })
        return items

    except requests.exceptions.Timeout:
        print(f"[错误] 请求超时: {page_url}")
    except requests.exceptions.HTTPError as err:
        print(f"[错误] HTTP状态码异常: {err.response.status_code}")
    except requests.exceptions.RequestException as err:
        print(f"[错误] 网络异常: {err}")
return []避坑指南:requests.get() 默认没有超时时间。如果不显式指定 timeout=(5, 15)(连接超时5秒,读取超时15秒),当远程服务器挂起连接时,整个进程将无限期阻塞。
三、动态内容、会话维持与反爬突破
现代网站大量采用前后端分离架构,直接请求页面 URL 往往只能拿到一个空的 HTML 骨架。针对动态加载页面,通常有两种解决路径:
- 逆向接口抓包:利用浏览器的开发者工具(F12 - Network 面板),筛选
Fetch/XHR类型的异步请求。直接请求后端返回 JSON 数据的接口,往往速度最快、数据最规范。 - Session 与 Cookie 维护:当需要登录凭证或保持上下文状态时,使用
requests.Session()对象自动维护 Cookie 池,避免每次手工复制 Cookie 字符串。
import requests

session = requests.Session()
session.headers.update({
    "User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36",
    "Referer": "https://example.com/portal"
})

# 1. 访问首页获取基础防伪 Cookie 或 CSRF Token
session.get("https://example.com/portal")

# 2. 携带 Session 状态发起数据 API 请求
api_url = "https://example.com/api/v1/posts?page=1&size=20"
resp = session.get(api_url, timeout=8)
data = resp.json()
print("抓取到记录数:", len(data.get("items", [])))
四、Scrapy 工业级异步爬虫框架实战
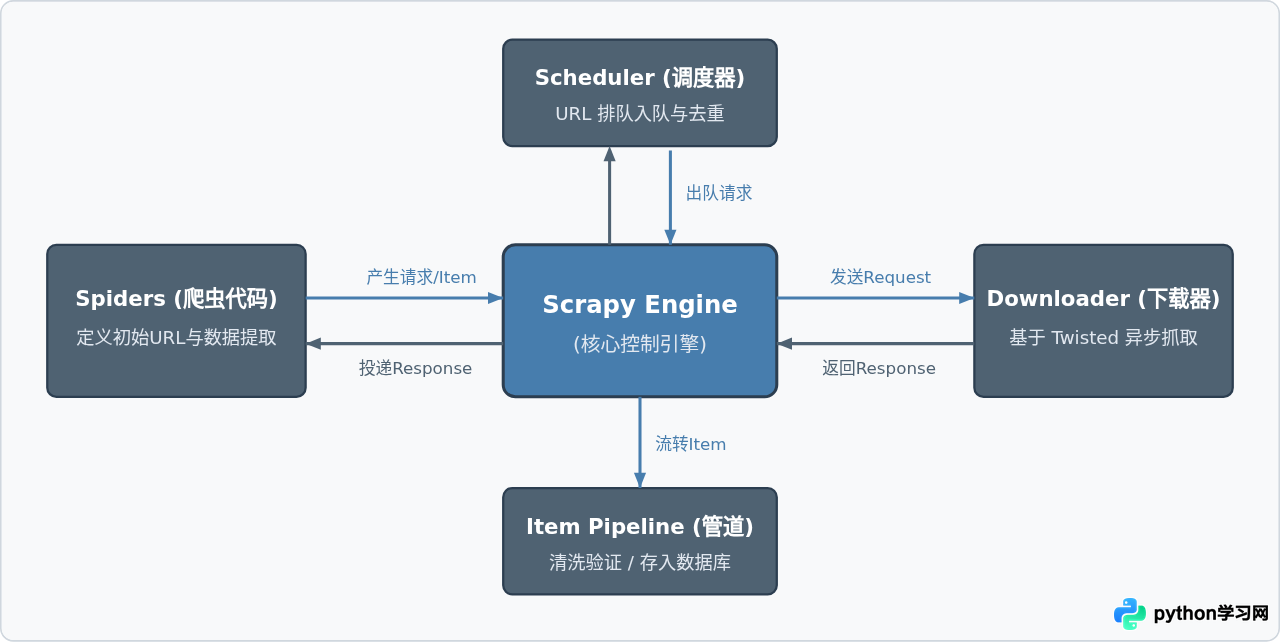
当抓取任务扩展至数万或数百万页面时,基于多线程或单进程同步请求的脚本往往面临吞吐瓶颈、任务去重困难和内存泄漏问题。Scrapy 是基于 Twisted 事件驱动架构开发的高性能爬虫框架,其模块高度解耦,各组件分工明确。
Scrapy 工程实战演练
一个标准的 Scrapy 任务包含创建项目、定义实体模型(Items)、编写爬虫核心逻辑(Spider)以及数据清洗持久化(Pipeline)。
1. 初始化项目与目录结构:
# 在终端执行命令创建标准模板
scrapy startproject article_crawler
cd article_crawler
scrapy genspider tech_spider example.com
2. 编写 Spider 抓取逻辑 (spiders/tech_spider.py):
import scrapy

class TechSpider(scrapy.Spider):
    name = "tech_spider"
    allowed_domains = ["quotes.toscrape.com"]
    start_urls = ["http://quotes.toscrape.com/"]

    def parse(self, response):
        for quote in response.css("div.quote"):
            yield {
                "text": quote.css("span.text::text").get(),
                "author": quote.css("small.author::text").get(),
                "tags": quote.css("div.tags a.tag::text").getall(),
            }

        # 自动跟进下一页链接
        next_page = response.css("li.next a::attr(href)").get()
        if next_page is not None:
            yield response.follow(next_page, callback=self.parse)
3. 配置数据持久化管道 (pipelines.py):
import json

class JsonWriterPipeline:
    def open_spider(self, spider):
        self.file = open("items.jsonl", "w", encoding="utf-8")

    def close_spider(self, spider):
        self.file.close()

    def process_item(self, item, spider):
        line = json.dumps(dict(item), ensure_ascii=False) + "\n"
        self.file.write(line)
        return item
4. 调优核心参数 (settings.py):
# 启用数据管道
ITEM_PIPELINES = {
    "article_crawler.pipelines.JsonWriterPipeline": 300,
}

# 设置下载延迟与并发限制,避免对目标站点造成压力
DOWNLOAD_DELAY = 0.5
CONCURRENT_REQUESTS_PER_DOMAIN = 8
ROBOTSTXT_OBEY = True
五、技术选型与生产环境实践总结
在面对不同的抓取需求时,合理的技术选型可以节省大量的时间与维护成本。过度使用重型框架会增加部署难度,而使用单脚本处理海量请求则容易出现稳定性问题。
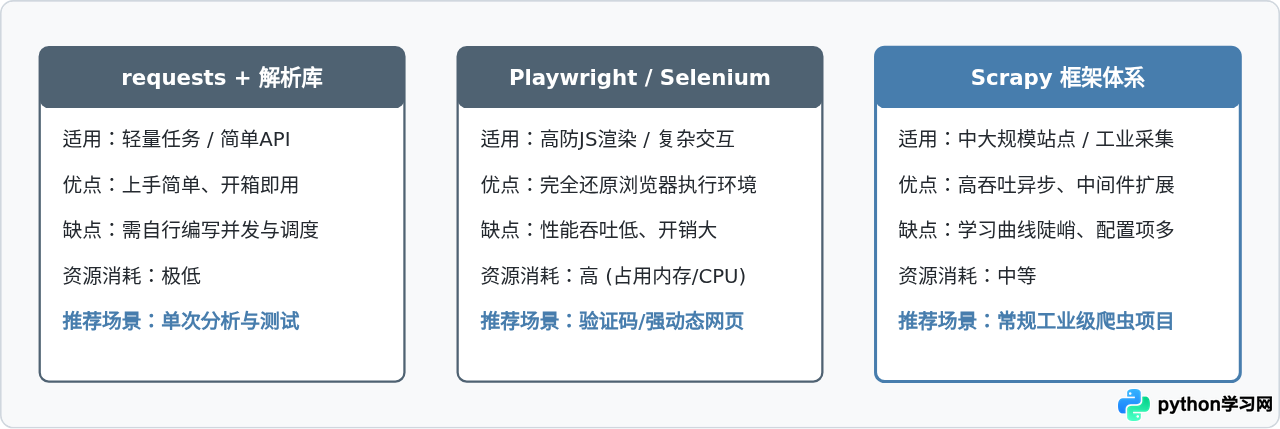
生产环境核心合规与稳定性规范
- 遵守目标站点访问策略:主动检查并遵守目标站点的
robots.txt协议规则,设置合理的请求时间间隔(如 0.5s - 2s),避免高频突发流量造成对方服务器过载。 - 异常熔断与自动重试:为所有网络请求设定最大重试次数与显式超时阈值,并对网络抖动(ConnectionError)、速率受限(429 Too Many Requests)进行差异化休眠退避处理。
- 日志记录与字段校验:在 Pipeline 阶段增加缺失值拦截和数据合法性校验,避免下游数据库因个别脏数据导致事务回滚或字段截断。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









