

Python读取MNIST数据集:.gz与.uncompressed格式实现详解
本文详解使用Python从本地读取MNIST手写数字数据集的方法。涵盖.gz压缩格式与解压缩后.ubyte格式的两种读取策略,解析文件头Magic Number与样本数量结构,提供训练集与测试集的完整加载代码及验证步骤,适用于机器学习入门与模型训练准备。
2026-10-14
6

本文详解使用Python从本地读取MNIST手写数字数据集的方法。涵盖.gz压缩格式与解压缩后.ubyte格式的两种读取策略,解析文件头Magic Number与样本数量结构,提供训练集与测试集的完整加载代码及验证步骤,适用于机器学习入门与模型训练准备。
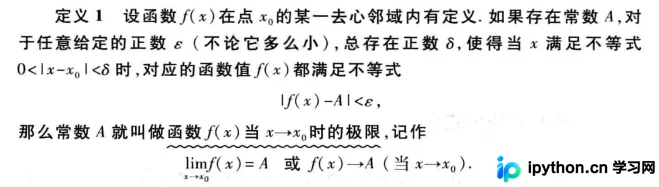
本文通过Python代码演示高等数学中函数极限与导数的计算方法。利用SymPy库进行符号极限推导,并结合NumPy的poly1d及SciPy的derivative函数实现多项式求导,帮助机器学习初学者验证数学公式,夯实算法背后的数学基础。
本文深入解析Python机器学习中的数据准备流程,涵盖数据预处理四大核心方法:Min-Max缩放、正态化、标准化及二值化处理,并详细阐述特征选定策略,包括单变量卡方检验、递归特征消除(RFE)、主成分分析(PCA)及基于树模型的特征重要性评估,助力提升模型精度与训练效率。
本文详解 JavaScript 中事件绑定(addEventListener、attachEvent)与解绑的核心原理及跨浏览器兼容方案。通过对比标准 W3C 接口与旧版 IE 接口在参数定义、执行顺序上的差异,提供一套健壮的事件注册代码示例,帮助开发者实现现代浏览器与 IE8 及以下版本的一致体验。
本文详细介绍K-means聚类算法的原理、目标函数及Python实现流程。涵盖初始化质心、迭代更新与收敛判断,提供基于sklearn与手动实现的代码示例,并分析算法优缺点及注意事项。
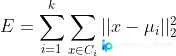
本文深入解析Python环境下的模型集成技术,强调模型多样性对提升预测性能的关键作用。详细对比了简单平均与加权平均两种集成策略,并系统介绍了Bagging(挂袋法)、加权提升法及梯度提升法的核心原理与适用场景,为构建更稳定、准确的机器学习模型提供理论依据与实践指导。
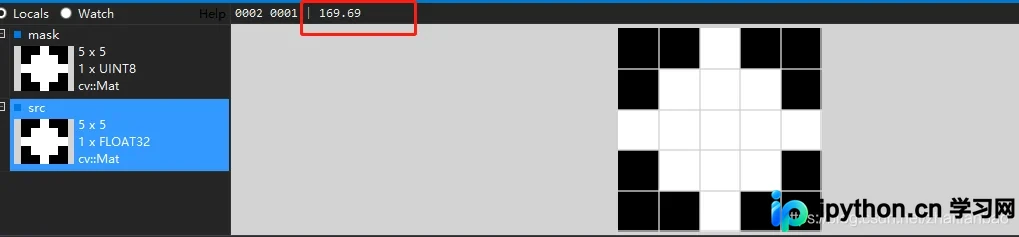
本文介绍OpenCV中cv::mean函数的用法,用于计算cv::Mat矩阵的平均值。该函数支持指定通道及掩膜(mask)进行局部计算。通过C++测试代码演示如何结合掩膜筛选特定区域数据,并对比手动计算与函数结果,验证其准确性。
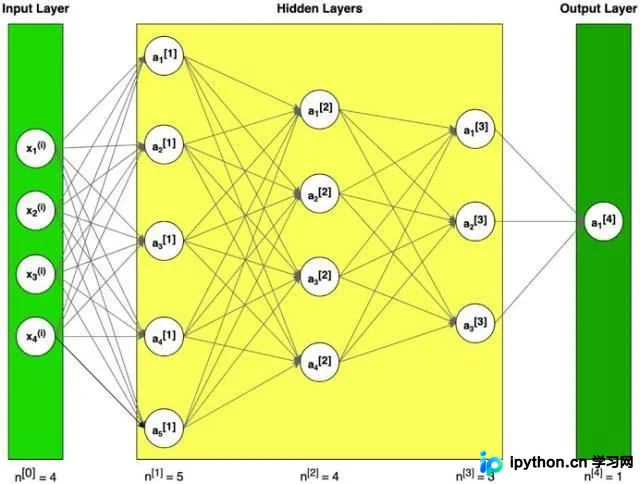
本文详细解析如何使用Python从零构建支持任意层数的深度神经网络。内容涵盖神经网络基础原理、数据集预处理、参数初始化策略、Sigmoid与ReLU激活函数应用,以及正向传播、损失函数计算和反向传播的核心算法。通过完整的Python代码示例,展示如何定义模型架构、执行梯度下降优化及更新参数,帮助开发者掌握深度学习模型构建的关键步骤。
本文介绍在 C# 中如何高效处理全角与半角字符。通过比较字符串长度与字节数快速判断字符类型,并利用 Unicode 码值差异(空格12288/32,其他字符差65248)编写 ToSBC 和 ToDBC 方法实现双向转换,适用于数据清洗与文本规范化场景。
本文解析C++中的函数重载(Overload),即通过不同参数类型或数量,使多个同名函数共存。详细介绍如何通过修改参数表来避免编译器错误,并演示如何使用abs函数处理整型、浮点型和双精度数。同时强调返回值类型不参与重载判断,以及类型转换可能带来的风险。
本文详细介绍PaddleOCR库的安装配置、基础代码实现及核心功能特性。PaddleOCR支持中英文数字组合识别、竖排及长文本处理,提供轻量级模型与多种检测识别算法。文章涵盖从环境搭建到实际调用的完整流程,并列举其跨平台部署与移动端支持能力,助力开发者快速落地OCR应用。
C#泛型通过引入类型参数T,在实现代码复用的同时解决了传统object类型的装箱拆箱性能损耗和运行时类型转换异常问题。本文深入解析C#泛型的编译机制(IL占位符与JIT即时实例化)、核心优势及约束方法,帮助开发者构建高性能且类型安全的集合类与数据结构。