Python批量下载网络图片的多种实现方案与反爬应对
本文详细汇总了Python下载网络图片的多种方法,涵盖从已知URL直接下载到通过正则表达式和BeautifulSoup解析HTML获取链接的批量处理技巧。针对动态网页和反爬机制,提供了User-Agent模拟、Referer设置、IP池及Cookie管理等解决方案,并介绍了Selenium动态加载与Pyautogui模拟点击等进阶策略,帮助开发者高效完成图片抓取任务。
2026-10-15
5

本文详细汇总了Python下载网络图片的多种方法,涵盖从已知URL直接下载到通过正则表达式和BeautifulSoup解析HTML获取链接的批量处理技巧。针对动态网页和反爬机制,提供了User-Agent模拟、Referer设置、IP池及Cookie管理等解决方案,并介绍了Selenium动态加载与Pyautogui模拟点击等进阶策略,帮助开发者高效完成图片抓取任务。
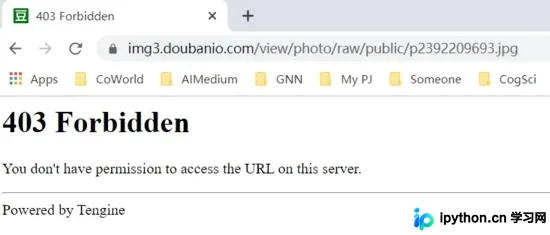
本文介绍如何使用Selenium结合PhantomJS模拟浏览器行为,以绕过豆瓣读书严格的反爬机制。针对直接请求导致的数据缺失和报错问题,通过模拟浏览器加载获取完整页面信息,并解析存储书籍数据。
本文介绍如何在Python爬虫中通过fake-useragent库生成随机User-Agent以绕过反爬机制。详细讲解安装方法、调用API获取特定浏览器UA及随机UA的代码示例,并提供手动维护UA列表的替代方案,帮助开发者模拟真实用户行为。
本文详细介绍了 PHP 进行网页数据采集时遭遇 IP 封禁的多种应对策略。核心方法包括伪装搜索引擎爬虫 User-Agent、伪造 Referer 来源、配置 HTTP 代理或 SOCKS 代理、模拟 X-Forwarded-For 头部,以及利用路由器重启获取新 IP 和修改 MAC 地址以规避更深层次的绑定限制。
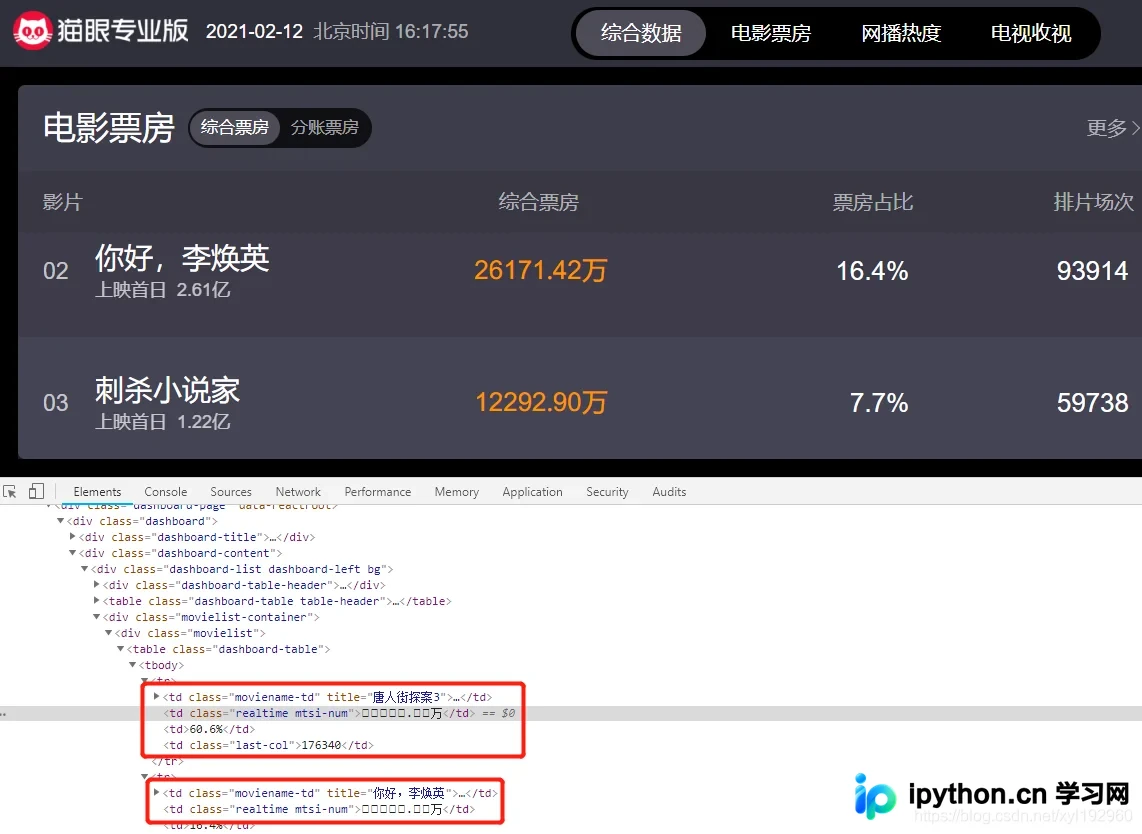
本文深入解析2021年猫眼票房页面的动态字体加密机制,通过Python实现反爬策略。核心思路是下载动态字体文件,利用fontTools提取字形坐标,计算线段斜率并进行差值比对。当斜率差小于0.5且样本数大于等于9时判定为同一数字,从而构建映射表替换乱码,获取真实票房数据。
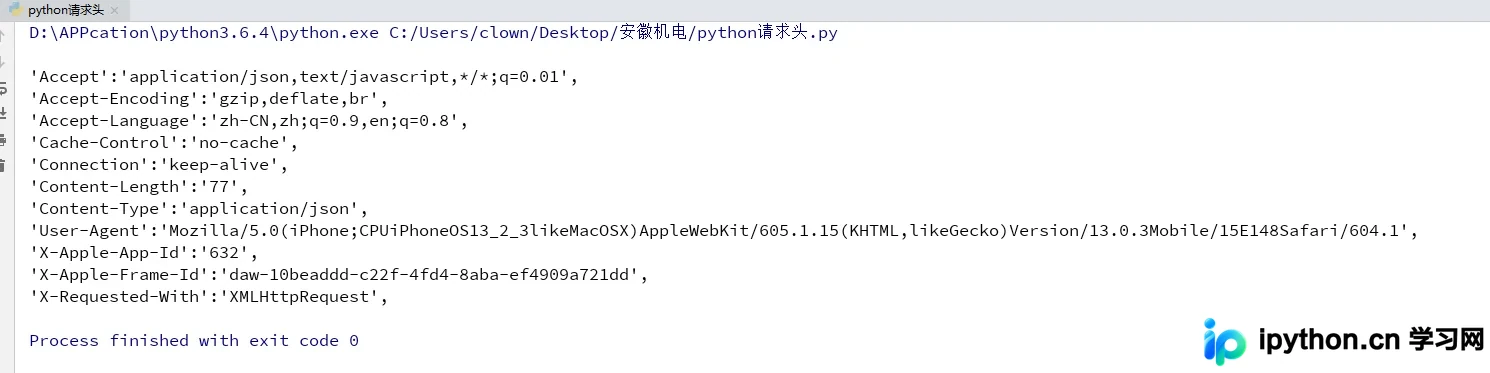
本文详解Python爬虫中Requests库设置Headers请求头的技巧。针对网页反爬限制,通过抓取浏览器真实请求头并模拟User-Agent等关键信息,有效绕过禁止爬取提示。文章提供从获取Headers到代码实现的完整步骤,帮助开发者解决爬虫访问被拒问题。
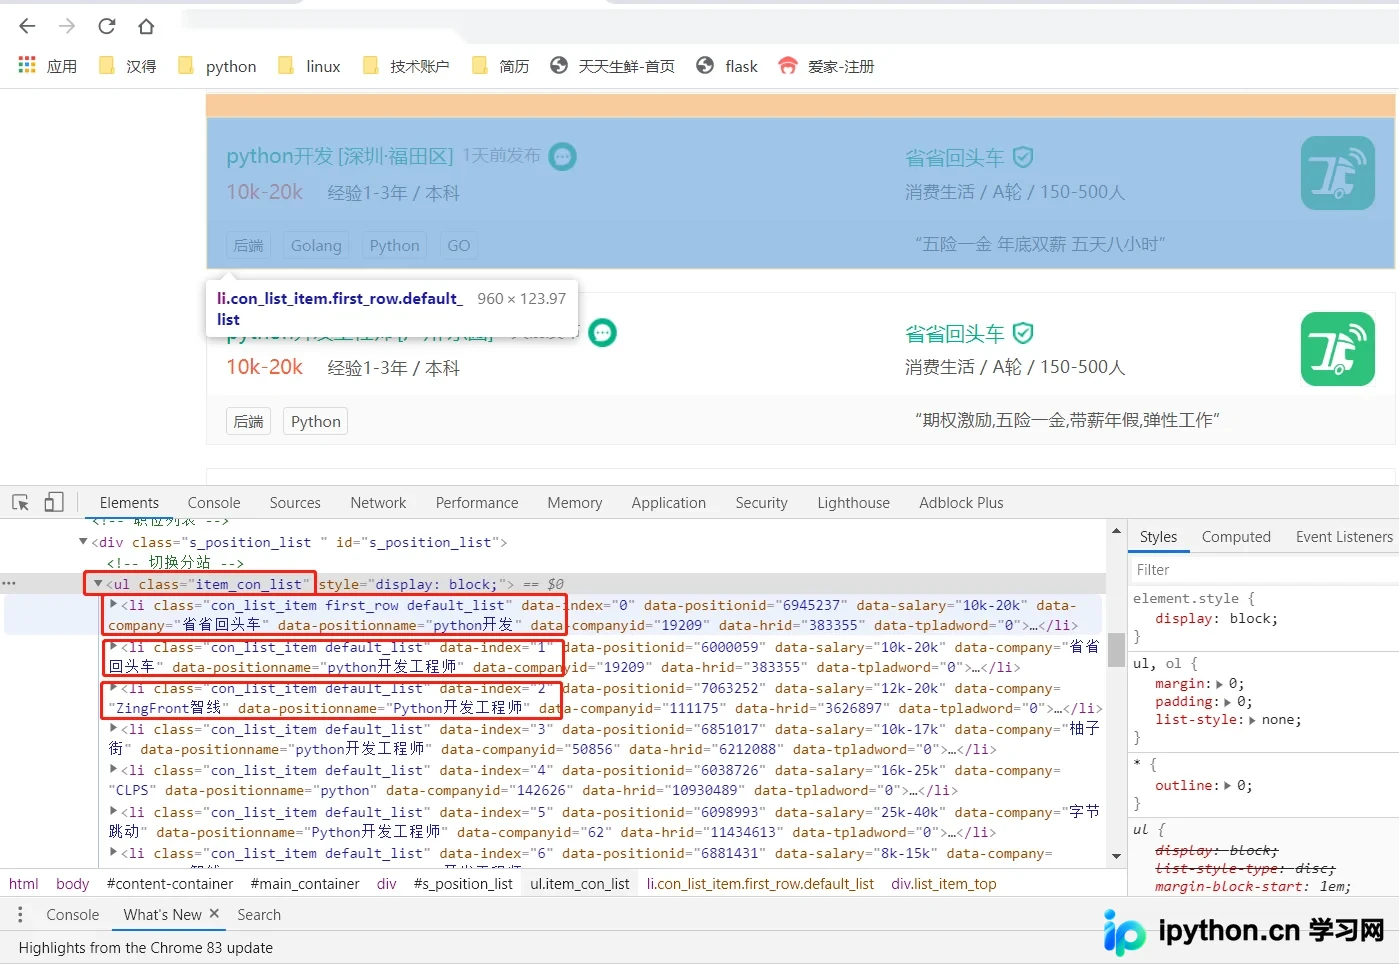
本文详细解析使用Scrapy框架爬取拉勾网Python相关职位信息的完整流程。从分析搜索结果页的Ajax请求入手,提取职位ID与ShowID,拼接详情页URL。针对反爬机制,通过携带Cookie和模拟POST请求解决访问限制,并配置随机User-Agent中间件。最终实现职位详情数据的自动化抓取与JSON存储,提供完整的代码实现与配置说明。
本文详解Python爬虫应对常见反爬策略的三种核心方案:通过维护代理IP池解决IP限制与验证码问题;利用time.sleep控制访问频率以规避限流;以及通过设置User-Agent和Referer头伪装浏览器身份。内容涵盖Requests与Urllib库的具体代码实现,帮助开发者提升爬虫稳定性。
本文介绍利用Python脚本自动操作家庭宽带路由器,通过断开并重新连接WAN口来动态获取新公网IP的方法。该方案适用于数据抓取中IP被限制的场景,无需搭建代理池。文章提供了针对TP-Link路由器的完整Python代码示例,包含获取当前IP、检测状态及执行断线重拨的逻辑,经测试可正常运行,帮助开发者实现自动化的IP轮换机制。
本文详细总结Python爬虫突破反爬虫机制的核心技术。内容涵盖构建合理的HTTP请求头、Cookie管理、访问延迟控制及代理IP使用。深入解析验证码(简单识别与人工打码)、IP封禁、滑动验证、防盗链关联上下文、JS运算及WebFont等常见反爬策略的应对方案,帮助开发者提升数据采集成功率。
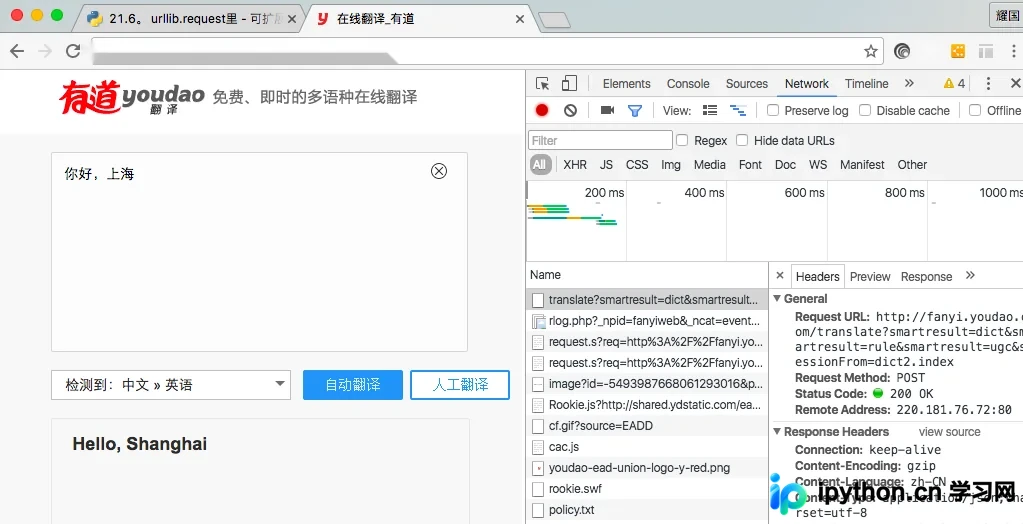
本文详解Python网络爬虫基础,重点讲解urllib模块的用法,包括获取网页源码、解析响应对象及实现有道翻译接口调用。针对服务器反爬机制,介绍了User-Agent伪装、访问延迟及代理IP设置等规避风险的方法,最后通过煎蛋网案例演示如何批量下载网络图片。
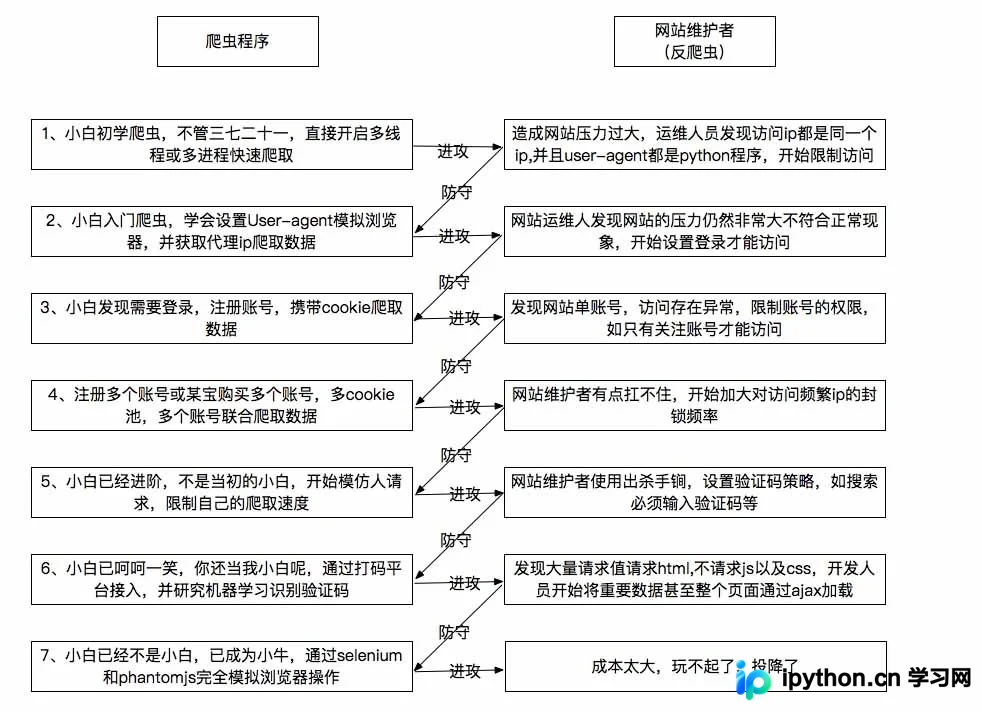
本文深入解析Python爬虫与反爬虫的对抗机制,涵盖自动获取数据原理、常见反爬策略如IP封禁的成本与误伤风险,以及数据保护与商业竞争背景下的防御目的。通过梳理实战中的攻防策略,帮助开发者理解如何在获取数据与防止滥用之间取得平衡,适用于Python及相关技术栈的开发者参考。