PandasAI连接大语言模型对MySQL数据库进行跨表数据分析
本文演示如何使用PandasAI 3.0连接阿里云百炼平台的DeepSeek大模型,对接MySQL数据库中的多表业务数据。通过配置LiteLLM参数与正确放置列描述信息,实现跨表的自然语言交互式查询,并详细列出实际开发中需注意的语法细节与版本差异。
2026-10-10
29

本文演示如何使用PandasAI 3.0连接阿里云百炼平台的DeepSeek大模型,对接MySQL数据库中的多表业务数据。通过配置LiteLLM参数与正确放置列描述信息,实现跨表的自然语言交互式查询,并详细列出实际开发中需注意的语法细节与版本差异。
本文介绍在Python中将字典的复合键拆分为多个独立键值对的方法。通过对比使用普通for循环与列表解析(List Comprehension)两种实现方式,展示了如何利用字典特性高效处理以分号分隔的键名,并生成目标数据结构。
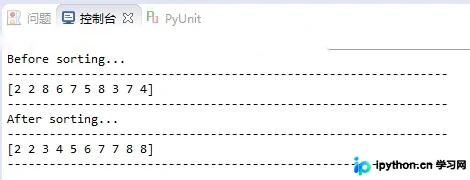
本文深入解析Python中堆排序算法的实现原理,通过构建小顶堆并逆向遍历输出元素,展示如何高效完成排序。文章包含完整的Python代码示例,利用NumPy处理数据,详细讲解MakeHeap与AdjustHeap函数的逻辑,帮助开发者理解堆排序的核心机制与具体用法。
掌握Python数据可视化工具能快速提炼业务规律。本文以Matplotlib和Seaborn为核心,详解折线图、柱状图、散点图等基础图表及箱线图、热力图等高级图表的生成代码,结合Pandas内置绘图功能与多子图布局,提供完整可运行示例,帮助初学者快速搭建数据可视化工作流。
本文详解Python中列表(list)与元组(tuple)的核心特性与操作方法。列表作为可变序列,支持append、extend、insert、pop、remove及排序等丰富操作;元组作为不可变序列,需通过list()与tuple()函数进行类型转换以实现修改。文章提供完整的代码示例与操作验证,帮助开发者掌握两种内置数据类型的最佳实践。
本文介绍如何利用Python内置的http.server模块快速搭建本地HTTP服务器。无需安装Apache等复杂软件,只需在命令行执行特定命令即可共享目录。文章详细说明了Windows和Linux下的环境准备、默认端口8000的使用、指定端口的方法,以及Python 2与3版本中命令的差异和服务器停止操作。
本文详细介绍高级 Python Web 框架 Django 的核心特性与标准开发流程。涵盖从虚拟环境创建、框架安装、项目初始化,到数据模型定义、数据库迁移、视图编写、URL 路由配置及模板渲染的完整操作步骤。同时提供开发服务器启动验证方法,以及解决端口冲突和连接 MySQL 数据库的实用方案,帮助开发者快速掌握 Django 基础应用构建。
针对Python代码运行缓慢的问题,本文提供了从性能诊断到实际加速的完整操作流程。通过内置分析工具精准定位耗时模块,结合哈希表特性替换线性查找结构,应用缓存装饰器消除冗余计算,并调用多进程池绕过解释器限制以释放多核算力。所有方案均附带可直接运行的标准代码示例,适用于数据处理与自动化脚本等常见开发场景。
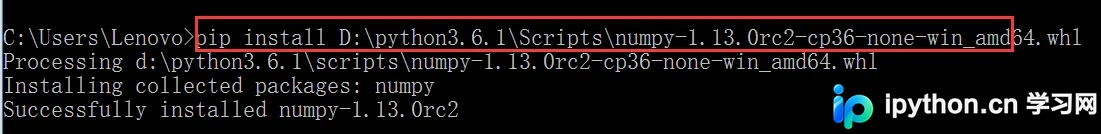
本文详细介绍如何在 Windows 环境下通过本地 .whl 文件离线安装 Python 科学计算库 NumPy、Matplotlib 和 SciPy。通过 Win+R 打开 CMD,利用 pip install 命令指定本地路径即可完成安装,适用于无网络或网络受限的开发环境。
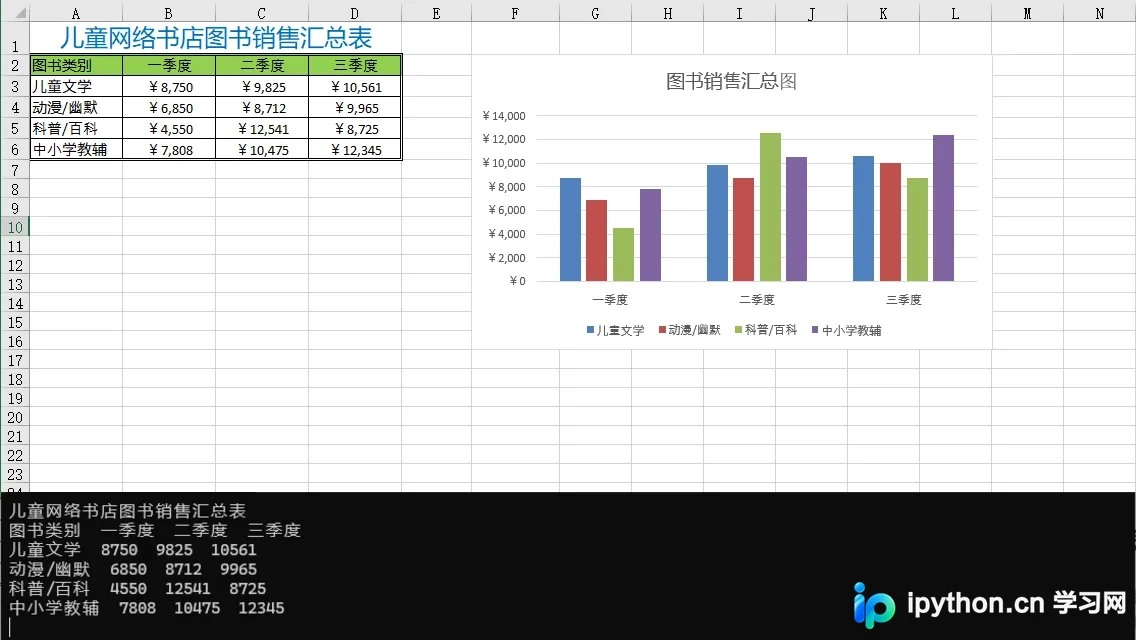
本文介绍如何使用Python的Spire.XLS库高效处理Excel图表。通过加载工作簿获取图表对象,利用DataRange属性自动提取隐藏的数据源范围;结合Width与Height属性批量修正遮挡或过小的图表尺寸;通过LeftColumn等定位参数精准重置图表布局;并使用Remove方法一键清理冗余图表。无需依赖本地Office软件即可实现自动化模板维护与报告优化。
配置Python环境时遭遇第三方库安装失败,多因底层依赖声明与当前解释器版本发生冲突。掌握精准的兼容性核查手段能大幅降低排错成本,本文将围绕pip命令行检索、PyPI官方文档核对、Conda生态隔离管理及自定义校验脚本展开实操演示,助您快速锁定可用版本并完成稳定部署。
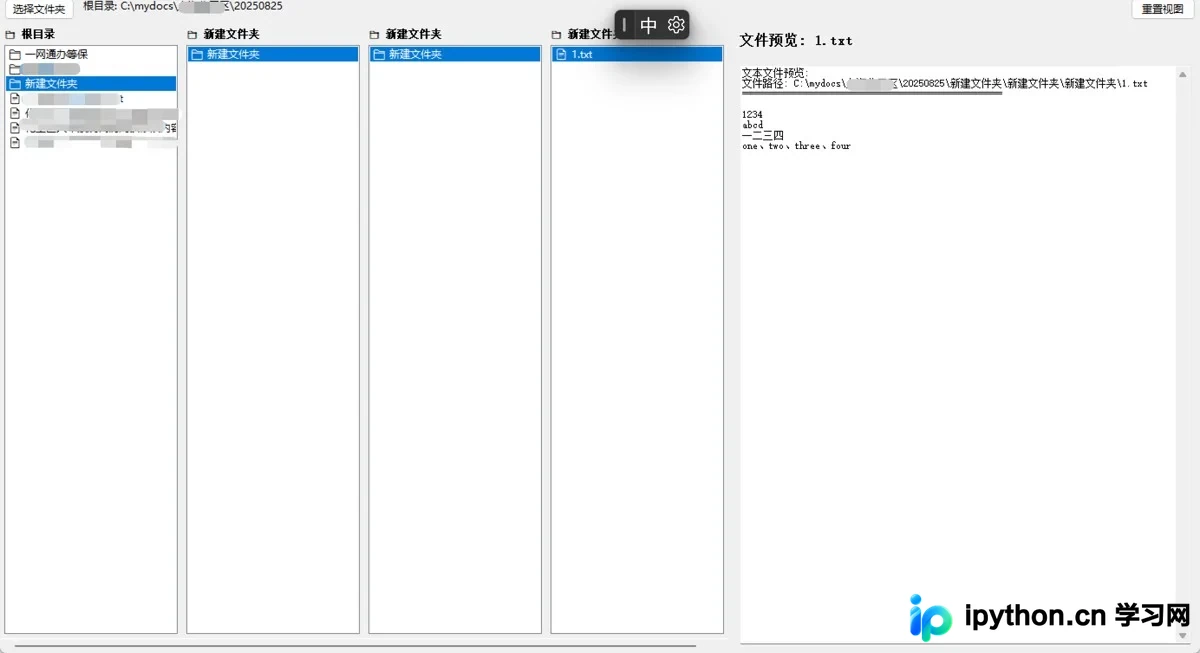
本文详细解析如何使用 Python 的 wxPython 库构建类似云盘的多层级水平文件夹浏览界面。通过动态创建与销毁 ListBox 面板、闭包事件绑定及懒加载策略,实现自动层级管理、智能滚动与基础文件预览,兼顾内存优化与交互体验。