详解Python如何利用Shelve进行数据存储
介绍Python标准库shelve模块的存储原理、核心用法及注意事项。通过字典式API演示数据的创建、读写、更新与删除操作,并附带命令行待办事项应用示例。适合小型配置管理、本地缓存及轻量级数据库场景,同时说明其并发限制与内存占用问题,帮助开发者快速搭建文件级数据持久化方案。
2026-10-11
26

介绍Python标准库shelve模块的存储原理、核心用法及注意事项。通过字典式API演示数据的创建、读写、更新与删除操作,并附带命令行待办事项应用示例。适合小型配置管理、本地缓存及轻量级数据库场景,同时说明其并发限制与内存占用问题,帮助开发者快速搭建文件级数据持久化方案。
本文介绍在 Python 中实现函数定时轮询执行的两种常见方式:利用 threading.Timer 创建子线程循环,以及使用 time.sleep 阻塞主线程。通过代码示例对比两者的资源消耗与实现逻辑,帮助开发者根据场景选择合适的方案。
数据重采样是处理机器学习类不平衡问题的关键技术。通过调整数据集样本分布,可防止模型偏向多数类。本文将详解SMOTE等核心原理,并提供基于Python imblearn库的操作代码,帮助开发者快速构建平衡数据集以提升模型训练效果。
本文介绍如何在 Python 中实现一行输入多个数字或字符串。通过结合 input()、split() 和 map() 函数,可以高效地将空格或逗号分隔的输入转换为整数或字符串列表。此外,还演示了利用 int(x, 2) 进行二进制转十进制的实际应用案例。
本文详细介绍如何使用Flask轻量级框架构建标准的RESTful API。从环境配置到项目初始化,再到GET、POST、PUT、DELETE等核心路由的编写与JSON响应处理,逐步演示完整的增删改查接口开发流程。附可直接运行的代码模板,帮助开发者快速掌握Flask后端服务开发规范。
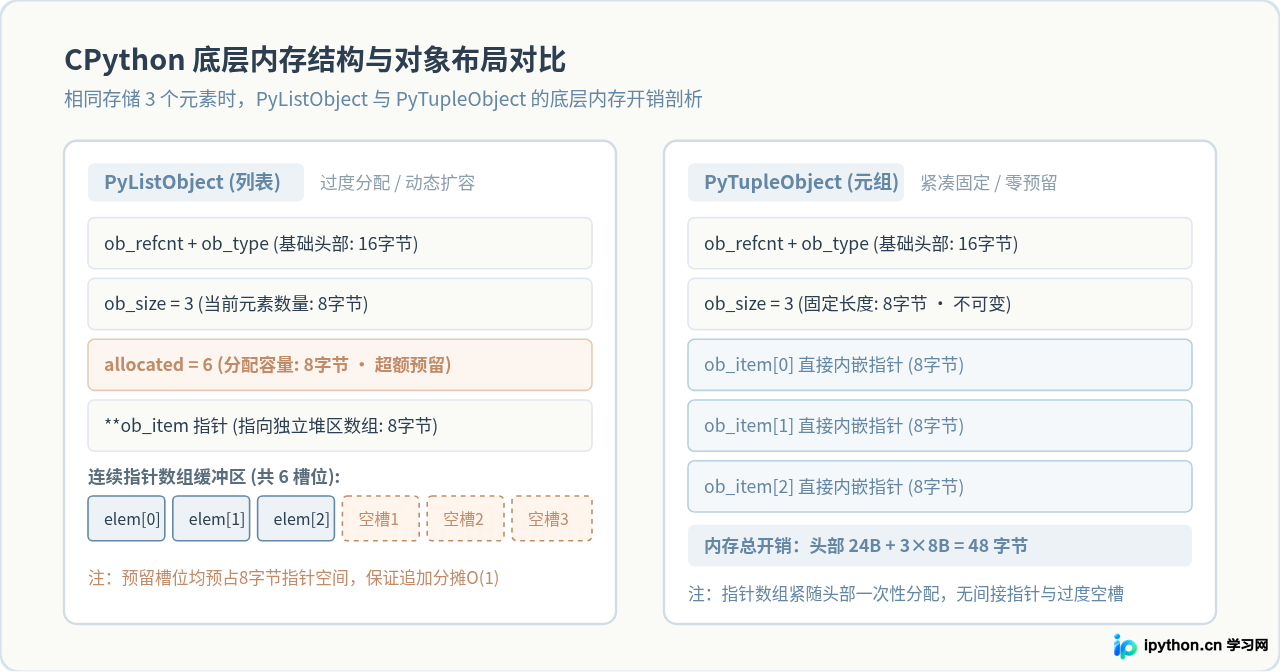
深入对比Python中元组(tuple)与列表(list)的运行速度与内存占用差异,从CPython底层实现、过度分配算法、常量折叠与Free List缓存机制剖析性能差异根源,并提供详细的选型实践指南。
本文总结Django框架中获取form表单数据的多种方法。重点讲解如何判断POST请求,以及针对文本、密码、单选、多选、下拉框等不同HTML表单元素,使用request.POST.get()和getlist()进行数据提取的具体操作与注意事项。
本文详解如何使用 Python 的 csv 模块读取 CSV 格式的电子表格数据。通过 DictReader 将数据行转换为有序字典,实现按字段名访问。同时结合 random 模块的 randrange 函数,演示如何从数据列表中随机抽取记录,适用于抽奖或样本选取场景。
函数式编程以函数为核心,强调无副作用与不可变数据。Python虽为多范式语言,但提供了丰富的函数式工具。本文系统梳理第一类函数、lambda表达式、列表推导式及map、filter、reduce等内置高阶函数的实际应用,通过修正典型代码示例演示如何编写简洁、易测试且可复用的数据处理逻辑,帮助开发者在数据转换与管道构建场景中有效提升代码质量。
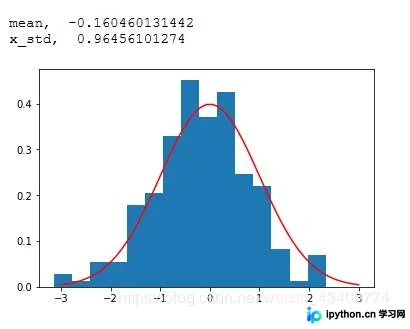
本文详解如何在Python中利用scipy.stats库实现最大似然估计(MLE)。通过norm模块演示正态分布参数的MLE计算与可视化,并解析hypergeom模块中超几何分布累计概率函数的参数含义,涵盖从环境配置到代码验证的完整流程。
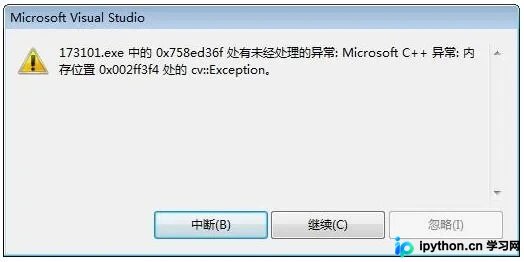
在使用OpenCV和Python进行图像处理时,cv2.imshow窗口经常闪退。本文详细解析了闪退原因,通过引入cv2.waitKey()函数解决该问题,并提供了完整的代码示例和调试建议。
本文介绍如何修改 Jupyter Notebook 的默认工作目录,以及解决 Linux 环境下以 Root 用户运行 Notebook 时的权限警告。通过修改快捷方式目标路径、生成配置文件并调整 allow_root 参数,可快速完成环境配置。