

使用Pandas进行Excel数据处理的操作和技巧
本文针对Excel数据批量处理效率低的问题,提供基于Python Pandas库的标准操作流程。通过读取指定工作表与表头、过滤筛选特定行列、填补缺失值及转换日期数值类型完成数据清洗;结合分组聚合多维透视与排序排名进行核心分析;最后输出处理后的DataFrame至新文件中。掌握这些方法可显著提升数据分析自动化水平。
2026-10-11
37

本文针对Excel数据批量处理效率低的问题,提供基于Python Pandas库的标准操作流程。通过读取指定工作表与表头、过滤筛选特定行列、填补缺失值及转换日期数值类型完成数据清洗;结合分组聚合多维透视与排序排名进行核心分析;最后输出处理后的DataFrame至新文件中。掌握这些方法可显著提升数据分析自动化水平。
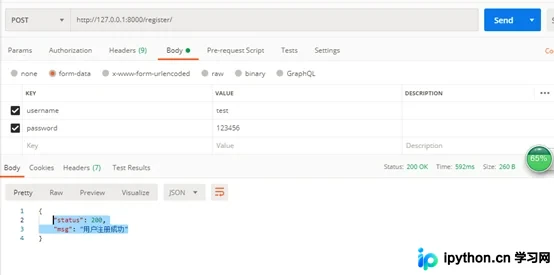
本文介绍如何使用 Django 和 REST framework 构建用户注册 API。通过配置项目、编写视图类处理 POST 请求、创建数据库模型以及配置路由,实现用户数据的存储与返回。文章包含完整的代码示例、CSRF 处理方案及测试方法,帮助开发者快速掌握 Django API 开发流程。
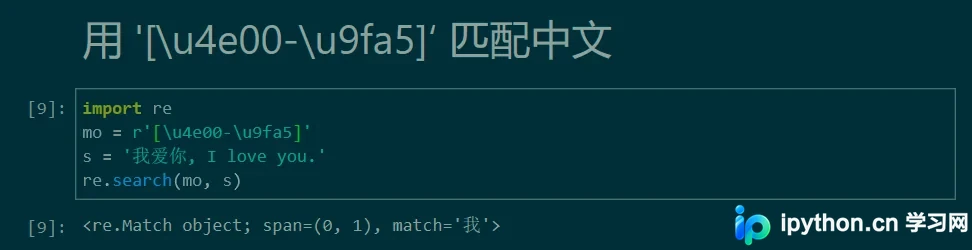
本文详细解析Python中正则表达式匹配中文的核心原理,重点讲解 `\u4e00-\u9fa5` 编码范围的使用。通过 re 模块的 `search` 和 `findall` 方法,演示如何精准提取单个中文字符、连续中文片段及所有中文内容。文章涵盖字符集范围说明及编码注意事项,帮助开发者解决跨语言文本处理中的匹配难题。
本文介绍在Pandas中将单列数据按分隔符拆分为多列的多种方法。通过str.split()结合expand参数、索引提取或解包赋值,可高效完成数据清洗。同时涵盖处理列表数据及生成测试数据的技巧,帮助开发者快速实现列拆分操作。
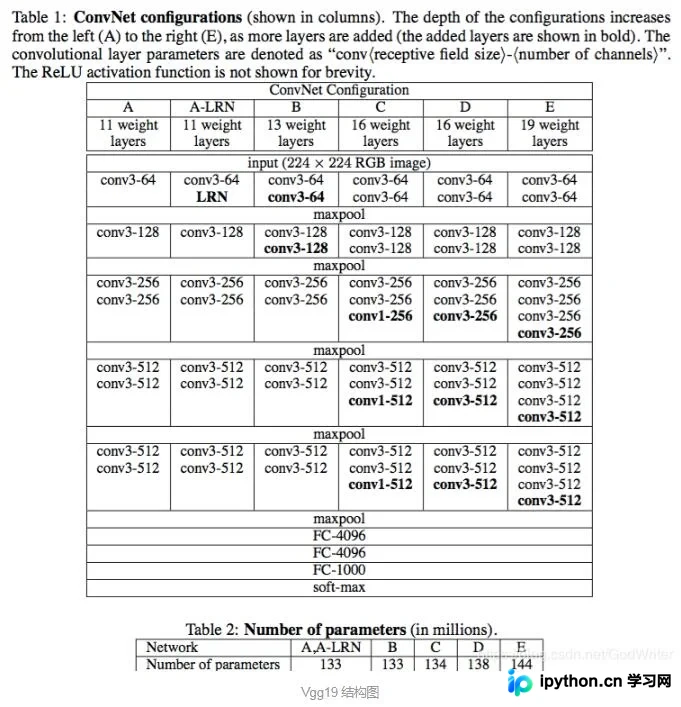
本文介绍如何在 TensorFlow 1.x 环境下加载 VGG19 预训练模型。通过解析 .mat 文件提取卷积核与偏置,构建 VGG19 网络类,并实现前向传播以获取各层特征图。文章包含环境配置、代码实现及测试流程,适用于风格迁移、目标检测等计算机视觉任务。
Python集合基于哈希表结构天然支持唯一性约束,是执行数据去重与集合比对的底层利器。通过掌握集合的创建语法、交并差运算符以及增删查方法,开发者可快速清洗冗余数据并验证元素存在性。本文梳理标准操作路径与性能特征,提供可直接复用的代码示例与工程避坑建议。
本文介绍如何在Keras中使用Tensorflow后端限制GPU显存使用量。通过配置tf.GPUOptions和tf.ConfigProto,可以精确控制Keras进程占用的显存比例,避免显存溢出。
本文详细介绍 Python 项目中使用 Pipenv 管理虚拟环境的完整流程。涵盖工具全局安装、环境创建与激活、依赖包的精细化安装更新卸载,以及 Pipfile 与 requirements.txt 的双向转换方法,帮助开发者快速实现多项目依赖隔离、版本控制与标准化自动化部署。
本文介绍在 Django 中将数据库查询结果(QuerySet)封装为字典的三种常用方法。包括使用 `model_to_dict` 进行模型序列化、利用 `serializers` 模块生成 JSON 数据,以及通过自定义游标函数将原始查询结果转换为字典列表。文章提供了具体的代码示例和操作步骤,帮助开发者灵活处理数据库返回数据。
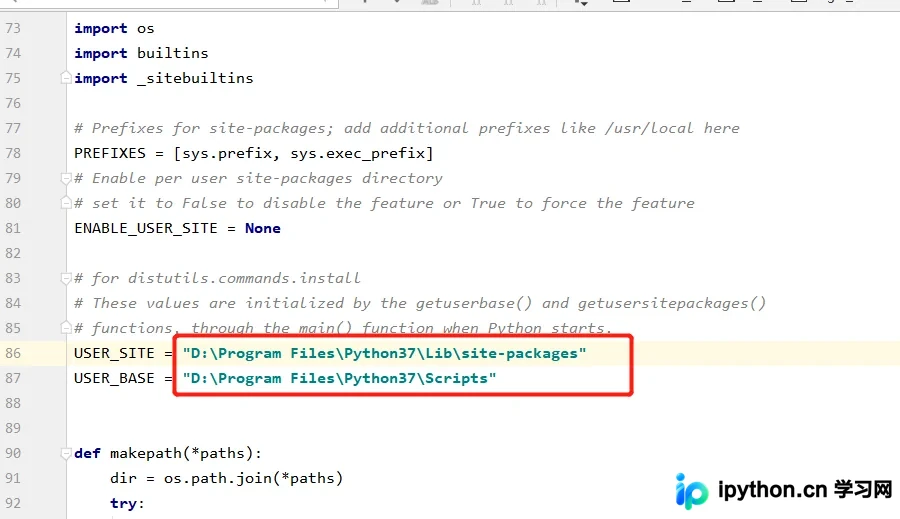
本文介绍如何通过修改Python的site.py文件来更改pip install的默认下载路径。通过查看USER_SITE和USER_BASE,可以了解当前依赖包和脚本的安装位置,进而修改site.py文件中的路径设置,实现自定义安装目录。
针对Python列表中频繁按对象属性值进行查找的场景,传统遍历需O(n)时间。通过预先构建属性值到索引或对象的哈希映射字典,可将单次查询时间复杂度降至O(1)。本文详细说明空间换时间的构建逻辑、完整代码示例、重复值处理及动态更新策略。
本文介绍在 Django 中创建超级用户时如何指定添加额外字段。默认情况下,`createsuperuser` 命令仅要求输入用户名、邮箱和密码。通过 `manage.py shell` 进入脚本,可以使用 `User.objects.create_superuser()` 方法,并传入额外的关键字参数来指定其他字段。此外,还涉及数据库配置及常见报错处理。