

Python urlparse模块核心功能与使用详解
本文详解Python中urlparse模块的常用方法。介绍urlparse、urlsplit如何解析URL为协议、域名、路径等组件,以及urlunparse和urlunsplit的重组用法。同时说明urljoin处理相对地址的技巧,并展示如何提取hostname、port等附加属性,助力开发者高效处理网络链接。
2026-10-13
23

本文详解Python中urlparse模块的常用方法。介绍urlparse、urlsplit如何解析URL为协议、域名、路径等组件,以及urlunparse和urlunsplit的重组用法。同时说明urljoin处理相对地址的技巧,并展示如何提取hostname、port等附加属性,助力开发者高效处理网络链接。
本文深入解析Python中浮点数运算的精度问题。由于二进制无法精确表示部分十进制小数,导致计算结果存在微小误差。文章通过实例说明直接使用“==”比较浮点数的风险,并推荐采用判断差值是否小于极小量(epsilon)的安全比较方法,帮助开发者避免潜在的逻辑错误。
本文详细解析利用Python进行十进制小数与二进制小数相互转换的实现方法。通过“乘2取整”算法将十进制小数转为二进制,以及按权展开求和法将二进制小数还原为十进制。文中提供核心代码逻辑与具体数值演算示例,帮助开发者深入理解浮点数底层表示及转换逻辑。
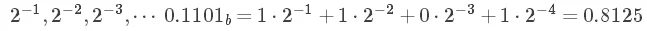
本文详细介绍使用Python实现遗传算法的核心代码结构。通过定义Chromosome类封装染色体与适应度,并利用字典管理种群个体,实现了直观的对象化编程。文章解析了Genetic与Fitness模块中的关键函数,包括初始化、交叉、变异及最优解查找逻辑,并提供了完整的迭代优化与可视化示例,帮助开发者快速掌握遗传算法的工程实现。
本文详细介绍如何使用Python2编写贴吧图片爬虫。通过安装Lxml库并利用Chrome插件辅助分析HTML结构,利用XPath精准定位图片链接。文章包含完整代码示例及注释,指导开发者从环境搭建到代码运行,实现批量下载指定贴吧的图片资源。
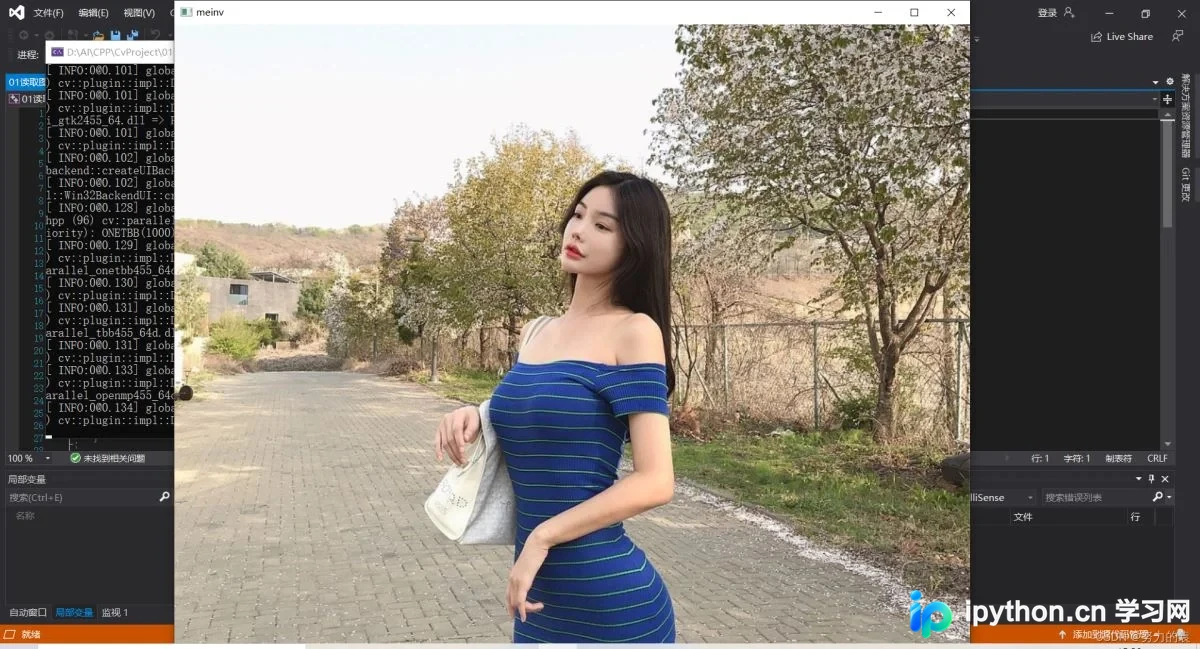
本文介绍在C++中使用OpenCV库读取本地图片、显示窗口以及访问图像数据的基本方法。通过imread加载图片后,利用ptr函数按行获取像素指针,深入理解内存布局与颜色通道输出。代码包含完整的环境配置、错误检查逻辑及像素遍历示例,附带运行结果展示。
本文介绍在Python中获取当前文件所在目录、父级目录以及规范绝对路径的方法。通过os模块中的path.dirname和path.abspath函数,可以方便地处理文件路径操作,适用于需要动态获取文件位置的场景。
Python标准库处理时间复杂且模块分散,arrow库提供了更优雅的智能方式。本文介绍arrow的安装方法及核心功能,包括获取当前时间、调整与修改时间、时区转换、文本解析为时间对象、获取时间戳及格式化输出,并展示如何转换为标准库对象,帮助开发者高效处理时间数据。
本文介绍Python中模拟大文件分割及多线程处理的实现方法。通过自定义任务类与线程类,利用队列机制分配文件分片处理任务,实现并发执行。代码展示了如何创建线程池、提交任务并等待完成,适用于需要提升文件处理效率的场景。
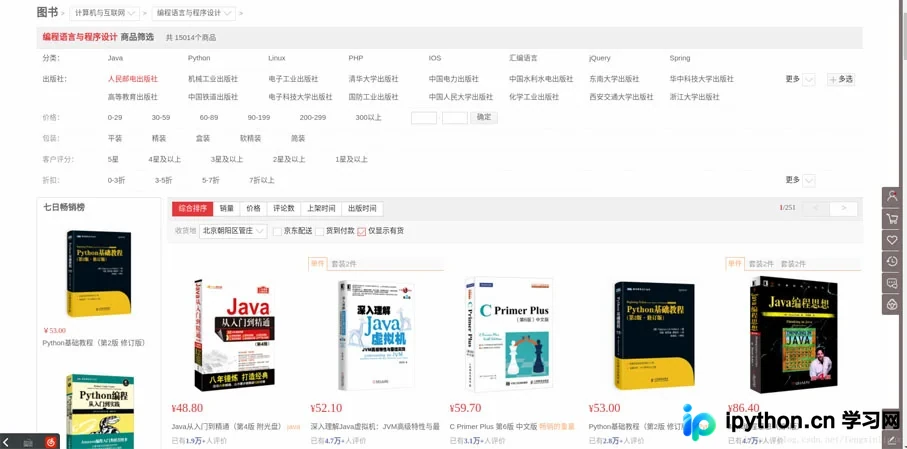
本文详细介绍如何利用Python 3编写图片爬虫,从京东网站批量下载编程类图书封面。通过解析URL分页规律,结合正则表达式对HTML源码进行两次过滤,精准提取商品图片链接,并使用urllib库实现本地存储。文中包含完整代码示例及异常处理逻辑,适用于学习网络爬虫基础与数据抓取技术。
本文通过60MB、392660行的测试文件,对比了Python读取文件的三种方式:readlines()、文件迭代器和readline()循环。结果显示,使用with open结合迭代器的程序二耗时最短(约0.74秒),优于readlines()和readline()循环,推荐在大文件处理中采用迭代方式以提升效率。
本文介绍Python中处理大txt文件的三种逐行读取与分割方法。通过示例代码展示如何利用readline、迭代器及readlines配合内存限制策略,实现高效的数据分割。重点解析不同方法在内存占用和执行效率上的差异,帮助开发者根据实际场景选择合适的文件处理方案,避免内存溢出问题。