

Python爬虫实战:基于维基百科的六度分隔遍历算法
本文详解如何使用Python编写爬虫程序,通过BeautifulSoup解析HTML并配合正则表达式过滤有效词条链接,实现维基百科“六度分隔理论”的自动化遍历。文章涵盖链接提取、随机路径生成及随机数种子设置等核心步骤,旨在帮助开发者理解单域名遍历爬虫的基本逻辑与注意事项。
2026-10-13
19

本文详解如何使用Python编写爬虫程序,通过BeautifulSoup解析HTML并配合正则表达式过滤有效词条链接,实现维基百科“六度分隔理论”的自动化遍历。文章涵盖链接提取、随机路径生成及随机数种子设置等核心步骤,旨在帮助开发者理解单域名遍历爬虫的基本逻辑与注意事项。
本文介绍如何使用Python实现高斯迭代法求解线性方程组。通过定义Gauss函数,传入系数矩阵mx、值矩阵mr及迭代次数n,程序利用列表模拟矩阵进行行优先计算。示例展示了从初始化零向量到循环更新解向量的完整过程,适用于需要数值解的工程场景。
本文介绍如何使用Python的sympy库和Matlab进行定积分计算。通过对比sin(2*x)/(1+x^2)在0到3区间的计算结果,探讨符号积分无法得出理论解的情况,并展示Matlab中符号计算与数值积分两种处理方式的区别。
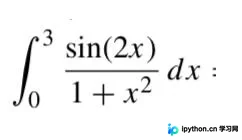
本文详细解析Python中pandas模块的核心用法,涵盖Series与DataFrame的创建、属性获取及多种索引方式。通过实例演示字典、数组等数据源的转换,深入讲解loc、iloc等高级索引技巧,并指出ix方法的弃用情况,帮助开发者掌握高效的数据处理技能。
本文详细介绍 C# 中 System.Collections 命名空间下的 ArrayList 动态数组。涵盖核心方法如 Add、AddRange、Remove、BinarySearch 等的使用场景与语法,通过完整代码示例展示元素的插入、移除、查找及遍历流程,帮助用户快速掌握非泛型集合的基本操作。
本文介绍Python爬虫在抓取网站内链时识别页面类型的三种核心方法:通过URL结构判断、检测特定HTML字段存在性、以及利用DOM标签定位。同时深入讲解Python面向对象设计,通过基类与子类继承机制,实现不同页面类型(如产品页、文章页)的数据结构复用与扩展,提升爬虫代码的可维护性。
本文详细解析C语言中矩阵乘法的实现原理,涵盖基本三重循环算法及针对内存访问优化的改进版本。同时深入讲解斯特拉森(Strassen)算法如何通过减少乘法次数提升4阶及以上矩阵的计算效率,并提供完整的2x2与4x4代码示例,帮助开发者掌握高性能矩阵运算的核心技巧。
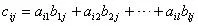
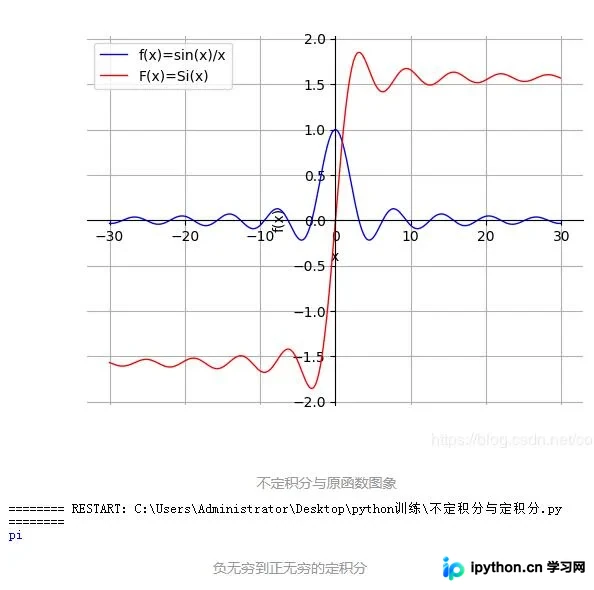
本文介绍如何利用Python的SymPy库求解sin(x)/x函数的不定积分与定积分。代码演示了如何定义符号变量、计算不定积分(结果为Sine Integral函数)以及计算负无穷至正无穷的定积分(结果为pi),并包含绘图可视化部分。
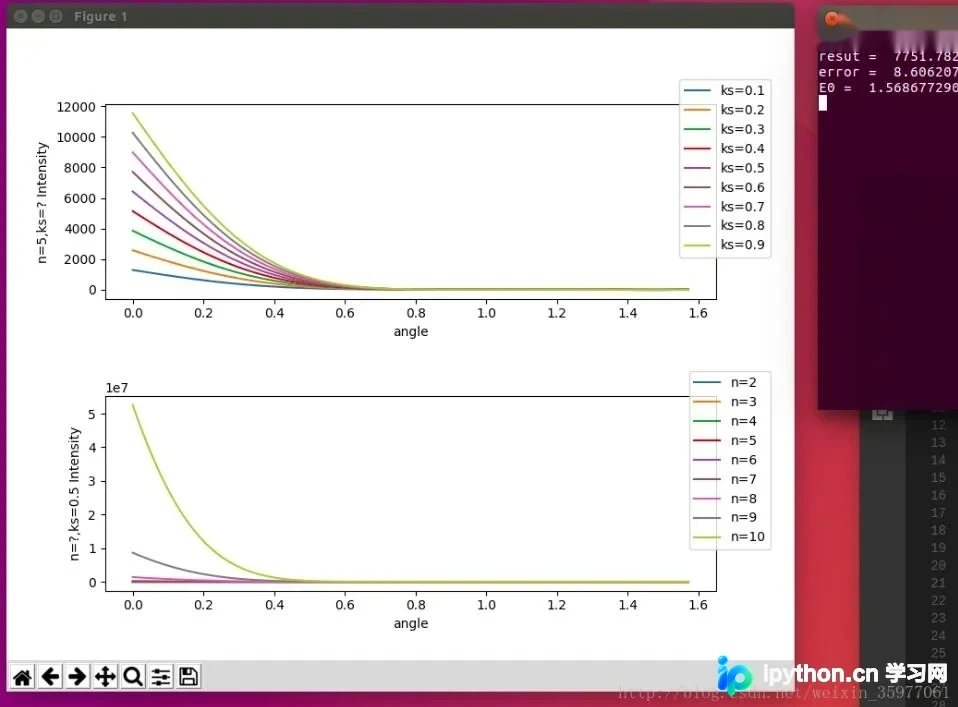
本文介绍在Ubuntu环境下使用Python 3.5进行超越函数积分运算及结果可视化的方法。通过numpy和scipy库计算理想平面辐射强度,并利用matplotlib绘制二维分布图。重点解析plt.subplots_adjust对子图间距的调整,提供完整代码参考。
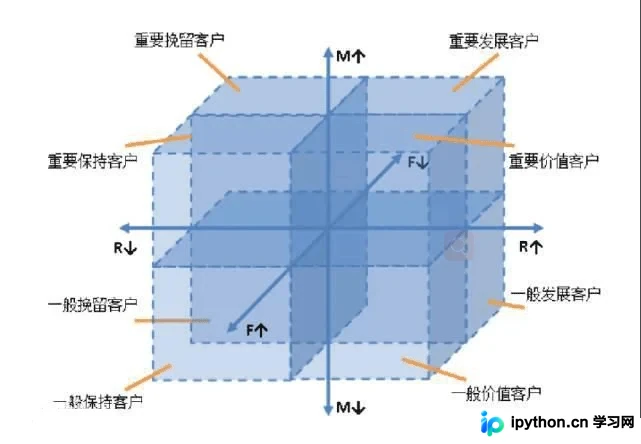
本文详解基于Python pandas构建RFM模型的全过程。涵盖数据预处理、R/F/M指标标准化与分级、K-means聚类划分高价值及挽留客户,以及利用AHP层次分析法进行加权打分。通过实际代码示例,展示如何从原始交易数据中提取客户特征并实现精细化运营策略。
本文详细解析PHP中__clone()魔术方法的使用。通过对比普通赋值与clone关键字,阐明对象克隆的基本原理。重点讲解在对象包含其他对象成员时,如何通过重写__clone()实现深拷贝,避免引用共享导致的意外修改,并提供实际代码示例进行验证。
本文深入解析Python进行接口测试的必要性。相比传统UI测试,接口测试能绕过前端限制发现深层Bug,验证系统异常处理与安全性(如SQL注入防护),并支持后端快速迭代。通过自动化接口测试,可显著降低人力成本,缩短测试周期,确保前后端分离架构下的业务逻辑正确性。