

Python pandas实现RFM模型:从数据预处理到客户分层详解

本文详解基于Python pandas构建RFM模型的全过程。涵盖数据预处理、R/F/M指标标准化与分级、K-means聚类划分高价值及挽留客户,以及利用AHP层次分析法进行加权打分。通过实际代码示例,展示如何从原始交易数据中提取客户特征并实现精细化运营策略。
本文通过具体实例展示如何利用Python pandas库构建和应用RFM模型,旨在为读者提供可参考的技术方案。
RFM模型概述
依据美国数据库营销研究所Arthur Hughes的研究,客户数据库中存在三个关键要素,它们构成了数据分析中最有效的指标体系:
- 最近一次消费 (Recency, R):指客户最近一次交易距离当前的时间间隔。R值越大,表明客户交易距今越久;反之,R值越小则代表交易越近期发生。
- 消费频率 (Frequency, F):指客户在特定时间段内的交易次数。F值越大,说明客户交易越频繁,活跃度越高;反之则活跃度较低。
- 消费金额 (Monetary, M):指客户在特定时间段内的累计交易金额。M值越大,代表该客户的商业价值越高;反之则价值较低。
RFM模型实践应用
前提假设验证
应用RFM模型基于一个核心前提假设:R、F、M值越高,客户价值越大,其未来为企业创造的价值也越大。这一假设已通过大量研究和实证得到支持,
但为确保模型在特定案例中的有效性,本文进一步进行了严谨的前提假设验证:
具体验证过程如下:
注:Frequency(消费频率)与Monetary(消费金额)均基于近6个月(1月至6月)的数据进行计算。
通过相关性检验来验证以下假设:
- 最近购买产品的用户,产生下一次消费行为的概率更高。
- 消费频次较高的用户,通常满意度与忠诚度较高,更倾向于再次消费。
- 消费金额较高的用户,更容易带来高额的后续消费行为。
RFM指标分级
一种简便方法是将R、F、M三个指标的均值作为划分阈值,高于均值的定义为高价值,低于均值的定义为低价值,从而将客户划分为8个类别。
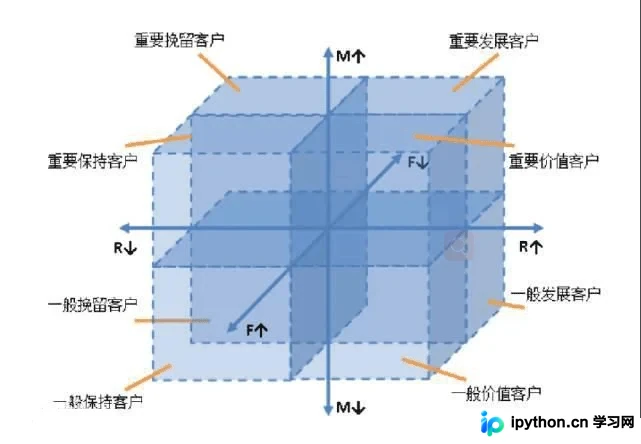
本文采用的方法是对三个指标进行标准化处理,随后按分位数划分为5个等级,数值越大代表价值越高。最终划分规则需结合具体业务场景确定。划分为5个等级后,理论上可将客户细分为125种组合。
#读取数据
rfm<-read.csv('~/desktop/rfm1_7.csv',header=TRUE)
summary(rfm)
#数据分布
par(mfrow=c(1,3))
boxplot(rfm$rankR1)
boxplot(rfm$rankF1)
boxplot(rfm$rankM1)
#rfm分级
breaks1<-quantile(rfm$Recency, probs = seq(0, 1, 0.2),names = FALSE)
breaks1<-c(1,14,30,57,111,181) #以流失用户的定义来设置分级 30天以上为流失用户
breaks2<-quantile(rfm$Frequency, probs = seq(0, 1, 0.2),names = FALSE)
breaks2<-c(1,2,3,6,14,164)
breaks3<-quantile(rfm$Monetary, probs = seq(0, 1, 0.2),names = FALSE)
rfm$rankR1<- cut(rfm$Recency,breaks1, 5,labels=F)
rfm$rankR1<- 6-rfm$rankR1
rfm$rankF1<- cut(rfm$Frequency,breaks2, 5,labels=F)
rfm$rankM1<- cut(rfm$Monetary,breaks3, 5,labels=F)
客户分类
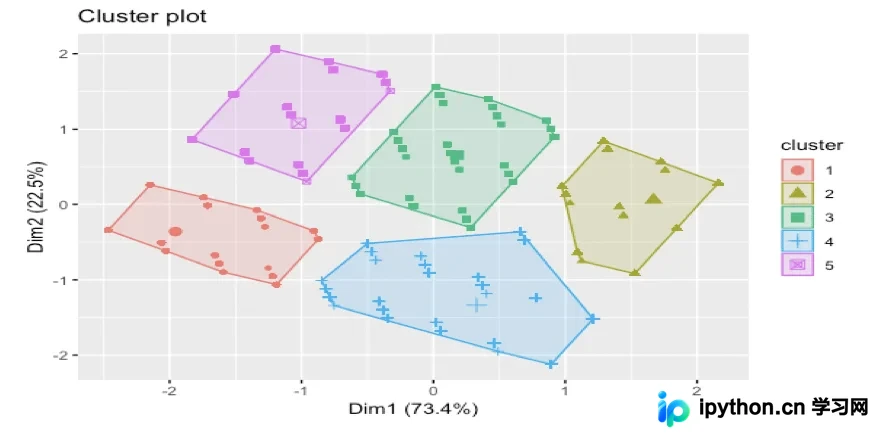
本文使用K-means聚类算法对客户进行分类,并结合业务逻辑将聚类结果归纳为4大类:
- Cluster 1:价值用户,其R、F、M三项指标均处于较高水平。
- Cluster 2与3:用户贡献值最低,且用户近度(小于2)和频度较低,被判定为无价值客户。
- Cluster 4:发展用户,虽然频度和值度较低,但用户近度较高,适合进行向上营销(up marketing)。
- Cluster 5:挽留客户,用户近度较低,但频度和值度较高,需采取专门的挽留措施。
关于K值的选择:
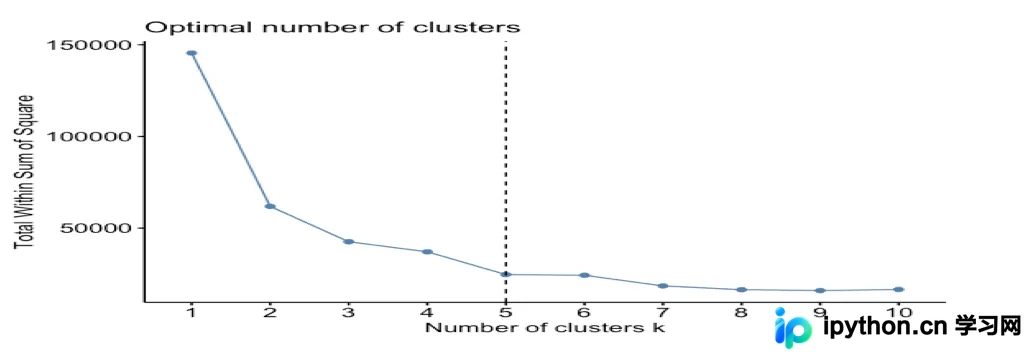
具体的聚类结果展示如下:
#聚类
df<-rfm[,c(6,7,8)]
p1<-fviz_nbclust(df, kmeans, method = "wss")
p2<-p1 + geom_vline(xintercept = 5, linetype = 2)
km_result <- kmeans(df, 5)
dd <- cbind(rfm,df, cluster = km_result$cluster)
##查看每一类的数目
table(dd$cluster)
picture<-fviz_cluster(km_result, df, geom = "point")
####聚类结果解释####
rfm_final <- within(dd,{Custom = NA
Custom[cluster == 1] = '高价值客户'
Custom[cluster == 2 ] = '无价值客户'
Custom[ cluster == 3] = '无价值客户'
Custom[cluster == 4] = '重点发展客户'
Custom[cluster == 5] = '重点挽留客户'
})
RFM加权打分
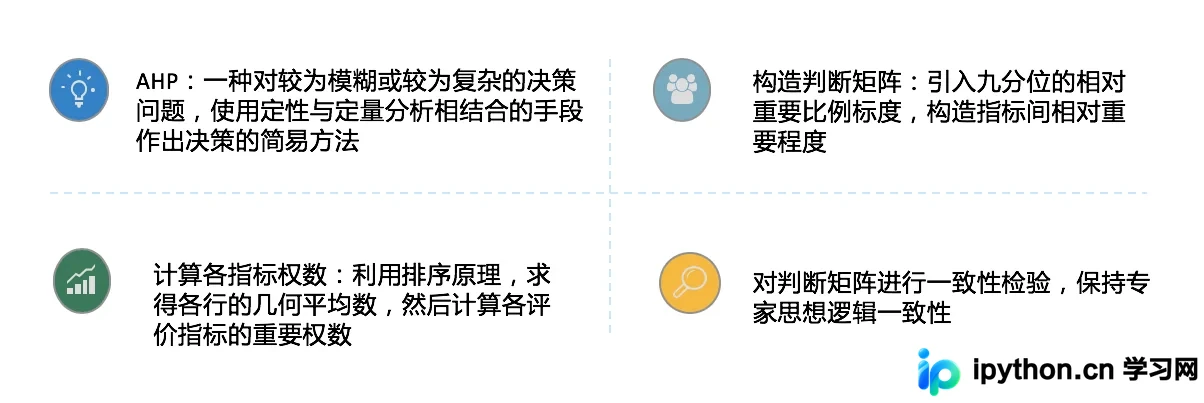
在步骤3中,我们将客户划分为四大类。若某一类中包含大量客户,为实现精细化营销,可根据RFM指标进行加权打分,计算综合价值分。此处运用AHP(层次分析法)确定各指标权重:
客户价值计算公式为:RFM_SCORE = 0.25 * rankR + 0.20 * rankF + 0.55 * rankM
AHP层次分析法(即专家打分法)的具体应用如下:
总结
上述客户分类较为粗略,面对千万级客户量时,仅划分为四大类难以满足运营需求。实际运营中,还需结合CRM系统中的其他指标和维度进行综合考量。
注:后续作者将利用RFM客户价值得分进行潜在客户挖掘,尝试使用决策树等模型来挖掘平台潜在客户的特征。
简单实例
import pandas as pd
import numpy as np
import time
#todo 读取数据
data = pd.read_csv('RFM_TRAD_FLOW.csv',encoding='gbk')
# print(ret)
# todo RFM------>R(最近一次消费)
#todo 时间与字符串相互转换
data['time'] = data['time'].map(lambda x:time.mktime(time.strptime(x,'%d%b%y:%H:%M:%S')))
# print(data)
# todo 分组
groupby_obj = data.groupby(['cumid','type'])
# for name,data in groupby_obj:
#   print(name)
#   print(data)
# todo 取值
R = groupby_obj[['time']].max()
# print(
# todo 转为透视表
r_trans = pd.pivot_table(R,index='cumid',columns='type',values='time')
# print(data_trans)
# todo 替换缺失值 有缺失值,替换成最远的值
r_trans[['Special_offer','returned_goods']] = r_trans[['Special_offer','returned_goods']].apply(lambda x:x.replace(np.nan,min(x)),axis = 0)
# print(data_trans)
r_trans['r_max'] = r_trans.apply(lambda x:sum(x),axis=1)
# print(r_trans)
# todo RFM------>F(消费频率)
# 取值
F =groupby_obj[['transID']].count()
# print(F)
#转为透视表
f_trans = pd.pivot_table(F,index='cumid',columns='type',values='transID')
# print(f_trans)
#替换缺失值
f_trans[['Special_offer','returned_goods']]= f_trans[['Special_offer','returned_goods']].fillna(0)
# print(f_trans)
#
f_trans['returned_goods'] = f_trans['returned_goods'].map(lambda x:-x)
# print(f_trans)
f_trans['f_total'] = f_trans.apply(lambda x:sum(x),axis=1)
# print(f_trans)
# todo RFM------>M(消费金额)
# 取值
M =groupby_obj[['amount']].sum()
# print(M)
#转为透视表
m_trans = pd.pivot_table(M,index='cumid',columns='type',values='amount')
# print(f_trans)
#替换缺失值
m_trans[['Special_offer','returned_goods']]= m_trans[['Special_offer','returned_goods']].fillna(0)
# print(f_trans)
#
m_trans['m_total'] = m_trans.apply(lambda x:sum(x),axis=1)
# print(m_trans)
# 合并
RFM=pd.concat([r_trans["r_max"],f_trans['f_total'],m_trans['m_total']],axis=1)
print(RFM)
r_score = pd.cut(RFM.r_max,3,labels=[0,1,2])
f_score = pd.cut(RFM.r_max,3,labels=[0,1,2])
m_score = pd.cut(RFM.r_max,3,labels=[0,1,2])
对Python相关内容感兴趣的读者,可查看本站专题:《Python函数使用技巧总结》、《Python面向对象程序设计入门与进阶教程》、《Python数据结构与算法教程》、《Python字符串操作技巧汇总》、《Python编码操作技巧总结》及《Python入门与进阶经典教程》。
希望本文所述的Python程序设计内容对大家有所帮助。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









