

Python爬虫技术详解:通用爬虫与聚焦爬虫的核心机制与对比
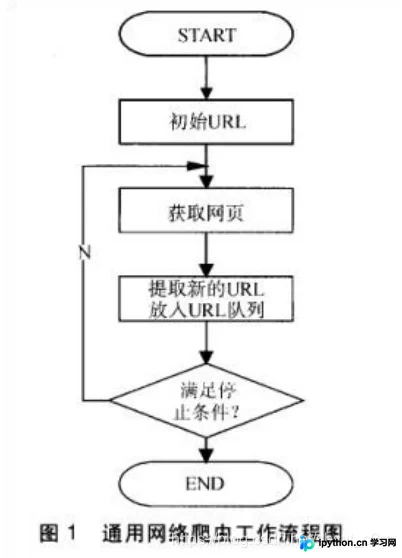
本文深入解析Python网络爬虫的两大核心类型:通用爬虫与聚焦爬虫。详细阐述通用爬虫在搜索引擎中的工作流程,包括种子URL选取、页面抓取、数据存储及预处理(分词、索引构建)等关键步骤,并探讨Robots协议的作用与局限性。同时,介绍聚焦爬虫如何通过主题筛选算法实现精准数据采集,对比两者在覆盖率、资源消耗及应用场景上的差异,并简述常见的反爬虫手段如IP限制与数据投毒,为开发者提供全面的技术参考。
2026-10-14
37

本文深入解析Python网络爬虫的两大核心类型:通用爬虫与聚焦爬虫。详细阐述通用爬虫在搜索引擎中的工作流程,包括种子URL选取、页面抓取、数据存储及预处理(分词、索引构建)等关键步骤,并探讨Robots协议的作用与局限性。同时,介绍聚焦爬虫如何通过主题筛选算法实现精准数据采集,对比两者在覆盖率、资源消耗及应用场景上的差异,并简述常见的反爬虫手段如IP限制与数据投毒,为开发者提供全面的技术参考。
本文详解Scrapy中向Spider传递参数的两种主流方法。第一种通过命令行crawl命令的-a选项传入参数,并在Spider构造函数中接收;第二种通过scrapyd调度schedule.json接口使用-d选项添加参数。此外,还介绍了利用Request的meta属性在页面解析间传递数据的技巧,帮助开发者灵活控制爬虫行为。
本文详解如何使用Python调用企业微信API发送包含图片链接的消息。针对图片上传导致主线程阻塞的问题,提供基于多线程的封装方案,并结合OpenCV处理图像,实现高效稳定的消息推送。
在Java并发编程中,主线程有时需要等待特定子线程完成任务才能继续执行。本文介绍了如何使用Thread类的join()方法实现线程阻塞与同步,详细说明了无参join()、带毫秒参数的join(long)及带纳秒参数的join(long, long)三种重载形式的使用方法、执行逻辑及异常处理机制,并提供完整示例代码供参考。
本文详解 PHP 单例模式的定义、三大核心原则及标准实现方式。通过私有构造函数防止外部实例化,利用静态变量保存唯一对象,并通过 getInstance() 方法提供全局访问入口,确保类在整个应用生命周期中仅存在一个实例,常用于数据库连接管理等资源场景。
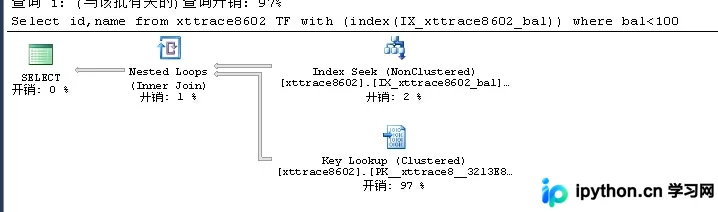
在 SQL Server 中,当索引提示导致查询变慢但无法立即修改代码时,可以使用跟踪标志(Trace Flag)临时让优化器忽略索引提示。本文介绍启用 DBCC TRACEON(8602,-1) 的具体操作、环境准备及验证方法,帮助用户在不修改 SQL 语句的情况下快速排查和优化性能。
本文详细解析 Scrapy 中 settings.py 的关键配置项。涵盖字符编码设置、Redis 连接参数(含密码与数据库指定)、请求超时与重试机制优化,以及基于 scrapy-redis 的去重组件、调度器和持久化断点续爬功能的配置方法。通过调整 DUPEFILTER_CLASS、SCHEDULER 及 SCHEDULER_QUEUE_CLASS 等参数,实现高效分布式爬虫与数据持久化存储。
本文详解如何通过修改php.ini配置文件实现PHP文件上传,特别是大文件支持。重点解析file_uploads、upload_tmp_dir、upload_max_filesize、post_max_size、max_execution_time等关键参数的设置逻辑与依赖关系,提供50MB级大文件上传的配置示例及权限注意事项,帮助开发者规避上传失败或超时问题。
本文介绍如何在Scrapy框架中配置动态代理IP以应对网站反爬机制。通过设置DOWNLOADER_MIDDLEWARES启用ProxyMiddleware和CheckProxyMiddleware,并在settings中定义PROXIES列表,实现请求IP的随机切换与基础验证,帮助爬虫稳定获取数据。
本文深入解析Python多线程编程中共享全局变量引发的数据竞争问题。通过引入互斥锁(Mutex)机制,确保多个线程安全访问共享资源。文章详细阐述了同步概念、互斥锁的工作原理及acquire/release方法的使用,并提供了完整的代码示例,展示如何正确使用上锁与解锁来保证数据一致性,同时强调了最小化锁范围以优化性能的最佳实践。
本文深入解析Python中图像缩放的底层原理,对比OpenCV与Pillow两大库的实现差异,并指导读者使用Click库构建一个支持批量处理、参数配置的命令行图像缩放工具。
本文深入解析Python反射机制,详细讲解hasattr、getattr、setattr和delattr四个核心方法的使用场景。通过实例演示如何动态检测属性、获取方法内存地址、绑定外部函数及删除成员,并阐述反射在实现可插拔机制和动态模块导入中的优势,帮助开发者掌握Python自省能力。