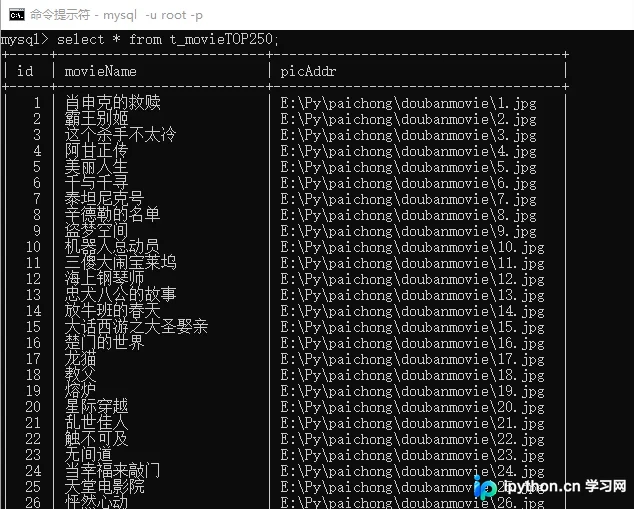
Python实现豆瓣电影TOP250数据爬取与MySQL存储教程
本文详细介绍如何使用Python编写爬虫程序,从豆瓣电影TOP250页面抓取电影名称及图片链接,并将结果存储至MySQL数据库。教程涵盖数据库初始化、正则匹配提取、网页请求处理及数据持久化完整流程,适合Python初学者参考。
2026-10-14
29

本文详细介绍如何使用Python编写爬虫程序,从豆瓣电影TOP250页面抓取电影名称及图片链接,并将结果存储至MySQL数据库。教程涵盖数据库初始化、正则匹配提取、网页请求处理及数据持久化完整流程,适合Python初学者参考。
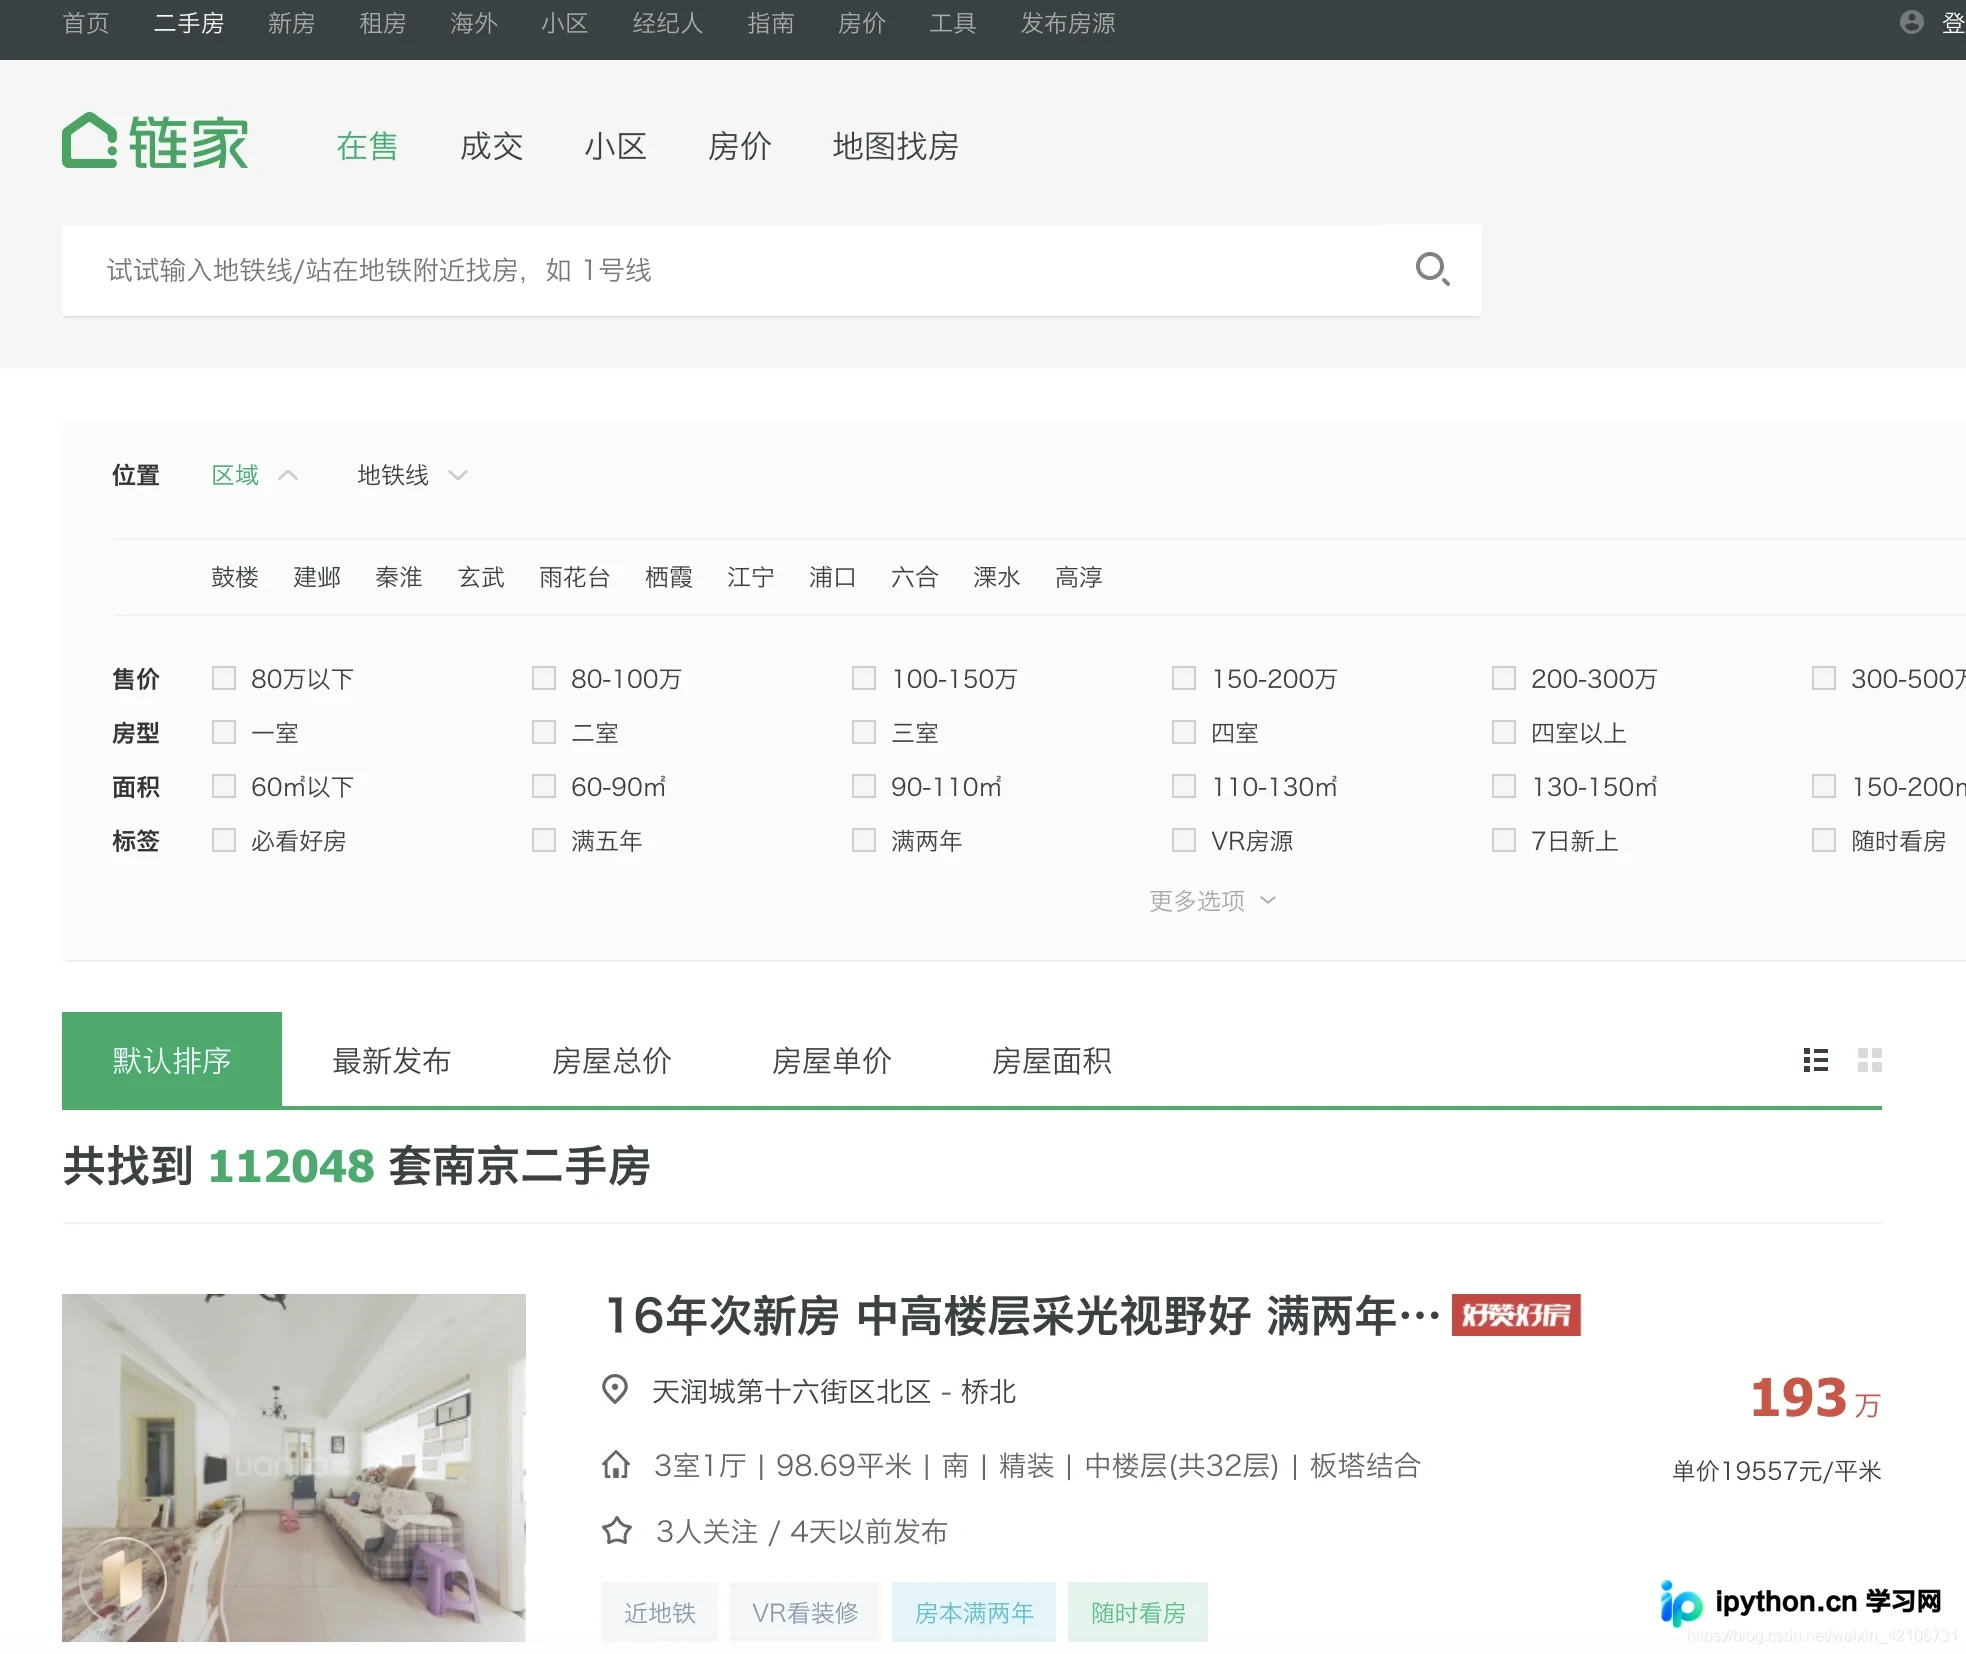
本文详细介绍使用Python爬取链家二手房数据的完整流程。通过Requests获取页面HTML,利用BeautifulSoup解析DOM结构,提取标题、户型、面积、朝向、装修、位置及价格等关键信息。文章涵盖数据定位、HTML获取及解析代码示例,帮助开发者掌握基础爬虫技巧。
本文解析C#中可空类型(Nullable Types)在数据访问层的核心作用。重点阐述如何利用可空类型安全处理数据库查询中可能出现的NULL值,区分与DBNull.Value的使用场景,并提供DateTime和Int32类型的具体转换代码示例,防止程序因空引用或无效操作而崩溃。
本文介绍C语言环境下两种主流文件操作方法:Windows平台的CreateFile API与标准库fopen。通过完整代码示例,演示如何利用CreateFile进行底层句柄管理(创建、写入、读取、同步),以及如何通过fopen实现基于流的便捷IO。内容涵盖参数配置、错误处理及指针移动等关键步骤,适用于需要深入理解不同层级文件访问机制的开发场景。
本文深入解析Python中命名元组、三目运算符及推导式的核心用法。通过对比常规写法,展示如何利用命名元组优化内存并提升代码可读性,结合自动化测试场景说明其实际应用。同时详解三目运算符的嵌套逻辑,以及列表和字典推导式的多种组合技巧,帮助开发者编写更简洁高效的Python代码。
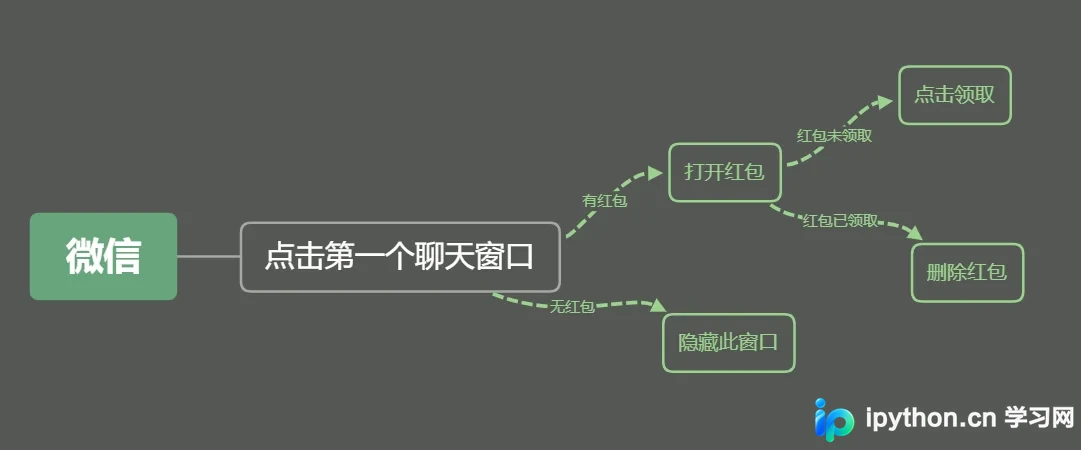
本文介绍如何利用Python和Appium框架实现微信红包的自动领取功能。通过配置Android设备参数,结合元素定位与长按操作,自动识别并领取红包,同时处理公众号消息干扰。文章提供了完整的代码示例和关键步骤解析,帮助开发者快速掌握自动化抢红包的实现方法。
本文详解SQL Server中数据库阻塞与死锁的原理,并提供一个名为p_lockinfo的T-SQL存储过程。该脚本可一键查询当前所有进程的锁状态、来源语句,并支持通过参数自动终止死锁进程,是解决此类常见性能问题的实用工具。
本文介绍如何利用 scikit-learn 0.22 版本新增的 KNNImputer 类,通过 KNN 算法原理对数据集中的缺失值进行高效插补。文章通过简单示例和 Kaggle 皮马印第安人糖尿病数据集的实际案例,详细演示了从导入库、处理零值缺失、设置邻居数到最终填充的全过程,并指出该方法仅支持数值型特征。
在JavaScript中,虽然通常不建议修改函数参数,但通过直接赋值、修改arguments对象或同名局部变量声明均可实现。本文深入探讨这些操作背后的机制,重点分析var声明提升对参数引用的影响,揭示形参、实参与内部变量之间的关联规则。
在C#开发中,若需将普通字符串安全地嵌入正则表达式,必须对元字符进行转义。本文介绍一种基于Regex类匹配并替换的实现方案。该方法优先处理反斜杠以避免二次转义错误,随后通过正则模式批量识别其他特殊符号,并按顺序插入前缀反斜杠,最终返回符合正则语法的纯净字符串。
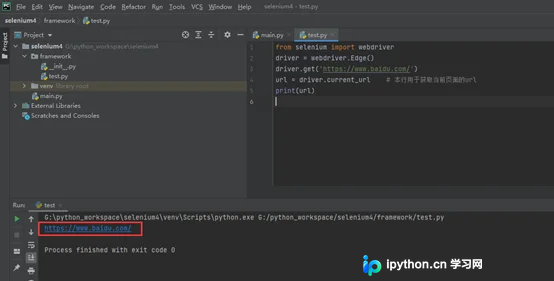
本文详解Python3结合Selenium4进行自动化测试时的浏览器基础操作。涵盖访问指定URL、获取当前页面URL与标题、模拟返回与前进按钮、刷新页面以及窗口大小、最大化、最小化和全屏等常用功能。通过具体代码示例,帮助开发者掌握Selenium4中driver对象的常用方法,提升测试脚本的稳定性与兼容性。
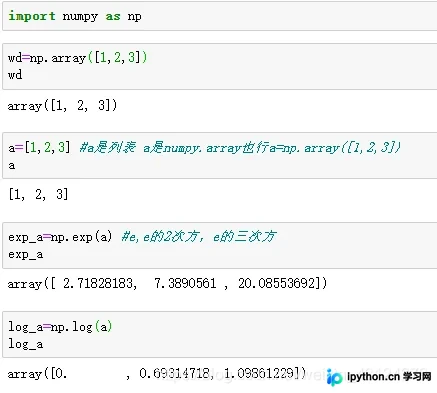
本文介绍Python中计算对数的两种主要方式:使用math模块处理单一数值,以及利用numpy库对数列进行批量运算。详细解析了math.log与numpy.log的用法差异,并补充了指数计算的相关函数对比,帮助开发者根据需求选择合适的工具。