

Python多继承调用顺序实例分析
本文通过两个Python多继承示例,深入解析类方法解析顺序(MRO)。结合C3线性化算法,阐明Python 3中多继承的查找规则,对比不同父类排列对方法调用的影响,帮助开发者掌握复杂继承结构下的行为预测。
2026-10-13
16

本文通过两个Python多继承示例,深入解析类方法解析顺序(MRO)。结合C3线性化算法,阐明Python 3中多继承的查找规则,对比不同父类排列对方法调用的影响,帮助开发者掌握复杂继承结构下的行为预测。
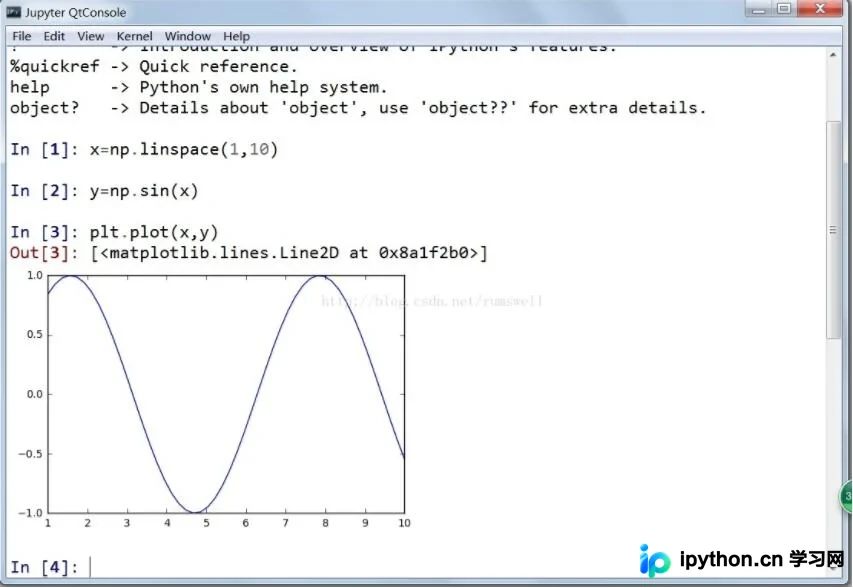
本文介绍在Jupyter Notebook中直接显示Matplotlib生成的图形的方法。通过生成并修改ipython_config.py配置文件,设置InteractiveShellApp.matplotlib为'inline',即可实现图表内联显示。注意需修改正确的配置文件,避免在ipython_qtconsole_config.py中操作。
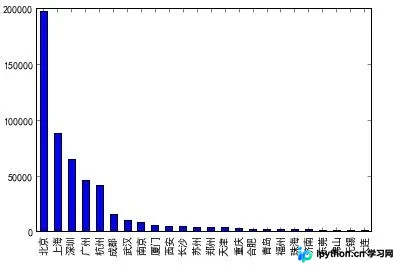
在使用pandas进行数据可视化时,常遇到图表中文显示为方框的问题。本文分析原因是matplotlib默认不支持Unicode,通过修改matplotlibrc配置文件,在font.serif和font.sans-serif中添加SimHei字体,即可解决中文乱码,实现正常显示。
本文详解如何使用Python处理NetCDF(nc)数据。首先通过GDAL命令行查看nc文件中的SUBDATASET信息,随后介绍利用netCDF4库读取数据为数组进行统计计算的方法。重点讲解使用rasterio库直接读取nc子数据集,并通过添加空间参考和变换信息将其转换为GeoTI格式,实现科学观测数据向地图可视化的完整流程。
本文介绍如何利用Python结合Selenium库与PhantomJS无头浏览器进行网页截图。通过实例代码展示获取页面标题、保存截图文件及打印当前工作目录的具体步骤,为需要自动化抓取网页视觉内容的开发者提供参考方案。
本文汇总了Python中执行系统命令并获取返回值的几种常见方式。针对无返回值、仅获取输出结果以及同时获取命令状态码等不同场景,分别介绍了os.system、os.popen、subprocess.Popen以及commands.getstatusoutput的具体用法与代码示例,帮助开发者根据实际需求选择最合适的调用方法。
本文介绍如何利用Python的urllib2和cookielib库实现网页自动登录。通过构建包含CookieJar的Opener对象,模拟浏览器发送POST请求完成身份验证,并自动保存会话Cookie。后续请求携带该Cookie即可访问需登录的页面,以人人网为例展示了具体实现逻辑。
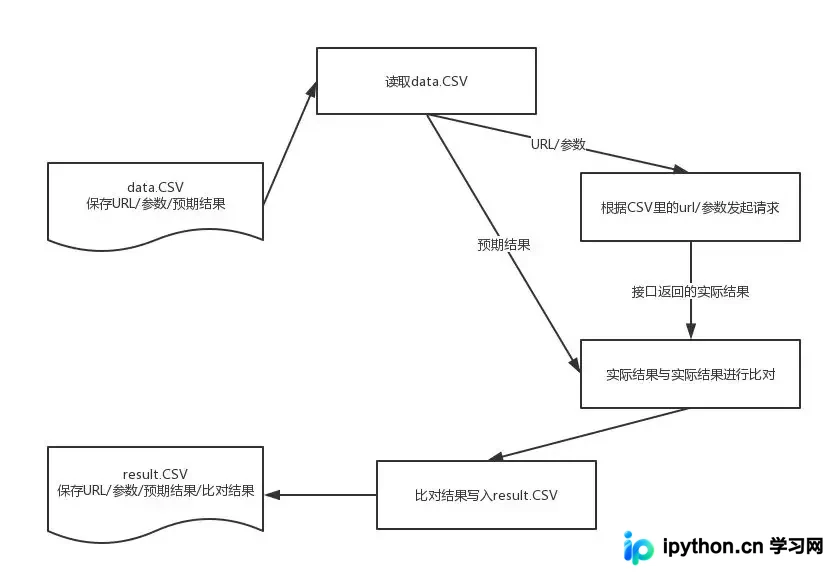
本文介绍如何使用Python结合csv和requests库,构建基于CSV文件的数据驱动接口自动化测试方案。通过预定义测试用例数据,自动发起GET或POST请求并比对响应结果,实现高效、可扩展的接口测试流程,适用于需要批量验证API参数的场景。
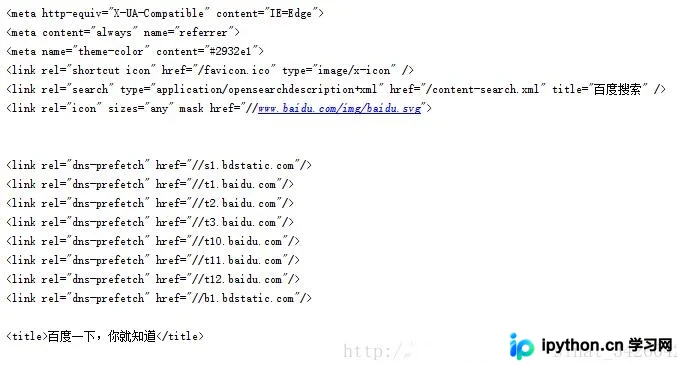
本文分析Python爬虫中中文显示乱码的根本原因,即默认Unicode解析与系统编码格式不匹配。通过示例代码展示如何利用urllib获取网页,将UTF-8内容解码后重新编码为系统默认格式,从而完美解决中文输出乱码问题,适用于百度等常见网页抓取场景。
本文详细讲解如何在Python环境中配置Tesseract-OCR及pytesseract库以实现图像文字识别。内容涵盖Pillow、pytesser3、autopy3及Tesseract的安装步骤,重点解决Tesseract路径未加入环境变量导致的报错问题,并提供完整的Python识别代码示例及效果展示。

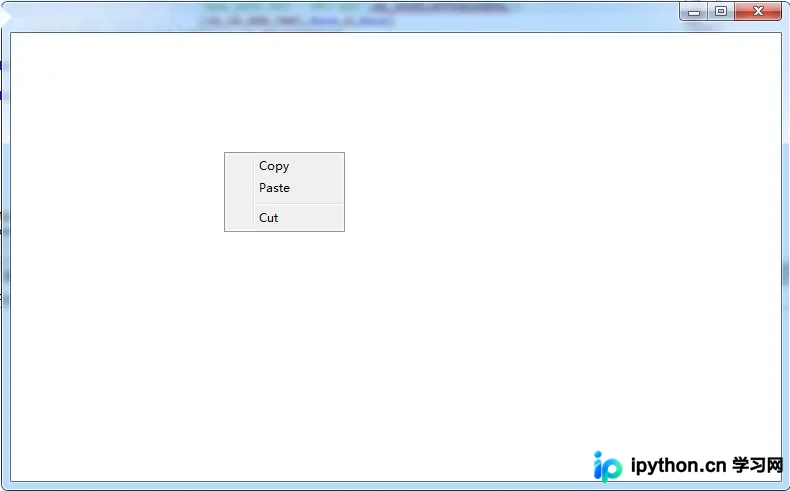
本文通过Python的win32ui模块演示如何创建基于MFC的图形界面窗口及右键弹出菜单。代码展示了窗口创建、消息钩子绑定及菜单项添加的具体实现,并提供了模块安装方法。
本文介绍在python-docx中修改已存在Word文档表格字体格式的方法。由于直接修改table.style.font.name可能受限于文档原有格式,建议通过add_run添加文本并设置run.font.name和size来调整字体。新建文档时可直接定义表格样式,而修改现有文档需逐单元格处理。