

Python爬虫进阶:代理IP配置与浏览器伪装技巧详解
本文详细讲解Python爬虫中如何有效设置代理IP及伪装浏览器身份。内容涵盖使用urllib模块配置请求头、添加代理服务器、处理POST请求参数,以及利用PhantomJS和Selenium WebDriver模拟真实浏览器行为。通过具体代码示例,帮助开发者规避反爬限制,提升数据采集成功率。
2026-10-13
16

本文详细讲解Python爬虫中如何有效设置代理IP及伪装浏览器身份。内容涵盖使用urllib模块配置请求头、添加代理服务器、处理POST请求参数,以及利用PhantomJS和Selenium WebDriver模拟真实浏览器行为。通过具体代码示例,帮助开发者规避反爬限制,提升数据采集成功率。
本文介绍Python中利用openpyxl库遍历Excel工作表的两种常用方法。第一种通过sheet.iter_rows()获取所有行并逐个打印单元格坐标与值;第二种结合sheet.max_row和sheet.max_column确定行列范围进行遍历。文中附带完整代码示例,帮助开发者快速掌握Sheet数据读取技巧。
本文介绍在Python中如何实现不同文件内类的方法互相调用。通过将ALL实例作为参数传递给SON类,实现跨文件的方法访问。利用from son import *或import son进行模块导入,结合动态实例化技术,完成类间逻辑交互。
本文介绍如何使用Python脚本在删除当前目录下所有文件和文件夹时,指定保留特定的目录和文件。通过遍历目录列表,利用os和shutil模块判断并执行删除操作,代码示例展示了如何配置保留列表并执行清理任务。
本文详解Python中subprocess模块的用法,涵盖call、check_call、check_output及Popen等核心方法。通过对比废弃模块,展示如何安全执行系统命令、处理状态码及捕获输出,并深入解析Popen参数与交互式进程控制技巧。
本文介绍使用Python脚本合并同一文件夹下所有TXT文件的方法。通过遍历目录读取内容并写入新文件,实现批量合并。代码包含路径配置、文件读写逻辑及耗时统计,适用于需要整合多个文本数据的场景。
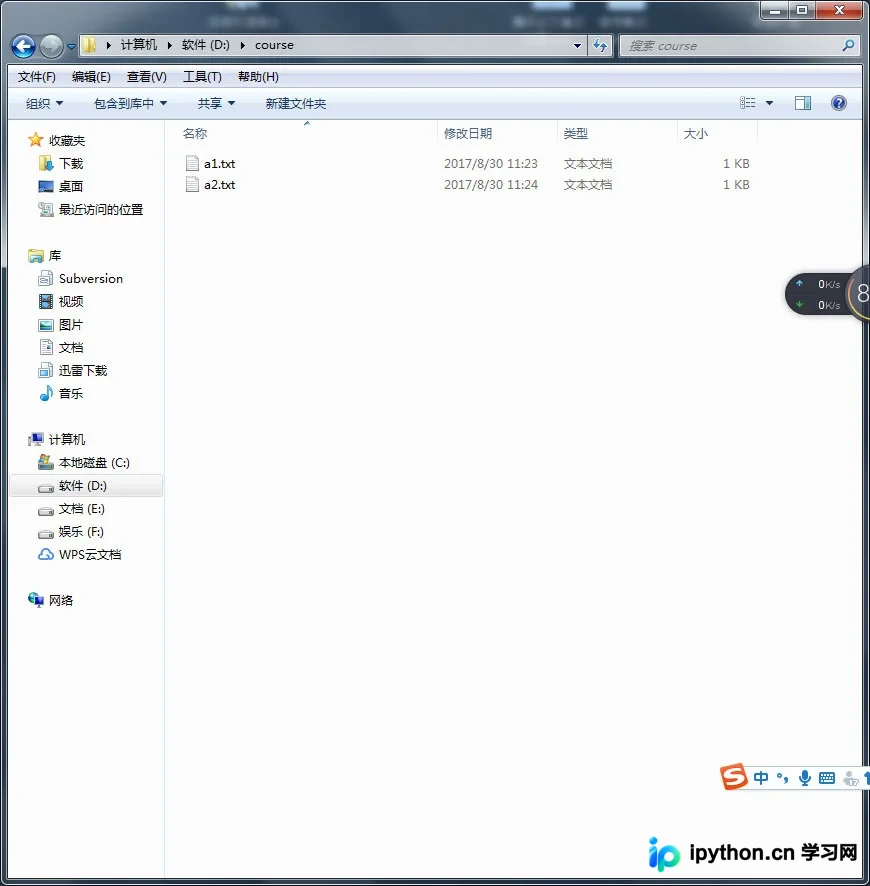
本文介绍如何利用Python的os模块批量查找并删除当前目录下的所有.py文件。通过遍历目录、判断文件后缀名,并结合os.path.join构建完整路径,最终使用os.remove执行删除操作。该方法适用于教程重学或代码重构时清理冗余脚本的场景,提供完整的Python代码示例供参考。
本文介绍在Python中如何遍历指定文件夹以获取所有文件名称,并将结果写入列表或文本文件。通过os.walk和os.listdir两种方法,分别实现递归遍历子目录和非递归获取指定类型文件的功能,适用于深度学习等需要批量处理数据的场景。
本文介绍如何使用Python的requests模块模拟HTTP请求获取Ajax接口数据,并结合内置json模块进行结构化解析。通过高德地图POI查询示例,演示从获取原始文本到提取嵌套字典中具体字段(如名称、地址、经纬度)的完整流程,为处理大量结构化数据提供基础模板。
本文介绍如何在Python中利用startswith和endswith方法在字符串开头或结尾进行文本模式匹配。通过示例演示如何检查文件扩展名和URL协议,并展示如何结合元组进行多选项检查及数据整理操作,帮助开发者高效处理字符串验证任务。
本文介绍了如何在Python3环境中利用Pandas库与pymysql、SQLAlchemy配合,实现从MySQL数据库读取数据并插入新表的操作。内容涵盖数据库连接配置、建表语句、初始数据插入及用户权限授权,提供完整代码示例供参考。
本文介绍如何使用Python将文件中由制表符分隔的数字行读取并转换为List。通过strip()去除首尾空格,利用split()按制表符切片,再结合map或列表推导式将字符串转为整数,最终构建包含所有行数据的嵌套List结构。