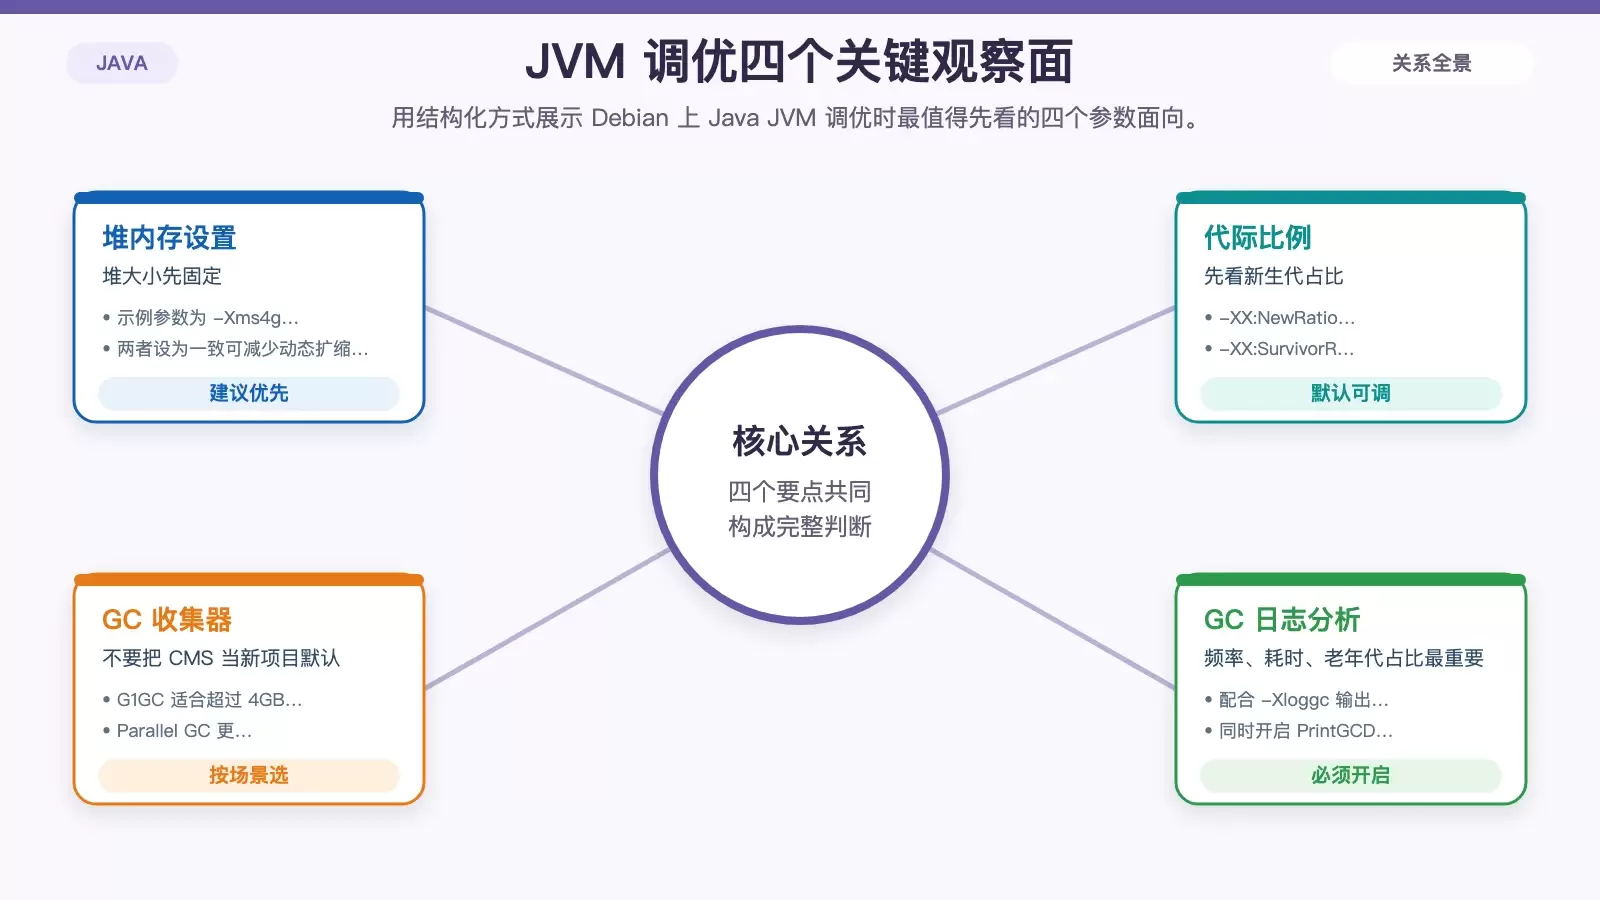
Debian 如何优化 Java 配置:从 JDK、JVM 到系统参数的实用调优清单
在 Debian 上优化 Java 性能,重点不只是改几条 JVM 参数,而是把 JDK 版本、堆与 GC、代码写法、内核限制和监控链路一起梳理。本文按排查顺序整理出一套更适合落地的优化清单,方便你判断问题该从哪一层下手。
2026-08-23
58

在 Debian 上优化 Java 性能,重点不只是改几条 JVM 参数,而是把 JDK 版本、堆与 GC、代码写法、内核限制和监控链路一起梳理。本文按排查顺序整理出一套更适合落地的优化清单,方便你判断问题该从哪一层下手。
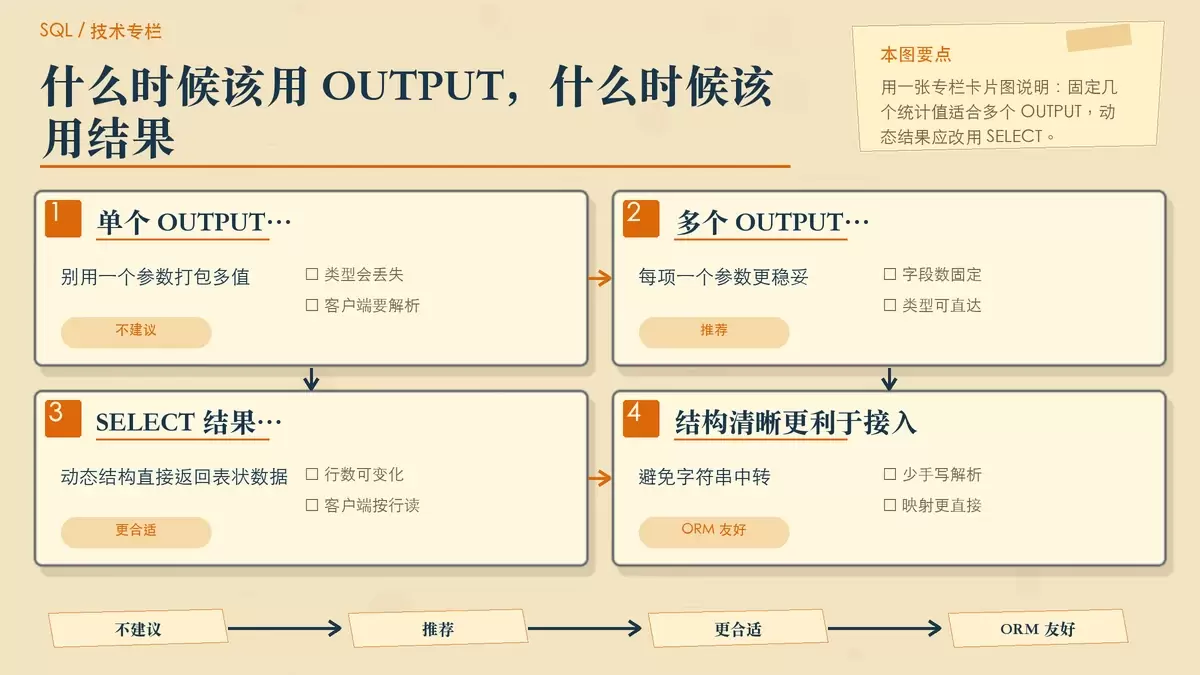
在 SQL Server 里,存储过程的 OUTPUT 参数一次只能回写一个标量值。要返回多个统计结果,正确做法是为每个值单独声明 OUTPUT 参数;如果结果列数或行数不固定,则应直接返回 SELECT 结果集。本文用订单统计示例梳理定义、调用、读取时最容易踩的点。
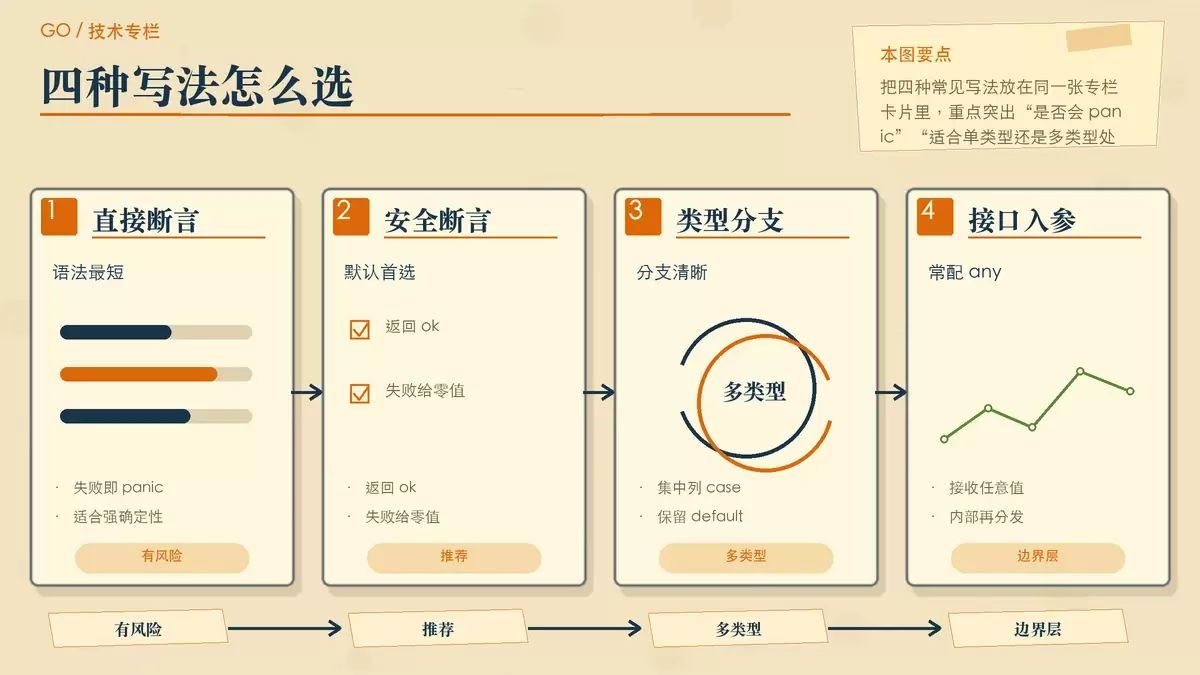
类型断言是 Go 里处理接口值的常见手段,但直接写成 `x.(T)` 往往埋着 `panic` 风险。本文按“怎么写、何时用、哪些坑最常见”重新梳理四种写法与实践原则,帮助你判断该用安全断言、`switch` 分支,还是换成更合适的错误处理方式。
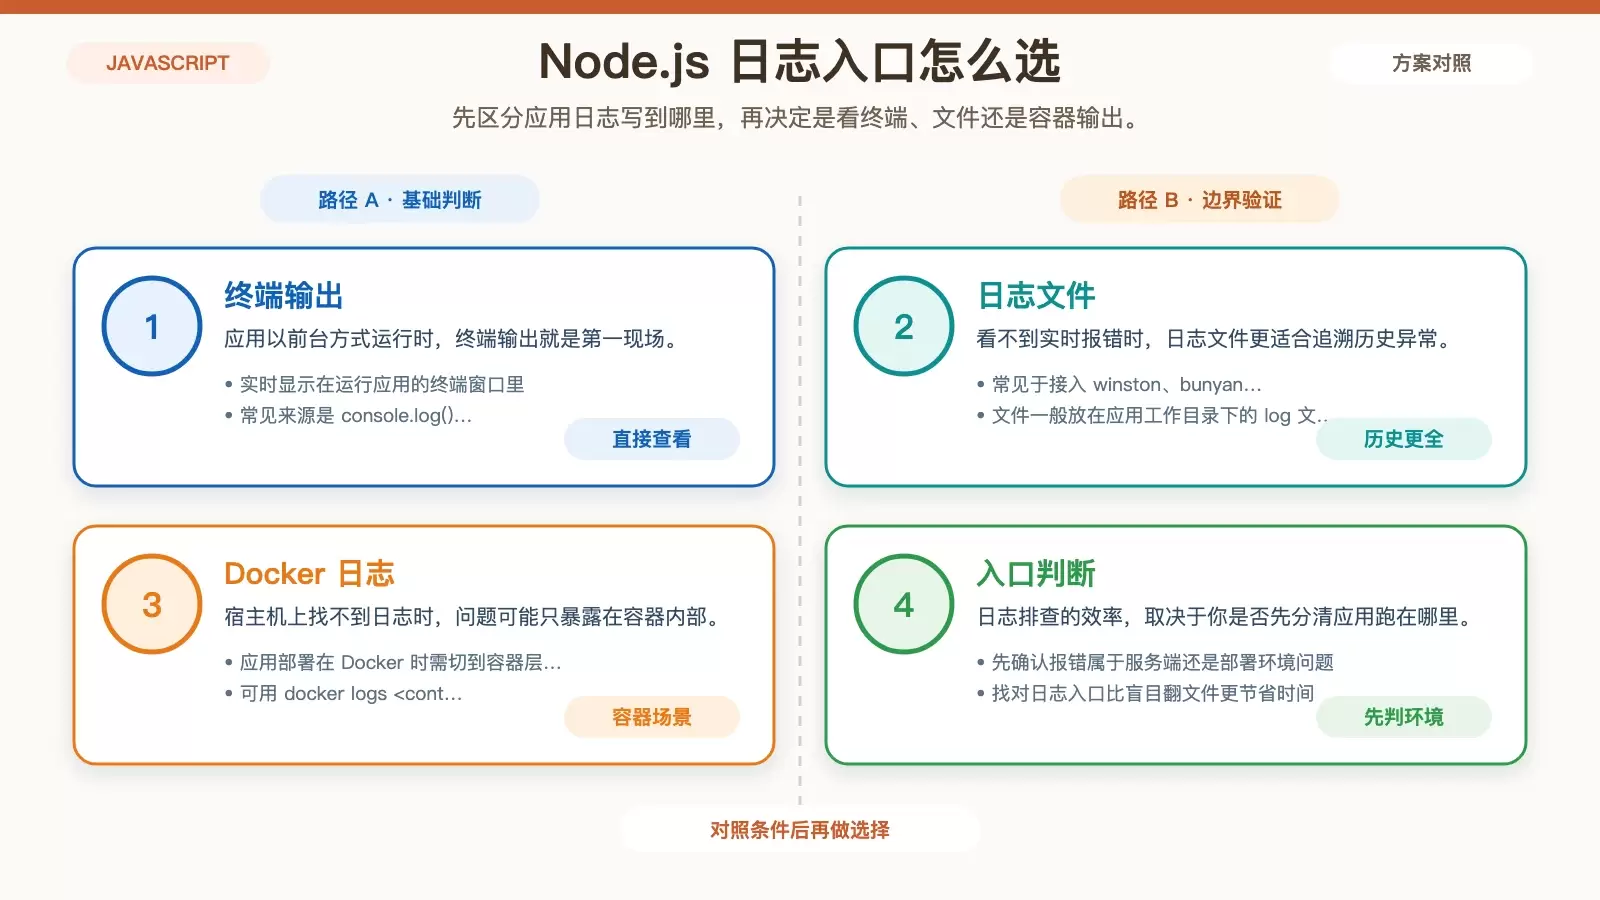
Linux 日志不一定直接告诉你 JavaScript 为什么报错,但在 Node.js、Docker 和浏览器协同排查时,它往往能提供第一手线索。本文按运行位置拆解日志入口,并给出从终端输出到本地复现的排查顺序。 Linux 日志确实可能藏着 JavaScript 报错的关键线索,但前提是先分清问题发生在 Node.js 服务端、Docker 容器,还是浏览器前端。
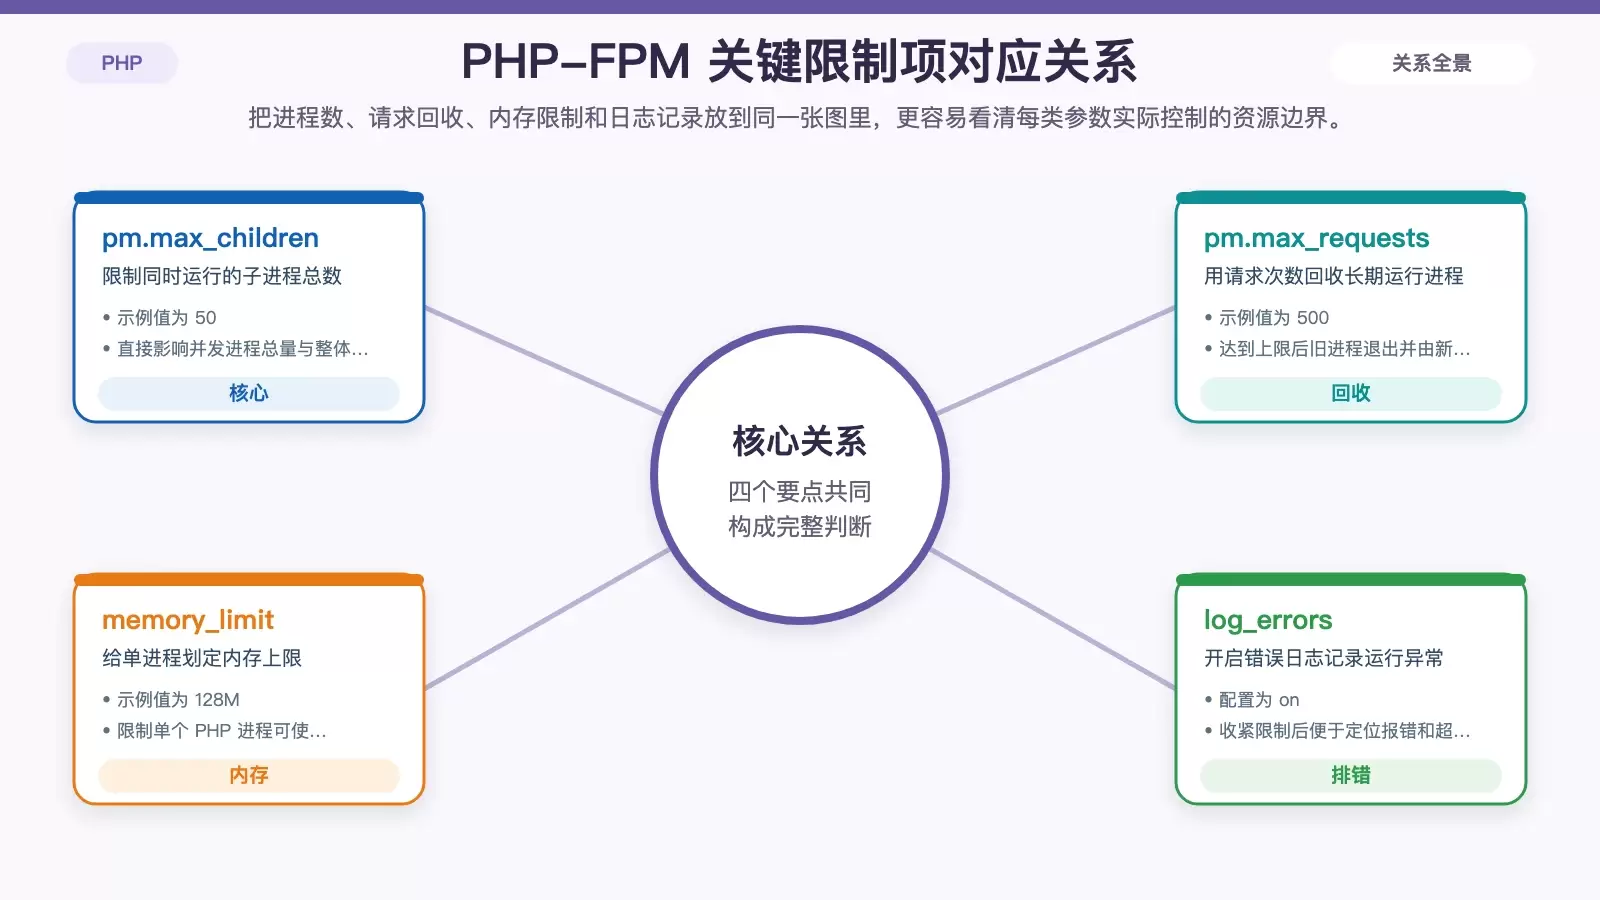
在 Ubuntu 上限制 PHP-FPM 资源占用,核心就是调整 `www.conf` 里的进程数、请求回收和内存相关参数。本文把几个最常用配置拆开说明,并补上重启生效与调参时的判断重点,方便你按服务器负载做针对性收敛。
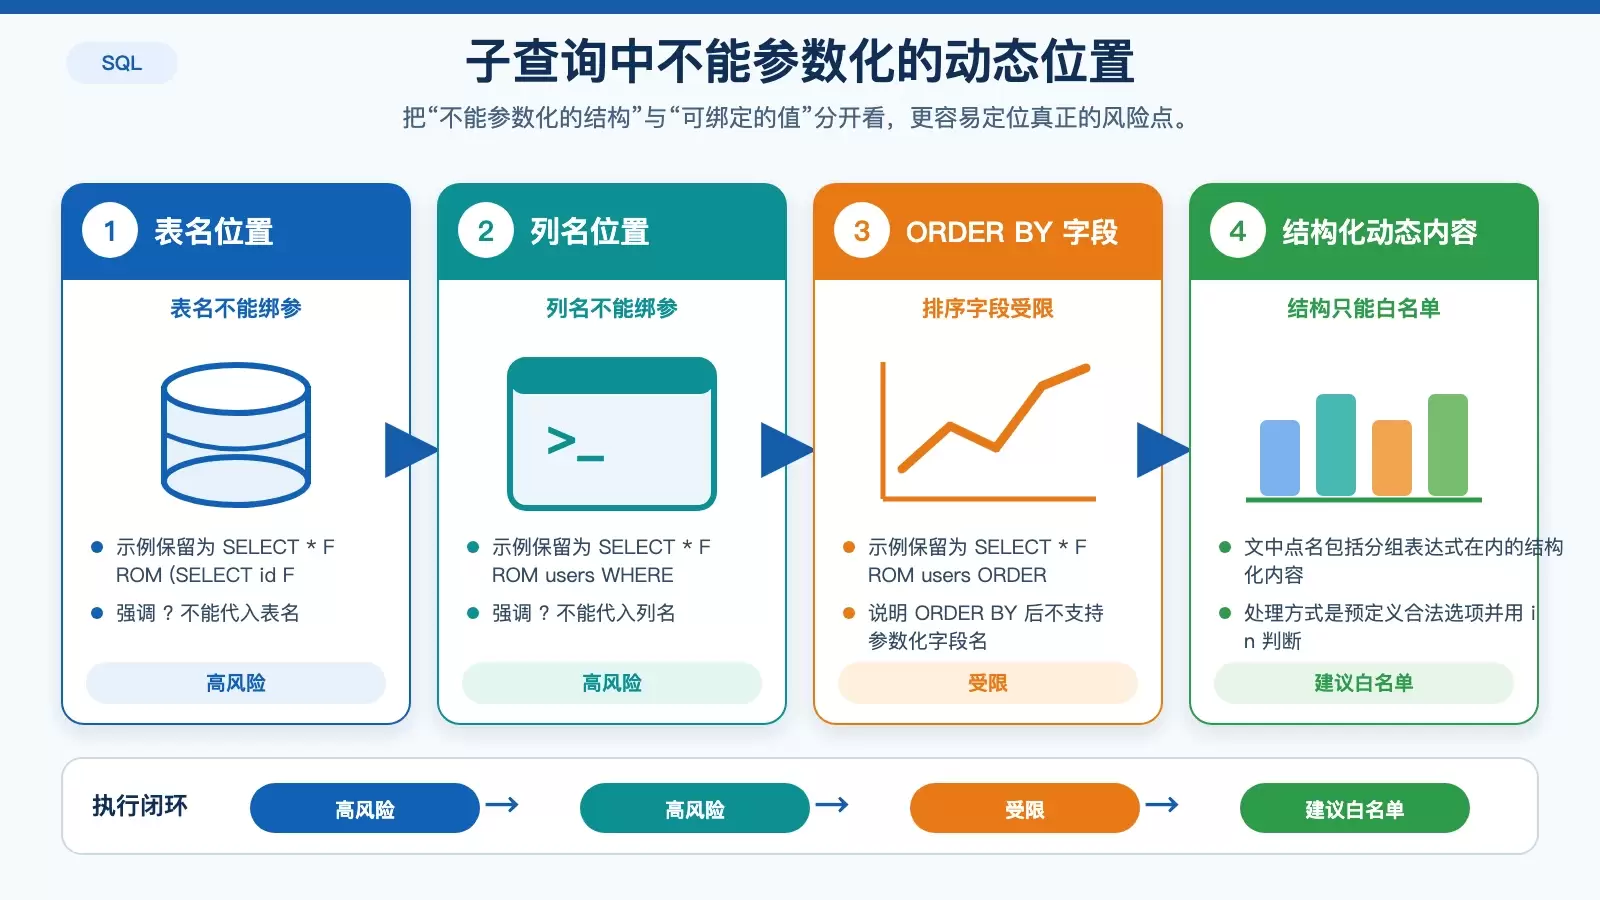
子查询并不会天然带来 SQL 注入,风险点始终是把用户输入直接拼进 SQL 字符串。判断是否安全的关键只有两条:结构化动态内容做白名单校验,所有用户可控的值一律参数化绑定,而且要覆盖到最内层子查询。
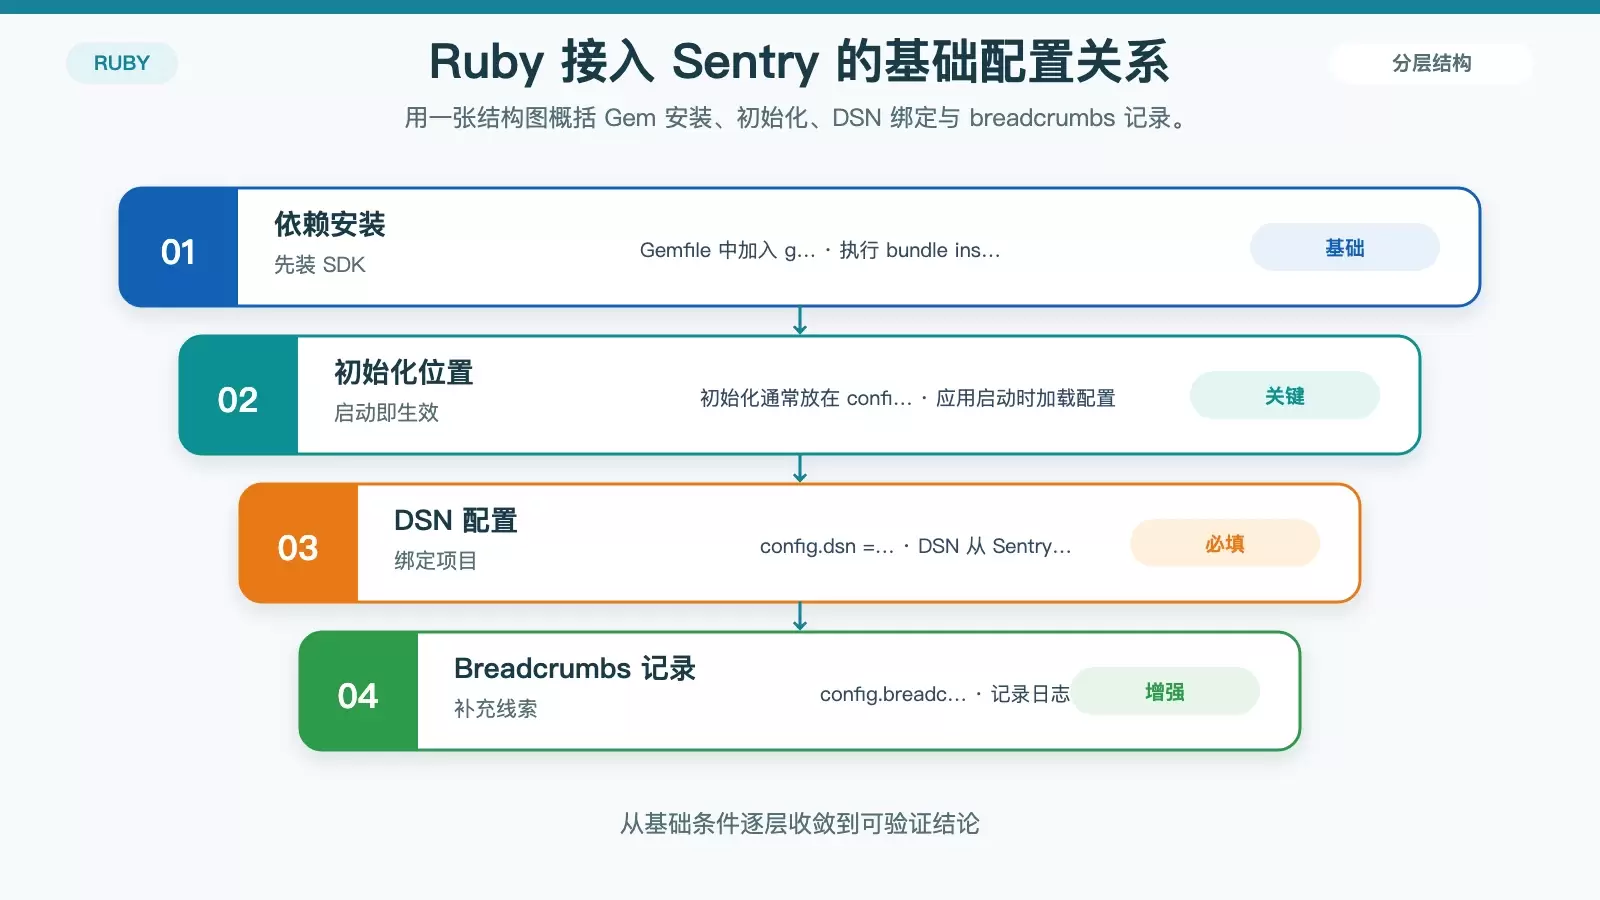
这篇文章梳理了 Ruby 与 Rails 项目接入 Sentry 的基本流程,包括 SDK 安装、初始化、环境区分、用户上下文、手动上报和日志补充。你可以据此快速完成接入,并判断哪些配置最能帮助后续排查线上问题。
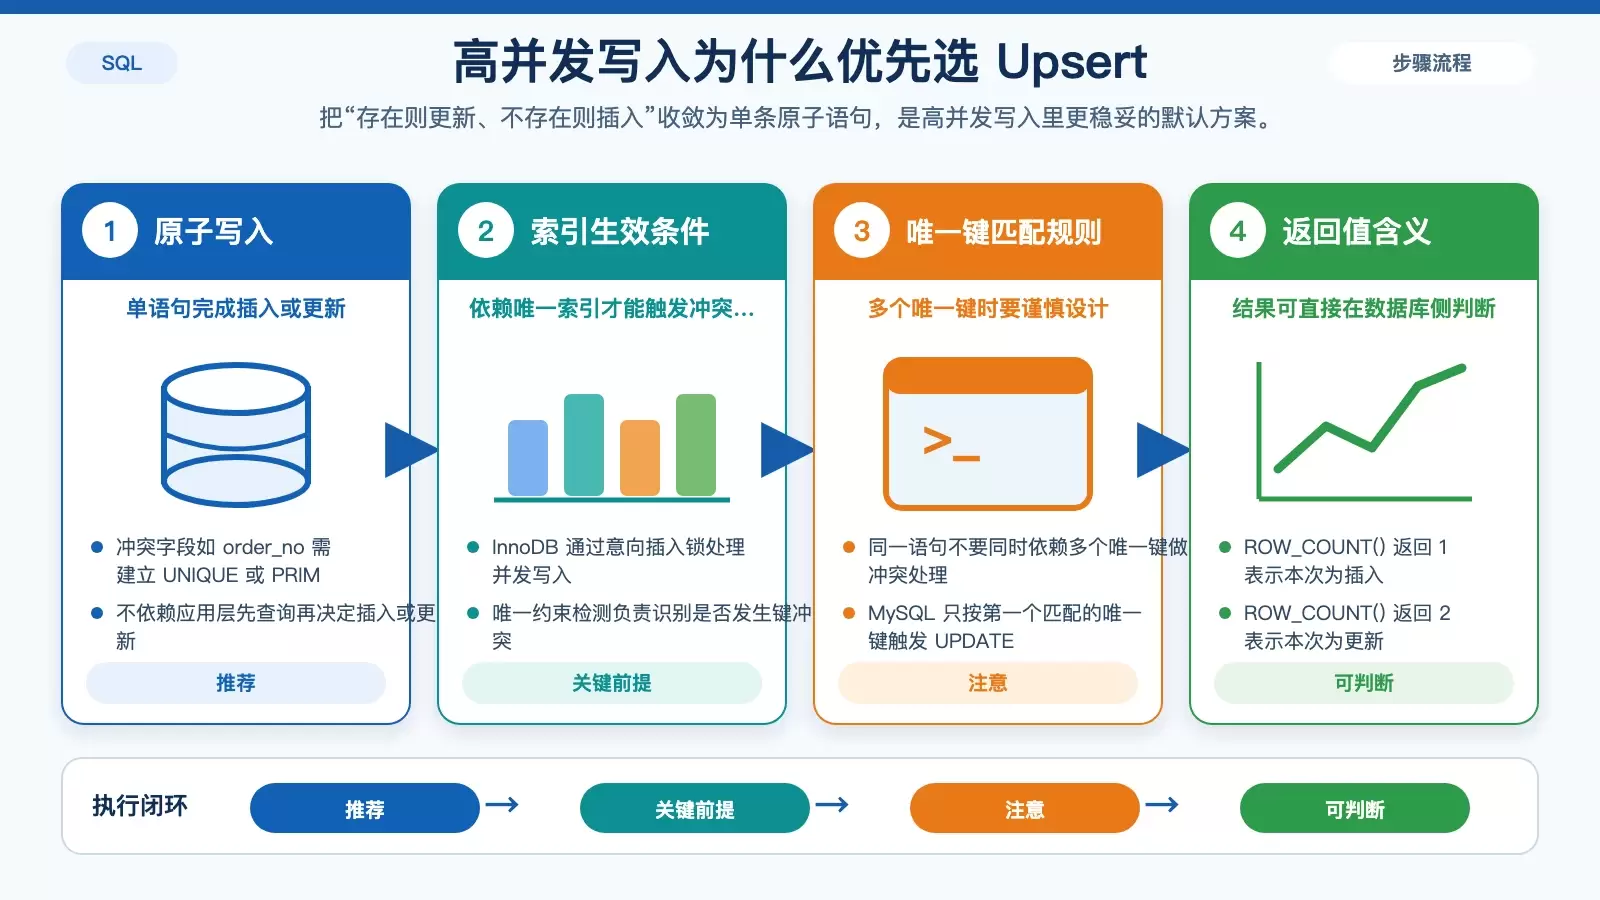
高并发插入真正容易触发死锁的,通常不是单纯的 `INSERT`,而是“先查后插”里混用了 `SELECT ... FOR UPDATE`、无索引条件和跨表事务。本文按可直接落地的判断顺序,说明为什么 `INSERT ... ON DUPLICATE KEY UPDATE` 更稳,以及什么情况下才能谨慎使用行锁方案。
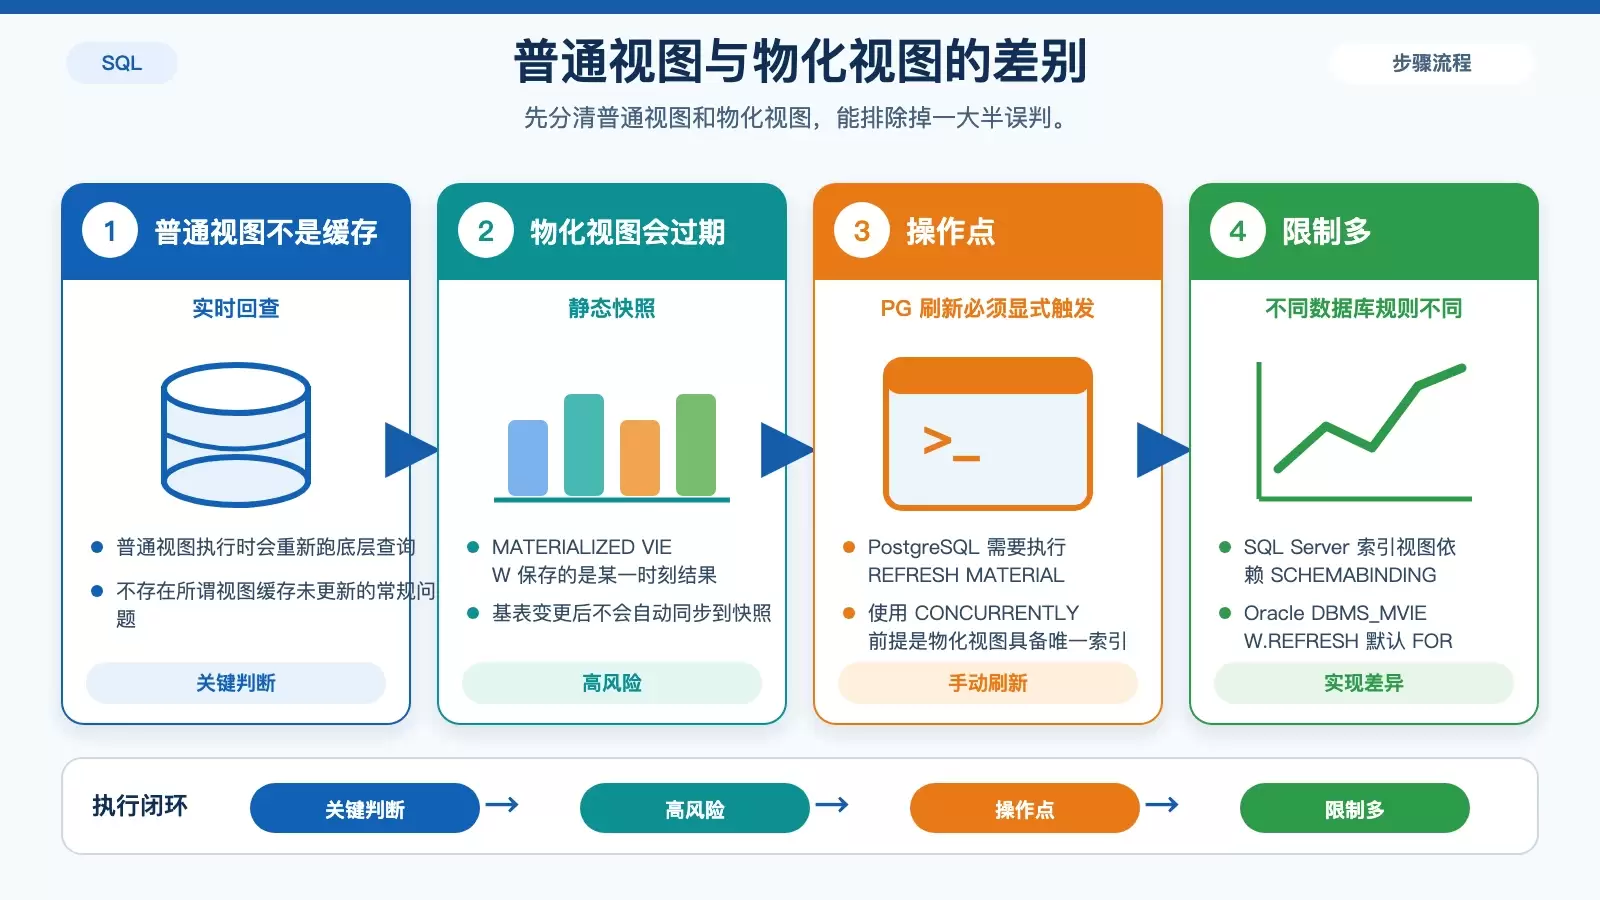
SQL 视图查询不到最新数据,通常不是“视图缓存”导致的,而是事务未提交、误用物化视图、连到延迟从库,或依赖触发器的预计算链路失效。本文按排查顺序拆解这些常见原因,并给出 MySQL、PostgreSQL、SQL Server、Oracle 的关键判断点与命令。
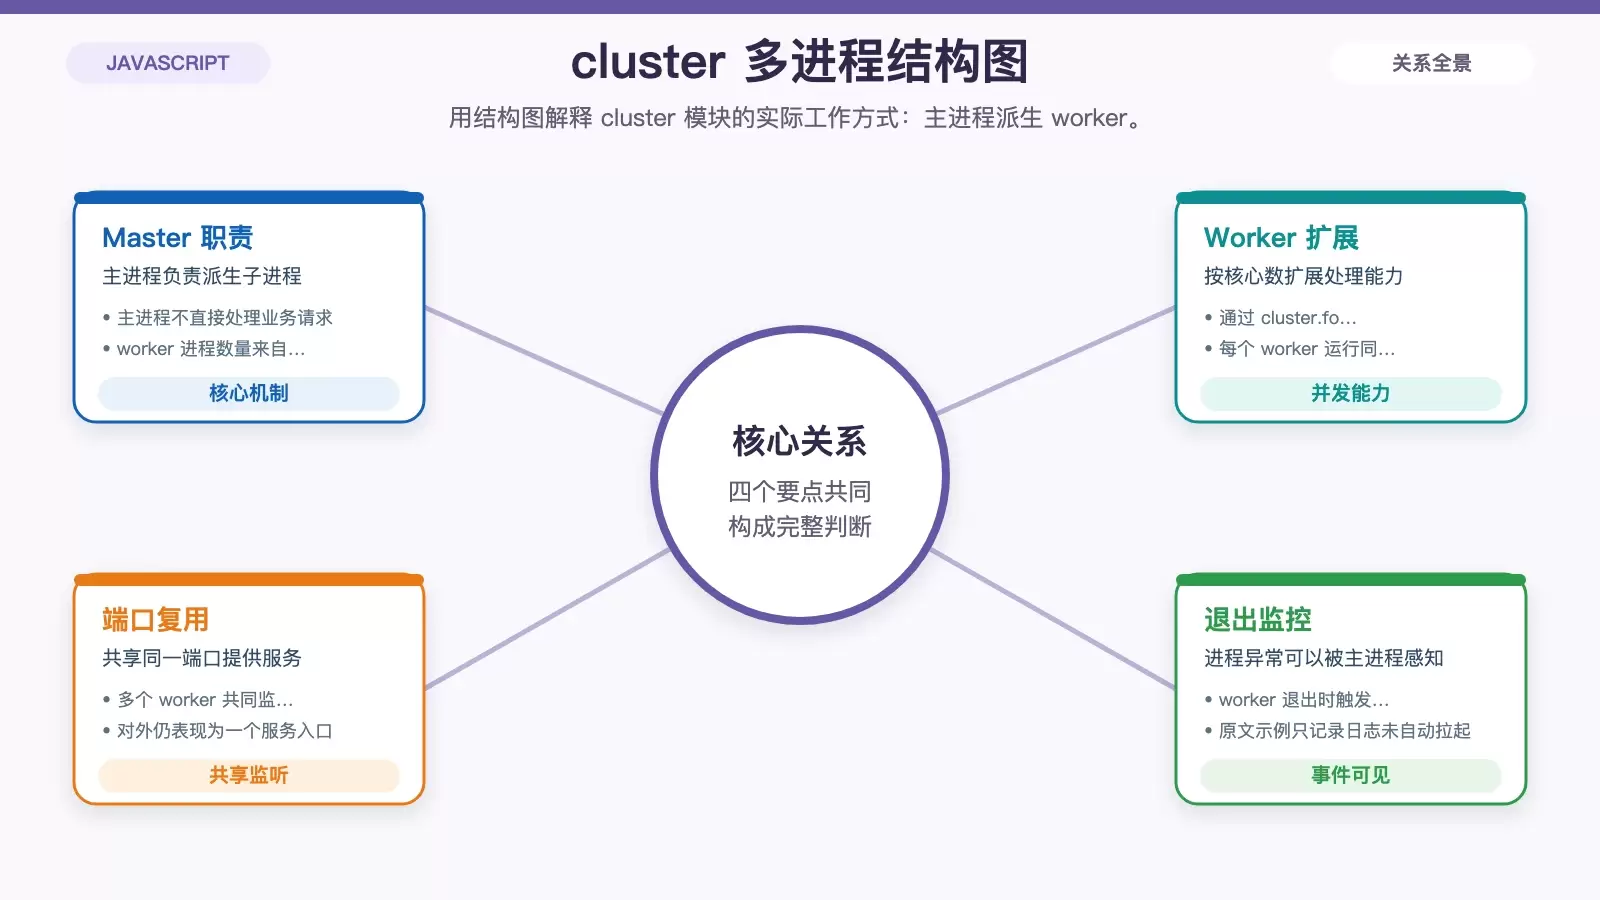
这篇文章用一套可落地的 Linux 部署流程,梳理 Node.js 从单进程应用到集群运行、PM2 托管,再到 Nginx 反向代理的完整路径。你可以据此判断:什么时候只用 cluster 即可,什么时候该把 PM2 和 Nginx 一并纳入生产环境。
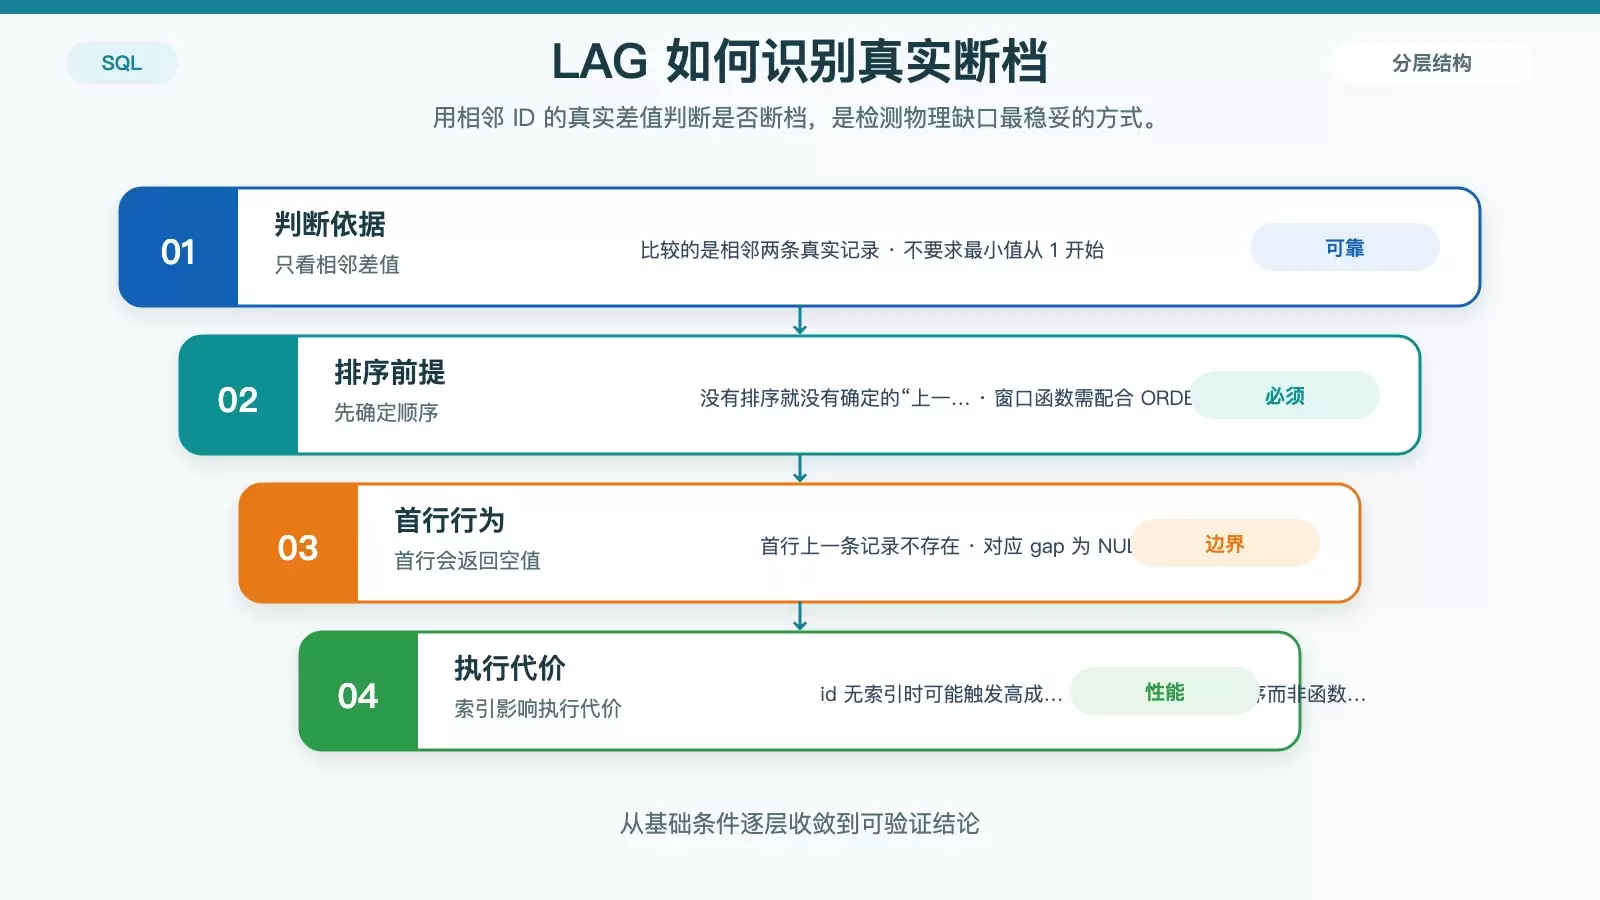
用 SQL 查序列号断档,核心不是把所有数字生出来逐个比,而是先分清你要找的是“相邻 ID 的物理缺口”还是“业务定义下的合法值缺失”。这篇文章用 LAG()、LEAD() 和反例 ROW_NUMBER() 拆解判断方法,并补上空表、NULL 与跨数据库边界处理。
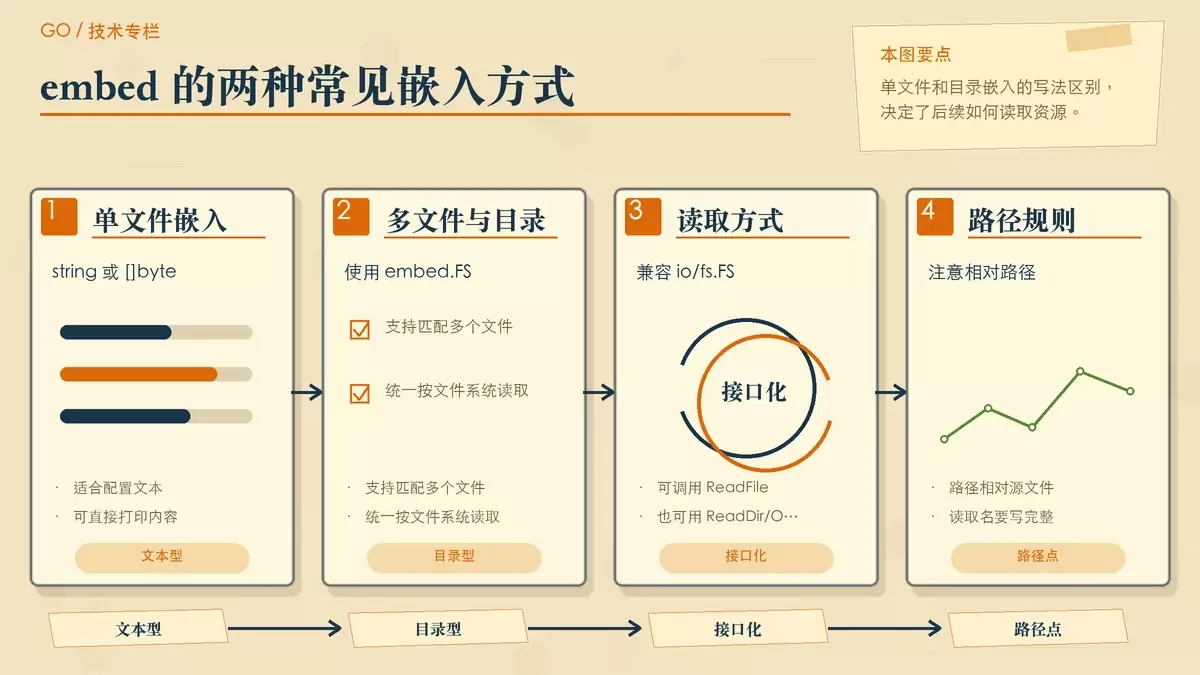
Go 1.16 引入的 `embed` 包,解决了 Go 程序分发时“二进制和静态资源分离”的老问题。本文从单文件、目录嵌入到 Web 服务和 CLI 场景,梳理它的常见用法,并说明体积、只读特性和路径管理这些实际开发里最容易踩到的边界。