


查序列号断档,很多人第一反应是先生成一整段数字,再去做左连接比对。但在真实表里,这种办法既重,又容易把“物理缺口”和“业务缺失”混为一谈。更稳妥的做法,是先明确断档的定义,再选择合适的窗口函数:用 LAG() 判断相邻 ID 是否连续,用 LEAD() 定位缺口区间,至于 ROW_NUMBER(),大多数场景下并不适合拿来判断真实断档。
用 LAG() 判断相邻 ID 是否断档
如果你要解决的问题是“当前 id 和前一个 id 之间是否少号”,那么 LAG() 是最直接也最可靠的选择。它只比较相邻行的真实值,不要求数据从 1 开始,也不假设整段 ID 本来就连续。
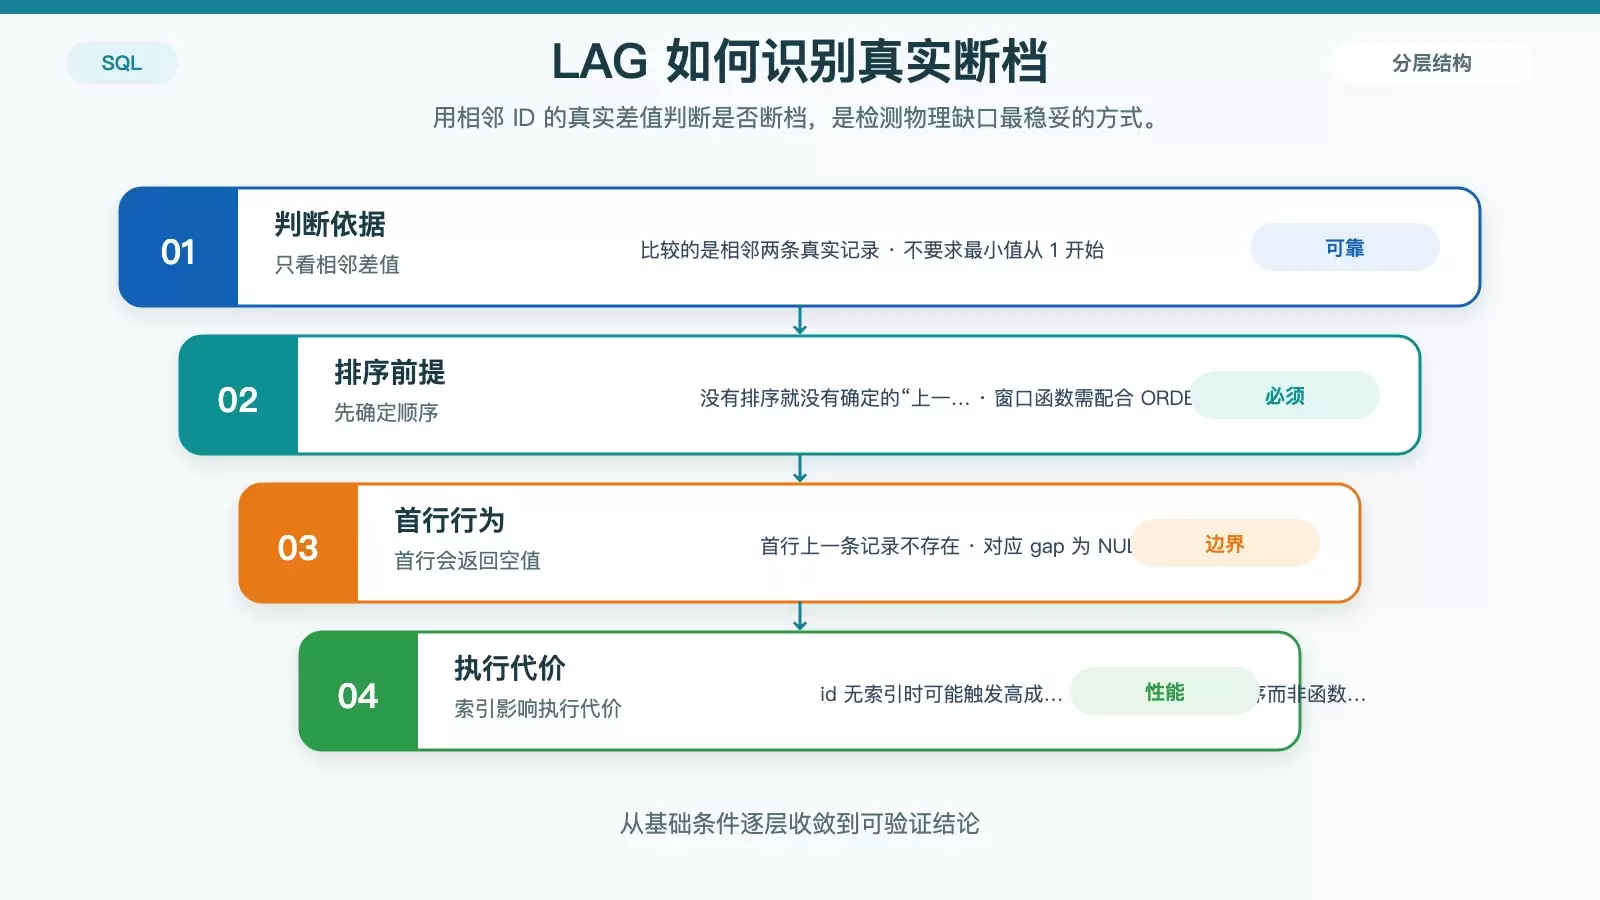
为什么 LAG() 更稳妥
LAG(id) OVER (ORDER BY id)必须配合ORDER BY id使用,否则“上一行”没有确定顺序,结果没有意义。- 它判断的是相邻两条真实记录的差值,而不是人为生成的序号,因此不会因为起始值不是 1 而失真。
- 如果
id列没有合适索引,排序阶段可能触发全表扫描或高成本排序,这往往比函数本身更影响执行效率。
基本写法与结果判断
SELECT id, id - LAG(id) OVER (ORDER BY id) AS gap
FROM t;
这里只要 gap > 1,就表示当前 id 与前一个 id 之间存在缺号。比如前一行是 4,当前行是 7,那么差值为 3,说明中间少了 5 和 6。
首行 NULL 不要误过滤
LAG() 在首行会返回 NULL,对应的差值也会是 NULL。这是正常行为,不代表数据异常。
这里有一个常见误区:直接用 WHERE gap IS NOT NULL 把首行过滤掉。这样做虽然能让结果看起来“整洁”,但会丢掉重要边界信息。比如数据第一条就是 100,而你的业务期望是从更小值开始,那么首行本身就可能意味着前段缺失。
用 LEAD() 定位缺口区间
当表里的 ID 范围很大时,例如 MIN(id)=1、MAX(id)=1000000,如果你先把 1 到 1000000 全部生成出来再做比对,内存和执行时间都可能明显上升。这种情况下,LEAD() 更适合先找出“哪一段缺了”,再决定是否展开补号。
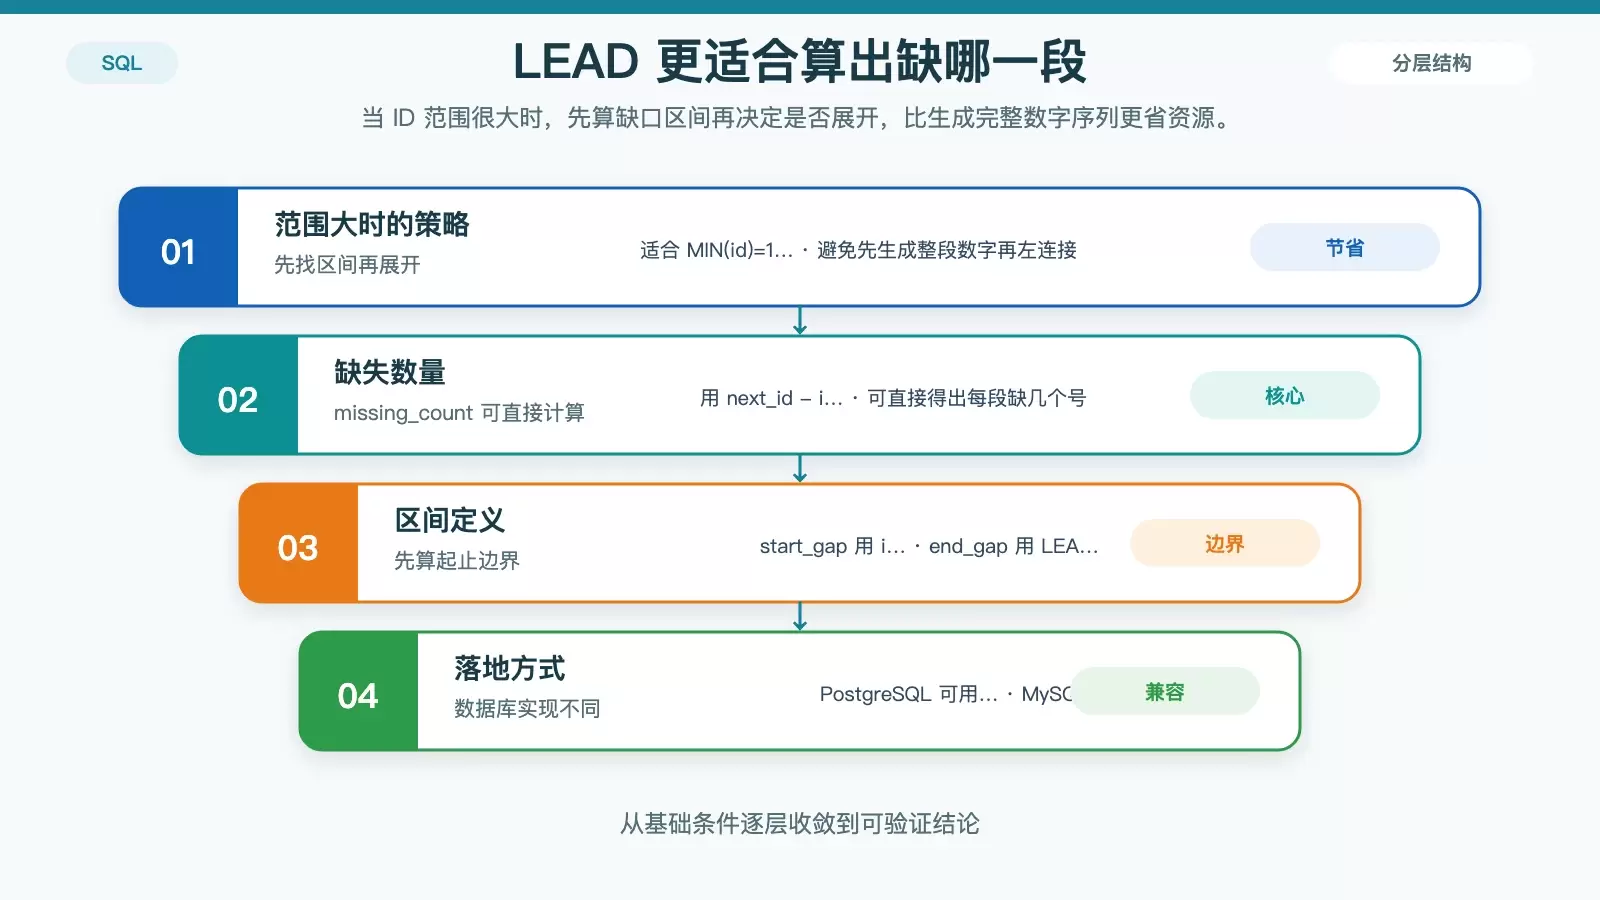
先算中间缺了多少个号
LEAD(id) OVER (ORDER BY id) 可以拿到下一行的 id。用下一行减当前行,再减 1,就能得到中间缺失的数量:
LEAD(id) OVER (ORDER BY id) - id - 1 AS missing_count
如果当前行为 4,下一行为 7,那么 missing_count 就是 2,表示中间缺了两个号。
补号前先定义缺口起止边界
如果后续还要把缺失编号真正列出来,可以直接计算每段缺口的开始和结束位置:
id + 1 AS start_gap,
LEAD(id) OVER (ORDER BY id) - 1 AS end_gap
这样你得到的不是一整串展开后的数字,而是更轻量的区间信息。例如当前 id=4、下一行 id=7,那么缺口就是 start_gap=5、end_gap=6。
PostgreSQL 和 MySQL 的补号方式不同
- PostgreSQL 可以直接使用
generate_series(start_gap, end_gap)展开区间。 - MySQL 没有同名能力时,通常要改用递归 CTE 或数字表。
- 不建议用变量去模拟连续编号逻辑,这种写法在复杂查询里很容易出错,也不够可靠。
为什么 ROW_NUMBER() 不适合检测真实断档
ROW_NUMBER() OVER (ORDER BY id) 生成的是“排序后的第几条记录”,而不是“这个位置本来应该出现什么 ID”。因此,它更像是行序号工具,不是断档检测工具。
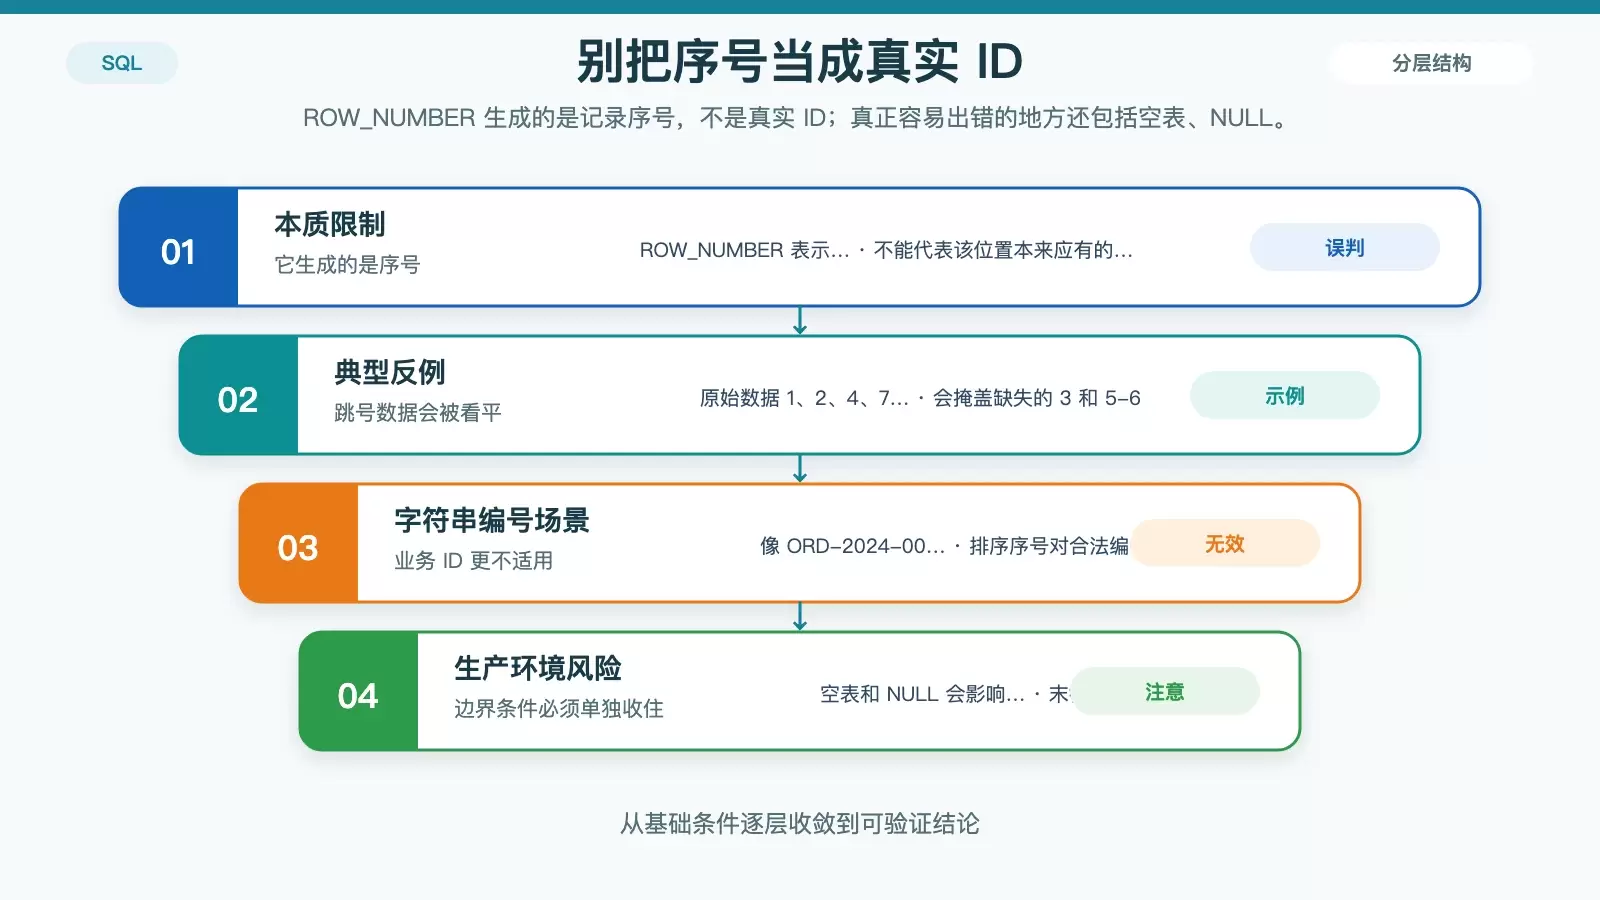
它会把跳号问题看成正常序号
假设原始数据是 1,2,4,7,那么 ROW_NUMBER() 生成的结果会是 1,2,3,4。如果你把这个结果和 id 去比较,很容易误判:最后一行 id=4 与序号 4 看起来“对上了”,但真实缺失的 3 和 5-6 却没有被正确反映出来。
业务 ID 不是纯整数时更不成立
如果表里的标识符是类似 'ORD-2024-001' 这样的业务 ID,ROW_NUMBER() 只能生成排序序号,根本不能说明合法编号是否缺失。这类场景下,必须先定义业务编号的生成规则,再谈如何找缺口。
只有极少数场景可以勉强使用
ROW_NUMBER() 只有在下面这类前提同时成立时才有参考价值:你明确知道合法 ID 集合就是 1 到 N 的整数,而且数据里只有缺失,没有重复,也没有非法值。只要这些条件有一条不满足,它就不适合作为断档判断依据。
空表、NULL 和边界值要单独处理
线上 SQL 出问题,很多时候不是窗口函数本身写错了,而是边界条件没收住。空表、NULL、末行区间、不同数据库的排序差异,都可能让结果偏掉,甚至直接报错。
空表下的 MIN() / MAX() 不能想当然
在空表上调用 MIN() 或 MAX(),返回值会是 NULL。如果你把这个结果继续传给 generate_series(NULL, NULL),就会直接报错。
WHERE id IS NOT NULL
查询最小值前,至少要先过滤掉空值;如果逻辑允许,也可以用下面这种方式防空:
COALESCE(MIN(id), 1)
不同数据库对 NULL 排序并不一致
字段里包含 NULL 时,ORDER BY 的行为在不同数据库之间并不统一。PostgreSQL 默认会把 NULL 放在前面,而 MySQL 又不支持完全相同的 NULLS LAST 语法,因此不能把默认行为当成固定规则。
ORDER BY id NULLS LAST
如果你的数据库支持,最好显式声明 NULL 的排序位置,避免相同 SQL 在不同环境下得出不同结果。
末行要防止算出无效区间
LEAD() 在最后一行同样会返回 NULL。如果你直接据此计算 start_gap 和 end_gap,就可能出现负数区间或无意义边界。补缺逻辑外层最好再包一层条件:
WHERE start_gap <= end_gap
这样可以把末行带来的无效结果过滤掉,避免后续展开区间时报错或得到脏数据。
先定义“断档”是什么意思,再选 SQL 写法
真正难的地方,通常不是 LAG()、LEAD() 该怎么写,而是你到底在找哪一种“缺失”。
- 如果你要找的是物理存储上的相邻 ID 缺口,那么
LAG()/LEAD()已经足够。 - 如果你要找的是业务规则定义下的合法值集合缺失,那么第一步不是写窗口函数,而是先把“合法集合如何生成”定义清楚,再去做比对。
换句话说,窗口函数解决的是“如何比较”,但不能替你决定“应该和谁比较”。这一步如果定义不清,SQL 写得再复杂,结果也可能不是你真正想要的断档。









