


Node.js 默认是单进程模型,代码写起来轻,但在 Linux 服务器上如果只跑一个进程,多核 CPU 往往吃不满,服务稳定性也更依赖单个进程状态。要把应用真正部署到可长期运行的环境里,通常要把问题拆成三层:先让服务能跑,再让它能利用多核,最后补上进程托管和对外入口。
下面就按这个顺序展开:先安装 Node.js 并准备一个最小示例,再用 cluster 模块把单进程扩展为多工作进程,接着交给 PM2 管理生命周期,最后通过 Nginx 反向代理对外提供访问。看完后,你可以清楚判断哪些步骤适合本地验证,哪些才是更接近生产环境的标准配置。
安装 Node.js 运行环境
开始部署前,先确认 Linux 服务器已经具备 Node.js 运行环境。原文示例使用 NodeSource 脚本安装 14.x 版本,这种方式适合快速搭建测试或示例环境。
# 使用NodeSource安装Node.js
curl -sL https://deb.nodesource.com/setup_14.x | sudo -E bash -
sudo apt-get install -y nodejs
安装完成后,系统就具备了运行 Node.js 服务和后续安装 PM2 的基础条件。
先准备一个最小 Node.js 服务
如果你手头已经有现成项目,可以直接跳到集群部分;如果只是验证部署流程,先用一个最小 HTTP 服务更直观。下面的示例监听 3000 端口,收到请求后返回 Hello World。
// app.js
const http = require('http');
const server = http.createServer((req, res) => {
  res.writeHead(200);
  res.end('Hello World\n');
});
server.listen(3000, () => {
  console.log('Server running at http://localhost:3000/');
});
这个版本只有一个进程,足够用来确认端口监听、服务启动和基础网络访问是否正常,但还谈不上把多核 CPU 利用起来。
用 cluster 模块把单进程扩展成多进程
Node.js 自带的 cluster 模块,是把单机多核利用起来的第一步。它的思路并不复杂:主进程负责派生多个工作进程,每个工作进程运行同样的 HTTP 服务,并共享同一个监听端口。
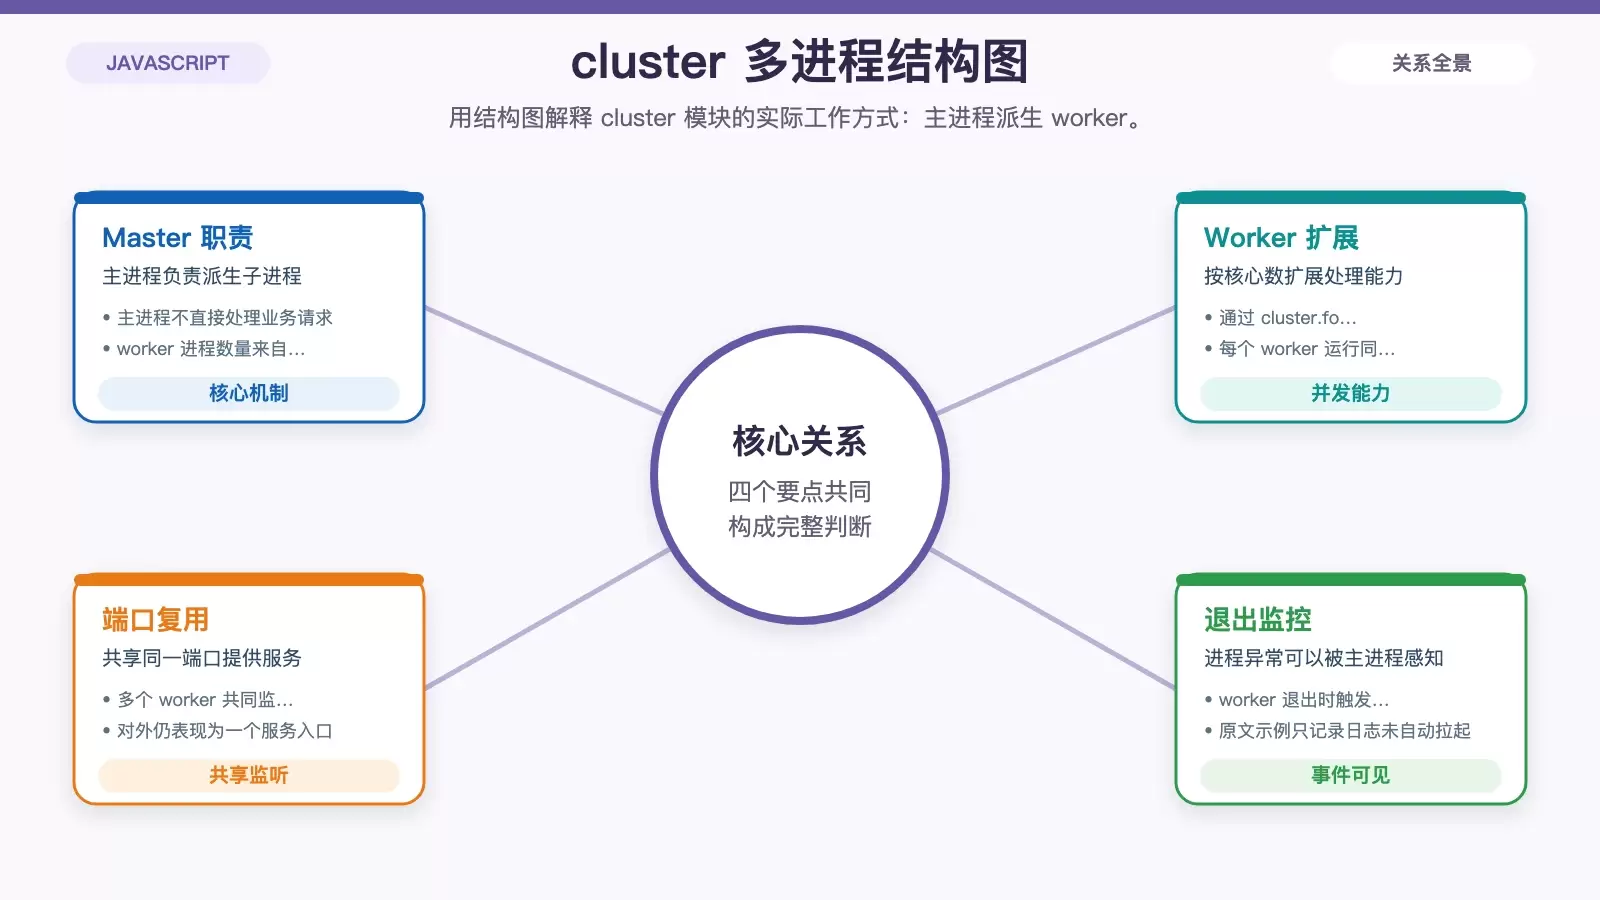
这样做的直接意义在于,应用不再只依赖单个 Node.js 进程处理所有请求,而是可以把请求分摊到多个 worker 上。
// cluster-app.js
const cluster = require('cluster');
const http = require('http');
const numCPUs = require('os').cpus().length;

if (cluster.isMaster) {
  console.log(`Master ${process.pid} is running`);

  // Fork workers.
  for (let i = 0; i < numCPUs; i++) {
    cluster.fork();
  }

  cluster.on('exit', (worker, code, signal) => {
    console.log(`worker ${worker.process.pid} died`);
  });
} else {
  // Workers can share any TCP connection
  // In this case it is an HTTP server
  http.createServer((req, res) => {
    res.writeHead(200);
    res.end('Hello World\n');
  }).listen(3000);

  console.log(`Worker ${process.pid} started`);
}
这段集群代码在做什么
这份代码里有三个关键信息:
- 通过
require('os').cpus().length获取 CPU 核心数。 - 主进程用
cluster.fork()按核心数创建 worker。 - 每个 worker 都监听同一个
3000端口,对外提供相同服务。
如果某个工作进程退出,cluster.on('exit') 会记录这一事件。原文示例只输出日志,没有继续自动拉起新进程,因此它更适合理解 cluster 工作方式,而不是直接当作完整的生产托管方案。
如何运行集群示例
保存为 cluster-app.js 后,直接执行下面的命令即可启动:
node cluster-app.js启动后通常会看到一个主进程和多个工作进程的输出日志。这说明应用已经从“单个 Node.js 进程处理所有请求”,变成“多个 worker 共同处理请求”的模式。
为什么生产环境通常还要配 PM2
只用 node cluster-app.js 可以验证 cluster 功能,但它不适合长期托管。服务退出后不会有完善的守护机制,查看状态、收集日志、批量重启也都不够方便。这个阶段就该交给 PM2。
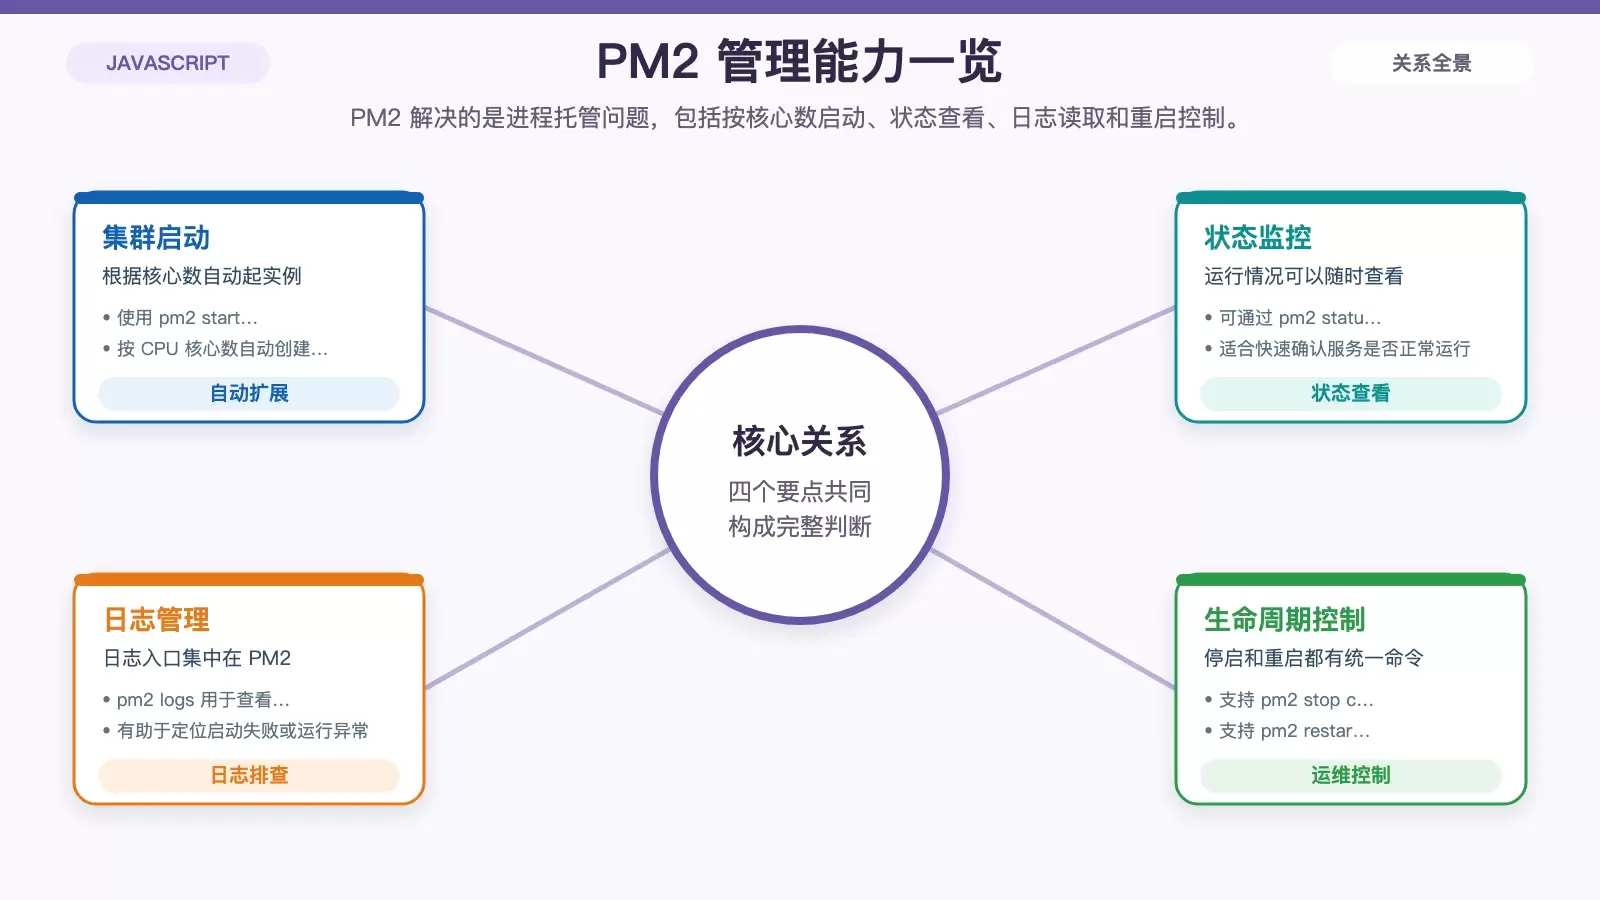
PM2 的价值不只是“后台运行”,还包括进程守护、日志查看、重启控制,以及基于多核自动拉起多个实例。
安装 PM2
sudo npm install pm2 -g用 PM2 按 CPU 核心数启动实例
原文示例里,PM2 通过 -i max 参数自动按 CPU 核心数创建工作进程。这比手动计算和维护进程数量更省事,尤其适合部署到不同规格的 Linux 主机上。
pm2 start cluster-app.js -i max查看状态和日志
上线后最常用的两个命令就是查看状态和看日志,它们直接决定了问题排查效率。
pm2 status
pm2 logs
停止与重启应用
当你需要发版、临时停机或重载服务时,可以直接使用 PM2 提供的控制命令:
pm2 stop cluster-app
pm2 restart cluster-app这一层解决的是“进程如何稳定活着”的问题。换句话说,cluster 负责把服务横向铺开,PM2 负责把这些进程真正管起来。
Nginx 反向代理为什么是常见的最后一层
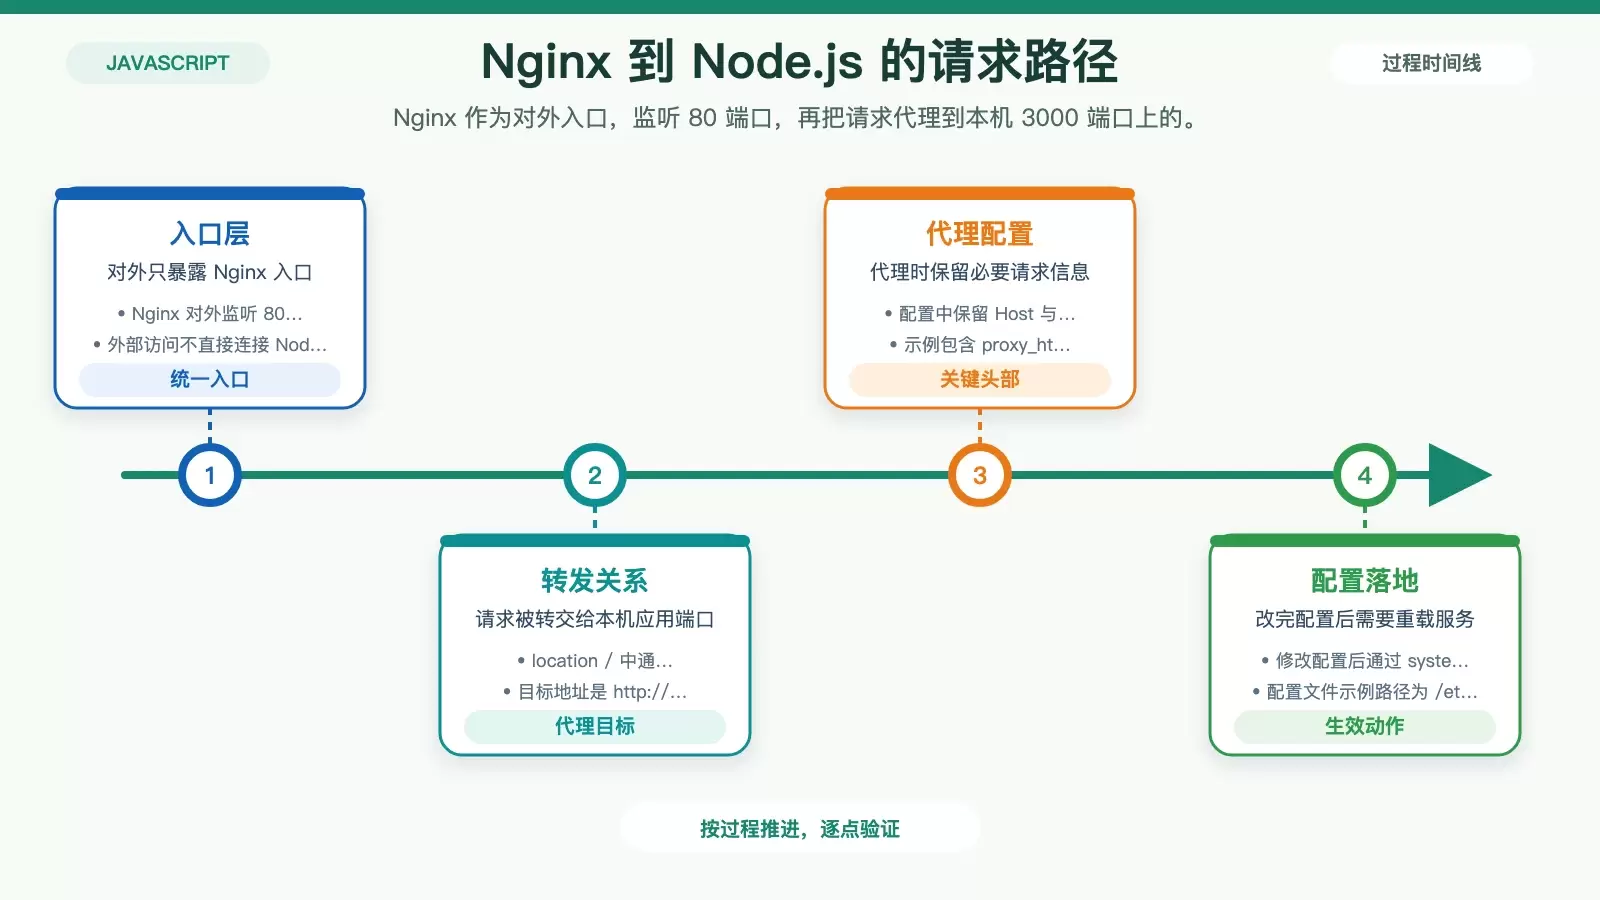
当 Node.js 服务已经能通过 PM2 稳定运行后,生产环境通常不会直接把 3000 端口暴露给外部,而是再加一层 Nginx。这样做主要有两个目的:一是由 Nginx 统一接收外部请求,二是利用它在静态文件处理、缓存和代理转发方面的能力。
安装 Nginx
sudo apt-get update
sudo apt-get install nginx
把请求转发到 Node.js 的 3000 端口
原文示例提到,Nginx 配置文件一般位于 /etc/nginx/sites-available/default。核心配置思路很简单:监听 80 端口,再把访问转发到本机的 3000 端口。
server {
    listen 80;
    server_name yourdomain.com;

    location / {
        proxy_pass http://localhost:3000;
        proxy_http_version 1.1;
        proxy_set_header Upgrade $http_upgrade;
        proxy_set_header Connection 'upgrade';
        proxy_set_header Host $host;
        proxy_cache_bypass $http_upgrade;
    }
}
这里的重点不是语法本身,而是入口职责的变化:对外暴露的是 Nginx,Node.js 则继续专注在业务逻辑和应用响应上。
重启 Nginx 使配置生效
sudo systemctl restart nginx执行完成后,请求路径就变成了“用户访问 Nginx,Nginx 再转发给 Node.js 集群服务”。到这一步,一个更接近生产可用的部署结构就成型了。
这套部署流程适合解决什么问题
把整篇流程串起来看,可以把职责划分得很清楚:
- 单进程 Node.js 服务:先验证应用本身能正常监听和响应。
cluster模块:让应用利用多核 CPU,把请求分摊给多个 worker。- PM2:负责托管进程、查看状态、管理日志和重启操作。
- Nginx:作为统一入口,对外提供反向代理能力。
如果你只是本机测试,跑到 node cluster-app.js 这一步就足够;如果目标是长期运行的 Linux 服务,那么 PM2 和 Nginx 基本就是后续必须补齐的两层。









