


很多人遇到“视图查不到最新数据”时,第一反应是怀疑视图有缓存、刷新不及时。实际在大多数数据库里,普通视图每次执行都会重新运行底层 SELECT,问题往往出在事务、复制、物化机制或外围同步链路上。本文按最常见的几类原因展开,帮助你快速判断自己看到的旧数据,究竟是隔离级别的正常结果,还是系统设计里某个环节已经失效。
普通视图本身通常不是问题
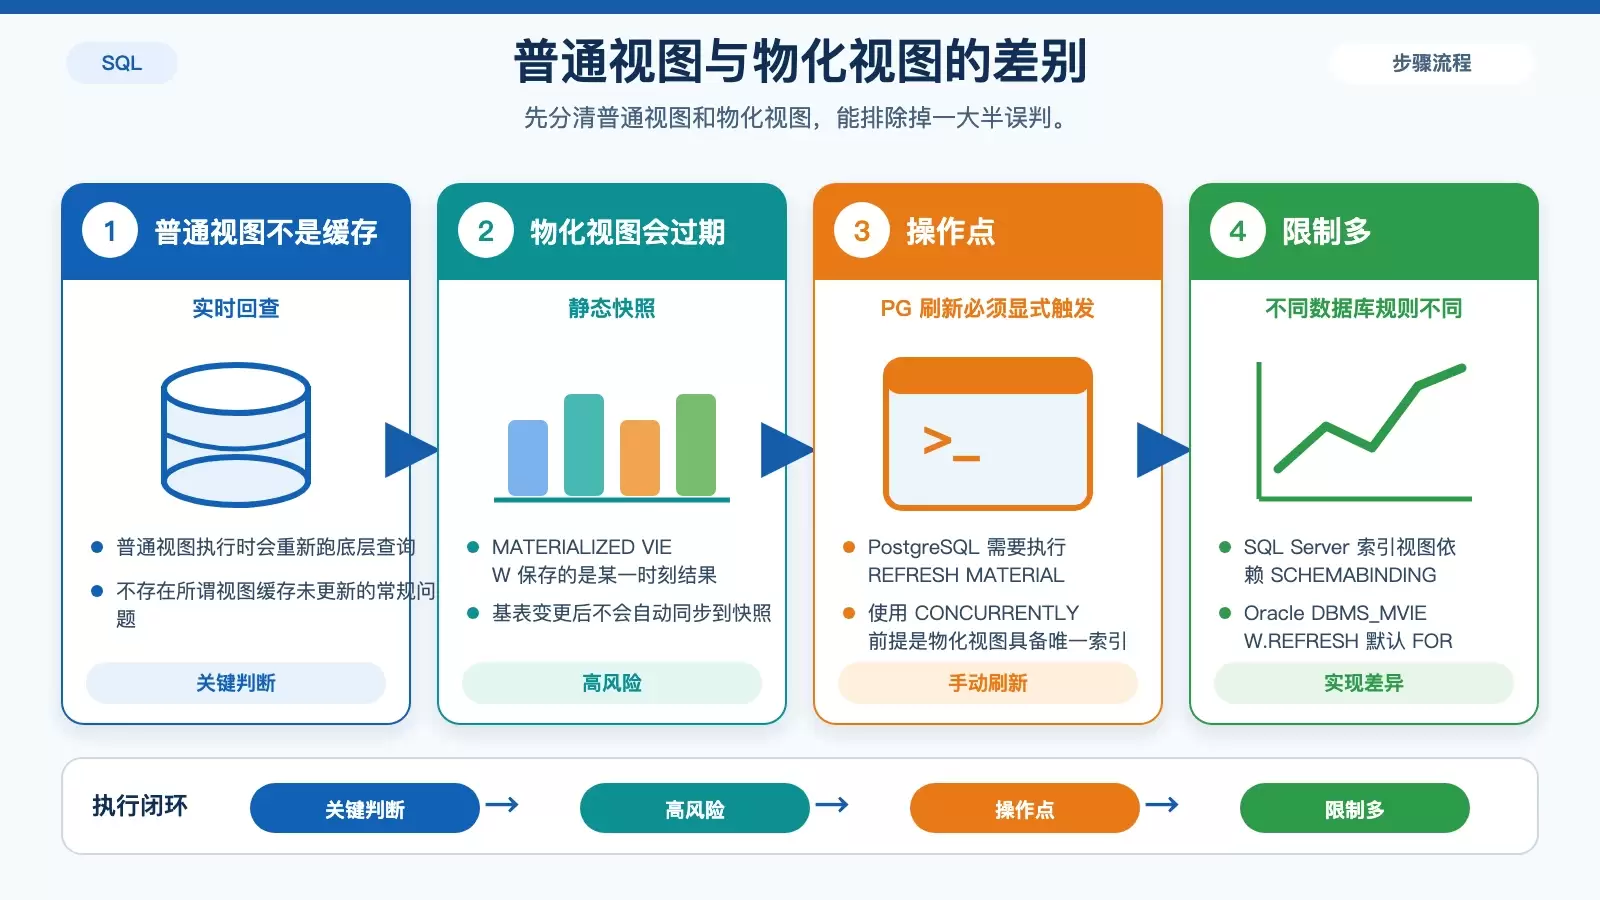
先明确一个前提:普通视图不是缓存层。它本质上只是把查询语句封装起来,执行视图时,数据库仍会回到底层表重新计算结果。
所以,当你发现视图没有返回“最新数据”时,优先排查的方向不该是“视图没刷新”,而应该是下面几类情况:
- 数据还在未提交事务里,当前会话本来就看不到
- 你查到的并不是普通视图,而是物化视图或索引视图快照
- 连接打到了从库,复制尚未追平
- 视图依赖的触发器、预计算表已经静默停更
先排查:是不是未提交事务导致的旧快照
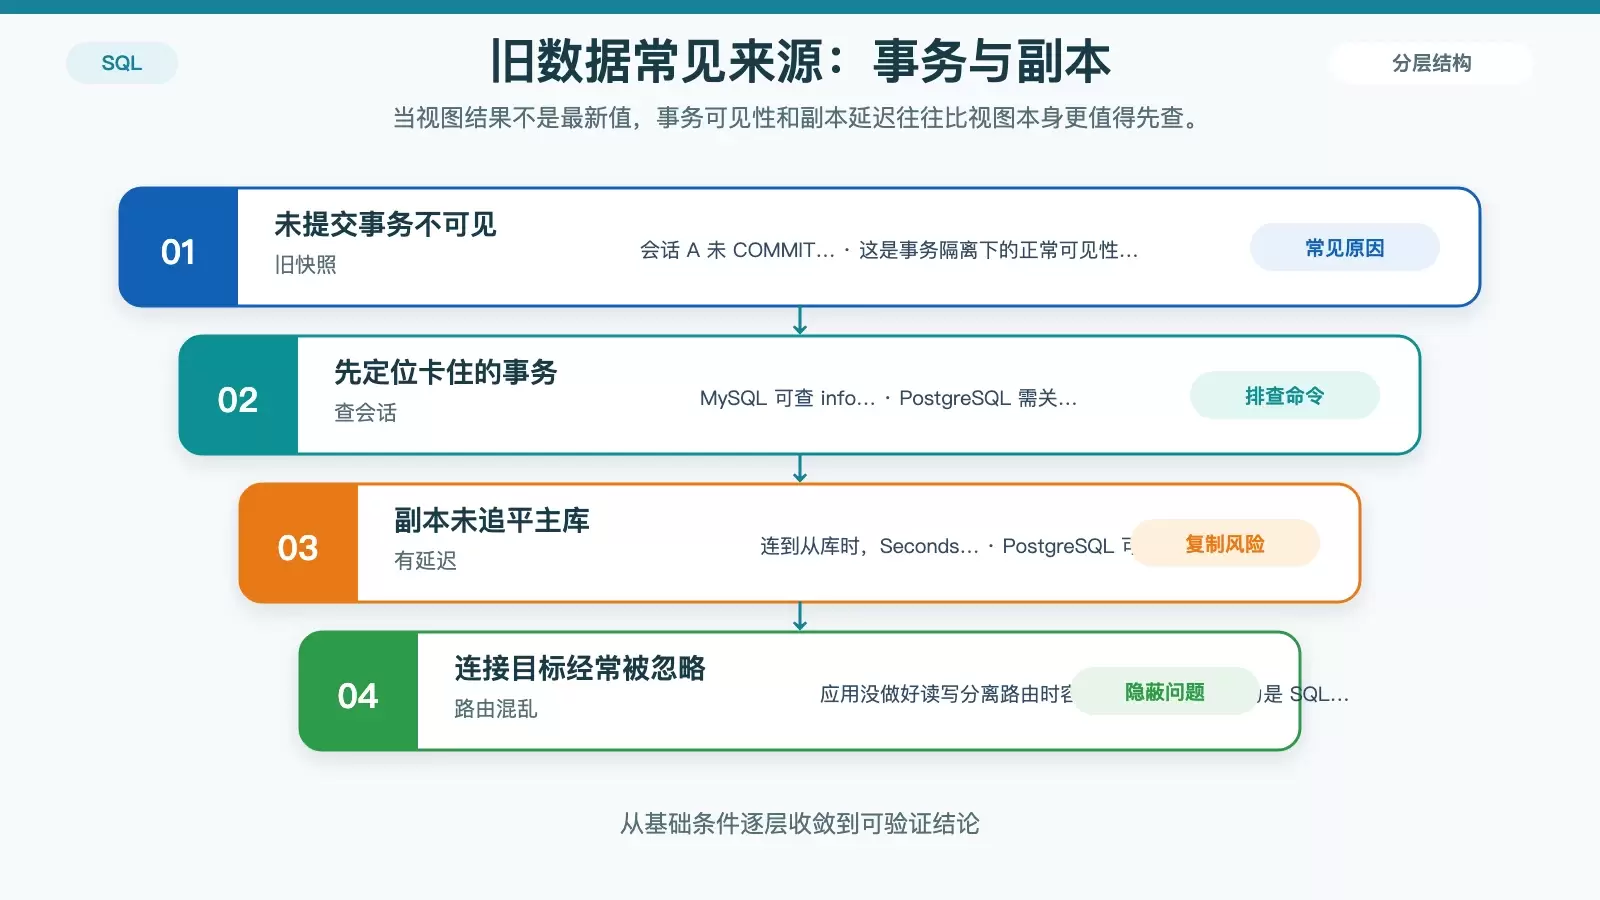
如果会话 A 插入或更新了数据,但还没有 COMMIT,那么会话 B 去查视图,看不到这些变化是正常现象。这不是视图延迟,而是事务隔离级别决定的可见性规则。
MySQL 怎么查
可以先看当前是否有仍在运行、尚未结束的事务:
SELECT * FROM information_schema.INNODB_TRX WHERE trx_state = 'RUNNING'如果目标写入操作仍挂在事务里,视图查询结果自然不会更新。
PostgreSQL 怎么查
PostgreSQL 可以从活动会话里找事务状态,尤其要注意那些长期不提交的连接:
SELECT pid, state, query FROM pg_stat_activity WHERE state = 'active'排查时要重点关注 idle in transaction。这类连接看起来“不忙”,但事务并没有结束,往往就是旧快照持续存在的原因。
不要误判连接超时
还有一个常见误区是,以为连接断开或超时后数据库会自动 ROLLBACK。实际情况未必如此,很多场景只是断开连接,不等于事务已经按你预期清理完成,因此仍需要人工确认和处理。
很多问题其实出在物化视图,而不是普通视图
如果你查的不是普通视图,而是 MATERIALIZED VIEW、索引视图或其他预计算对象,那么“看不到最新数据”就很可能是预期行为。因为这类对象保存的是某个时刻的快照,不会像普通视图那样每次都实时回表查询。
PostgreSQL:必须显式刷新
在 PostgreSQL 里,物化视图不会自动跟随基表变化。要拿到新结果,必须手动刷新:
REFRESH MATERIALIZED VIEW CONCURRENTLY my_mvCONCURRENTLY 方式需要唯一索引支持,否则无法使用。
SQL Server:索引视图有严格前提
SQL Server 的索引视图虽然可以实时反映变更,但前提并不宽松。创建时必须使用 SCHEMABINDING,并满足一系列限制条件。只要对象定义不符合要求,就不能把它当成“天然实时”的普通视图来理解。
Oracle:注意刷新策略可能静默退化
Oracle 中执行 DBMS_MVIEW.REFRESH 时,如果没有明确指定 method 参数,默认使用 FORCE。这意味着刷新失败时,可能会悄悄退化成 COMPLETE,但外部又没有建立告警,最终给人的感受就是“视图还在工作,只是数据总不对”。
再看连接目标:是不是查到了延迟从库
在有主从复制或读写分离的系统里,很多“视图不更新”的现象,本质上只是读请求落到了从库,而从库复制还有延迟。你以为自己看到的是最新状态,实际上读到的是几秒前的副本数据。
MySQL:重点盯复制延迟
MySQL 可通过以下命令检查从库状态:
SHOW SLA VE STATUSG其中 Seconds_Behind_Master > 0,就说明当前副本还没有追上主库,视图结果不是最新值也就不奇怪了。
PostgreSQL:确认当前节点是否仍在恢复
在 PostgreSQL 从库上,可以执行:
SELECT pg_is_in_recovery(), pg_last_wal_receive_lsn(), pg_last_wal_replay_lsn()这组信息可以帮助你判断当前节点是不是只读副本,以及 WAL 接收与回放是否存在差距。
应用层路由问题更隐蔽
如果应用没有明确做读写分离路由控制,或者连接池把只读连接和主库连接混在一起使用,这类问题会非常难定位。开发者往往只看到“SQL 没问题、视图也没问题”,却忽略了请求实际根本没打到主库。
最后检查依赖链路:是不是触发器或预计算表停更了
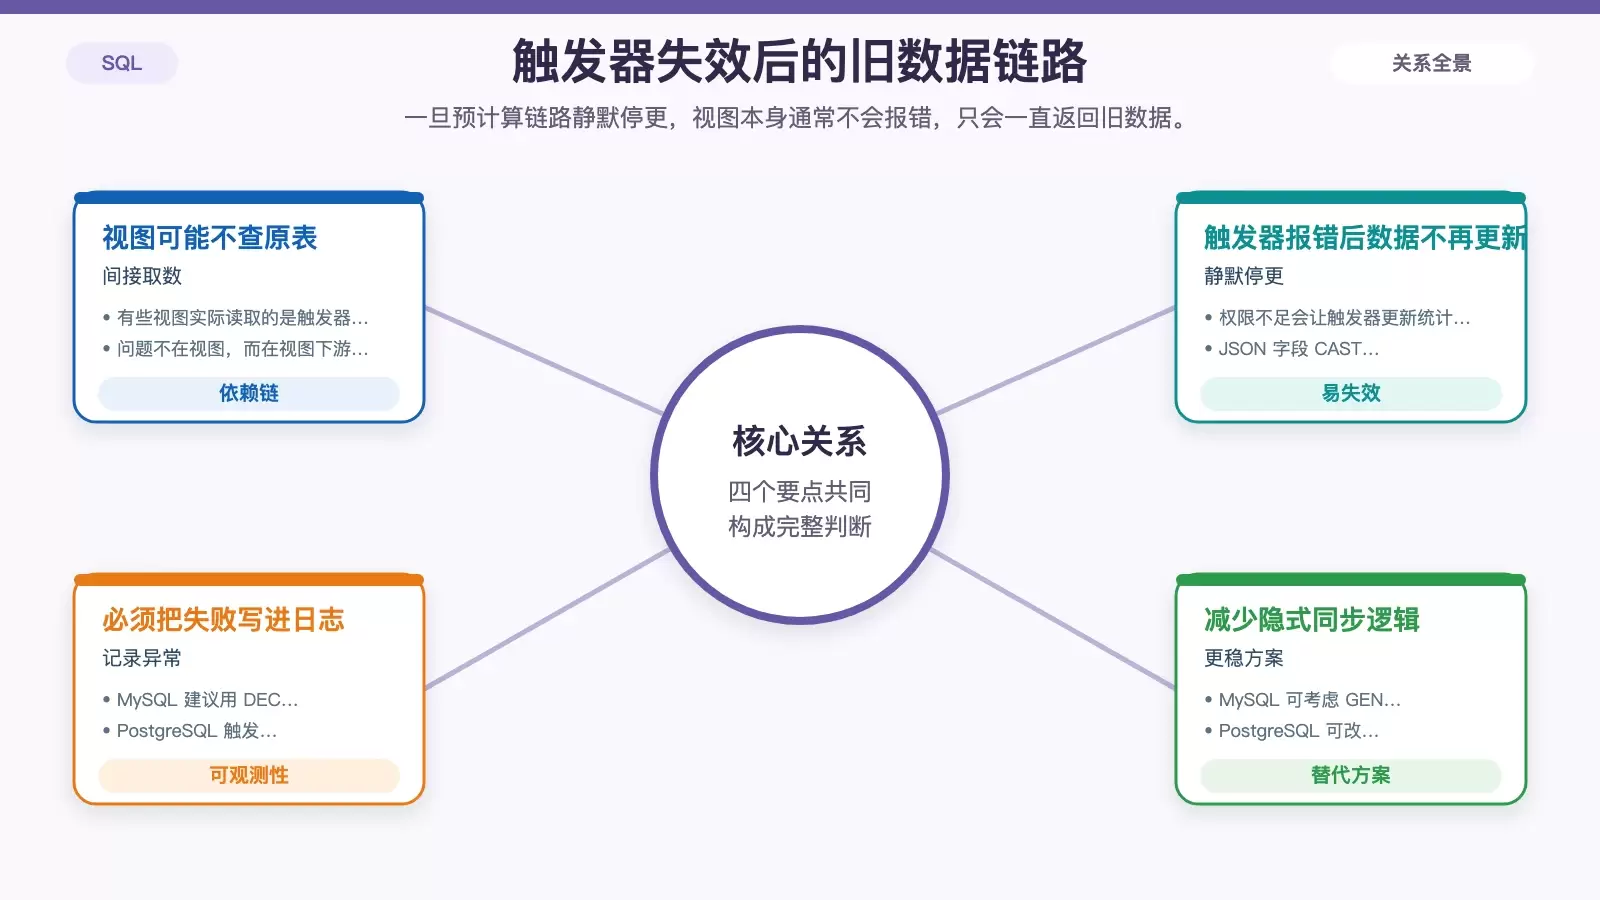
有些系统虽然表面上是“查视图”,但视图底层读的并不是原始业务表,而是触发器维护的预计算表、统计表或聚合表。这样一来,只要触发器执行失败,视图就会继续返回旧结果,而且通常不会主动报错。
为什么这种问题最难发现
典型场景是:触发器负责把增量结果写入统计表,视图再从统计表读取。一旦触发器因为权限不足、JSON 字段 CAST 失败等原因中断,统计表就不再更新,但视图本身依然可查询,于是外部只会看到“数据一直是旧的”。
MySQL:给触发器加错误处理和日志
在 MySQL 里,触发器应通过 DECLARE EXIT HANDLER 捕获具体错误码,并把异常写入日志。否则触发器失败后,很容易只留下结果不更新的表象。
PostgreSQL:触发器函数要显式兜底
PostgreSQL 中,触发器函数最好使用 BEGIN ... EXCEPTION 块处理异常,而不是单纯依赖默认中断行为。至少要让失败原因可追踪,否则排查时只能看到静默失效后的旧数据。
能不用触发器时,尽量换更稳的机制
如果业务允许,更稳妥的办法通常是减少这类隐式同步逻辑。例如:
- MySQL:使用
GENERATED ALWAYS AS (subquery) STORED - PostgreSQL:采用定期
REFRESH MATERIALIZED VIEW
这类方案未必总是更快,但在可维护性和可观测性上,往往比“触发器 + 预计算表 + 视图”更可靠。
实战判断顺序:先确认对象类型,再查事务和副本
遇到视图查不到最新数据时,建议按这个顺序判断:
- 先确认自己查的是普通视图,还是物化视图、索引视图、预计算结果表
- 再检查写入事务是否真的已经
COMMIT - 确认查询连接到底落在主库还是从库
- 最后回头查视图依赖的触发器、统计表、刷新任务是否已经停更
最容易漏掉的,恰恰是你根本没意识到自己查的不是普通视图,而是已经过期的物化视图,或者某次异常后静默失效的触发器链路。它不会报错,也不会提醒,只会持续返回旧数据。









