

Pandas中列表转数据框的两种核心方法
本文详解Pandas中将列表转换为数据框的两种场景:多列表合并与嵌套列表转换。通过字典映射和转置操作,展示如何将普通列表或包含子列表的结构高效转化为标准DataFrame格式,适用于数据清洗与预处理环节。
2026-10-13
14

本文详解Pandas中将列表转换为数据框的两种场景:多列表合并与嵌套列表转换。通过字典映射和转置操作,展示如何将普通列表或包含子列表的结构高效转化为标准DataFrame格式,适用于数据清洗与预处理环节。
本文介绍了Python中利用io模块的StringIO和BytesIO类在内存中高效读写字符串及二进制数据的方法,并通过numpy库演示了如何将二进制文件数据读取并转换为float32类型。内容涵盖基础内存操作及具体的数组处理代码示例,适用于需要高性能数据处理的场景。
本文详细解析使用Python实现仿射密码(Affine Cipher)的完整流程。内容涵盖加解密核心公式、字符与数字映射字典的构建、模26下a的逆元计算方法,以及完整的编码和解码代码实现。通过具体示例展示如何输入参数a和b对明文进行加密,以及如何利用逆元还原密文,适合初学者理解古典密码学在编程中的实际应用。

本文详解如何利用Python结合ADB和Monkey工具,构建一套针对Android ROM的自动化稳定性测试方案。重点解决Framework层权限管控下的应用安装卸载、后台指令下发及黑屏复现问题。通过自动化脚本收集Logcat、内存及CPU数据,高效定位Binder故障与内存泄露,为开发提供精准复现路径。
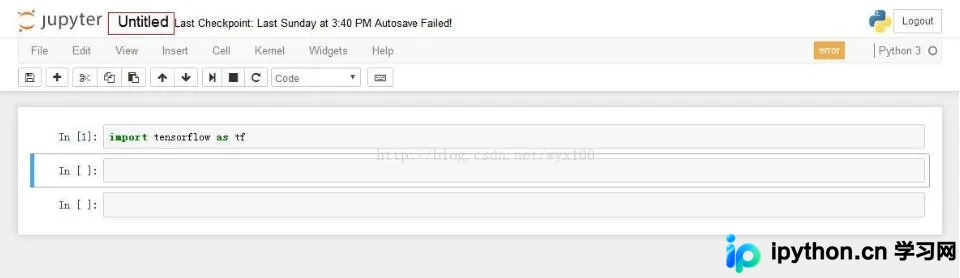
本文详细介绍在Jupyter Notebook环境中修改文件名的具体操作步骤,并针对非root用户启动时可能遇到的文件创建被拒绝(Creating Notebook Failed)问题,提供通过sudo chown命令修正用户权限的解决方案,确保环境正常使用。
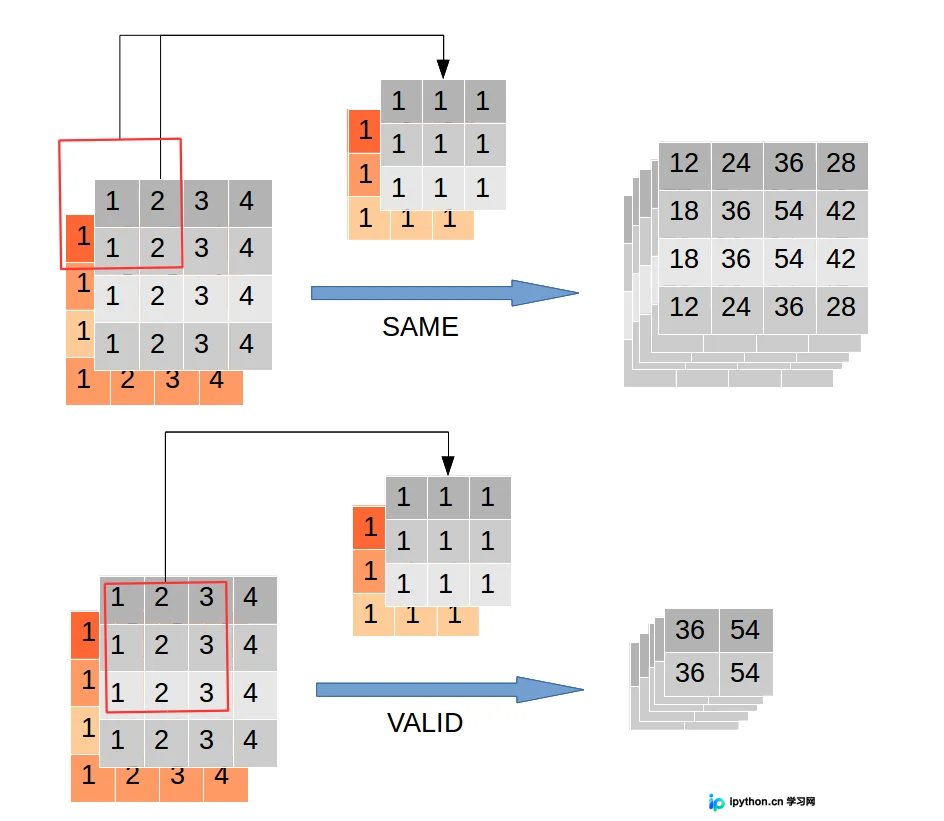
本文深入解析TensorFlow中tf.nn.atrous_conv2d函数的实现原理,重点讲解rate参数如何控制采样间隔以扩大感受野。通过对比rate=1与普通卷积,以及rate=2在SAME和VALID模式下的输出差异,直观展示空洞卷积机制。文章包含完整代码示例与结果分析,帮助开发者掌握该技术在语义分割中的应用。
本文介绍在Spyder的IPython Console中运行带有命令行参数的Python脚本的两种方法。通过修改runfile函数的args参数,或在控制台直接使用run命令配合脚本路径及参数,可解决程序依赖外部参数运行的问题,无需切换至CMD即可实现本地调试。
在Spyder或IPython中处理大型数组时,默认输出会被省略号截断。本文介绍如何通过np.set_printoptions设置threshold参数来完整显示数组内容,并补充了reset和clear命令用于清理变量和控制台记录的实用技巧。
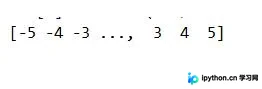
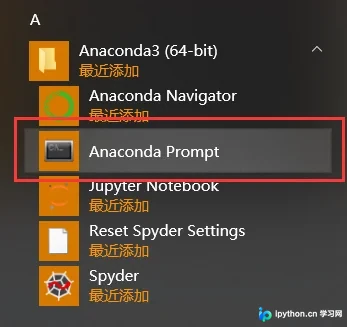
本文详细讲解如何在Anaconda3环境下,通过配置清华大学开源软件镜像源来安装TensorFlow CPU版本。内容涵盖环境创建、镜像配置、库安装、版本验证以及在Jupyter Notebook中的集成使用方法,帮助开发者快速搭建本地AI开发环境。
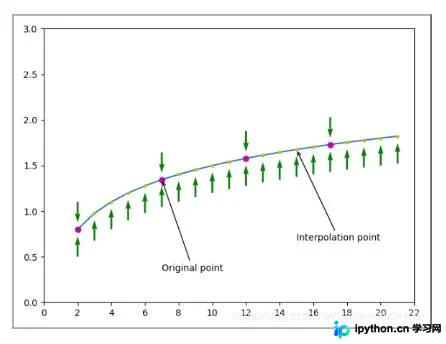
本文通过Python的matplotlib模块,演示如何绘制包含曲线、离散点、注释文本及箭头的图形。详细解析了plt.plot、plt.annotate、plt.quiver等核心函数的参数用法,以及坐标轴范围设置和子图创建方法,帮助开发者快速掌握基础绘图技巧。
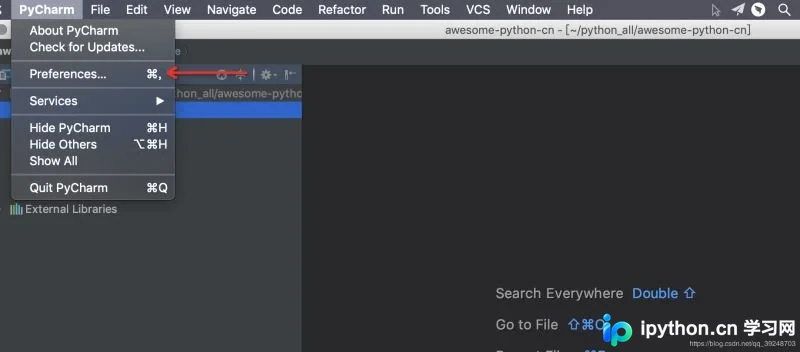
本文详细介绍在 Mac 版 PyCharm 中配置 .gitignore 文件的步骤。通过安装 .ignore 插件,利用内置模板快速生成 Python 项目的忽略规则文件,帮助开发者高效管理 Git 版本控制,避免提交不必要的文件。
本文详解在 Jupyter Notebook 中导入自定义 Python 模块的两个关键注意事项:模块必须保存为 .py 格式,且修改源码后需重启内核以生效。针对频繁修改场景,提供了使用 importlib 模块进行热重载的解决方案,避免重复加载大数据导致的耗时问题,提升开发效率。