Python递归调用返回None的排查与修复
本文分析Python递归函数在解析邮件内容时意外返回None的问题。通过对比原始代码与修改后的代码,指出在递归调用处缺少return语句是导致结果丢失的关键原因。修复方法是在递归调用前添加return,确保最终解析内容能逐层正确返回至顶层调用。
2026-10-13
14

本文分析Python递归函数在解析邮件内容时意外返回None的问题。通过对比原始代码与修改后的代码,指出在递归调用处缺少return语句是导致结果丢失的关键原因。修复方法是在递归调用前添加return,确保最终解析内容能逐层正确返回至顶层调用。
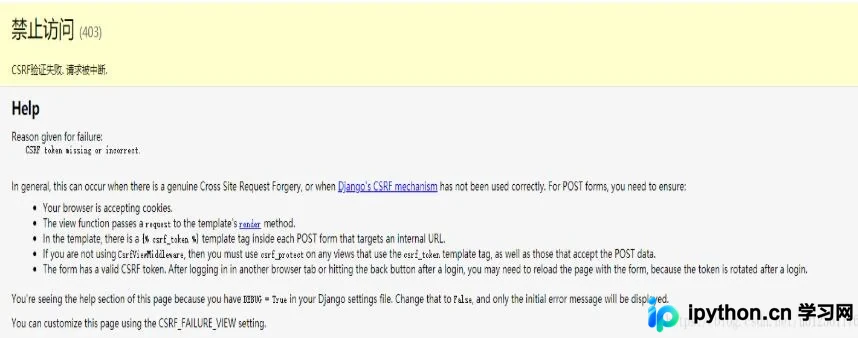
本文详细解析Django中常见的CSRF token missing or incorrect报错原因及解决方案。涵盖检查settings.py中的中间件配置、在模板中添加{% csrf_token %}标签,以及深入剖析Django CSRF验证机制中Secret与Token的关系,帮助开发者快速定位并修复跨站请求伪造保护相关的错误。
本文详解Python3中sorted函数废弃cmp参数的原因,介绍如何使用functools.cmp_to_key将自定义比较函数转换为key参数。通过LeetCode最大数题目示例,展示如何将旧版cmp逻辑适配至Python3环境,并解析富比较方法演进历史。
本文深入解析Python Num库中多维数组的实现原理,重点介绍ndarray对象的内存布局、形状与数据类型特性。详细阐述利用np.array、zeros、ones、arange等函数创建数组的方法,以及通过astype进行类型转换的注意事项,帮助开发者高效掌握数值计算基础。
本文介绍在Windows系统中使用Python的you-get库批量下载Bilibili视频的方法。重点说明通过pip安装you-get,避免使用conda命令。提供命令行下载单个及批量视频的指令,包括使用--playlist参数。此外,还补充了在Python代码中调用you-get进行下载的示例,涵盖参数设置与常见报错处理。
本文系统梳理Python标准库os模块的核心功能,涵盖文件创建、读写模式、目录管理及路径解析等常用函数。通过具体代码示例,详解os.name、os.uname、os.path系列方法的使用场景与返回值,帮助开发者高效进行跨平台系统交互与文件管理。
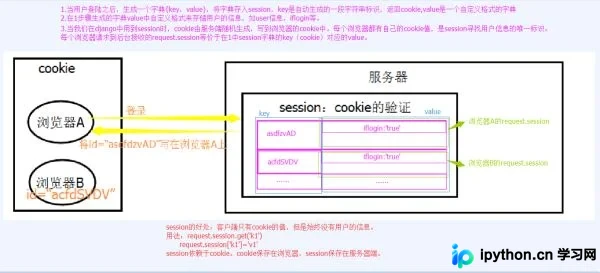
本文详细介绍Django中Session的完整操作流程,涵盖数据库表初始化、读写删除API、过期时间设置及五种存储后端配置。深入解析Session ID生成机制与Cookie交互原理,帮助开发者掌握Django会话管理的核心技术与最佳实践。
本文介绍在 Django 中自定义 404 和 500 等错误页面的两种方法。首先需关闭 DEBUG 模式,随后可通过创建特定命名的模板文件(如 404.html)实现简单配置,或在 urls.py 中设置句柄以实现更个性化的错误处理。
本文详细介绍Python3中xml.etree.ElementTree模块支持的有限XPath表达式语法。内容涵盖标签名、通配符、属性过滤、文本匹配及位置索引等核心用法,并通过具体代码示例演示如何在XML文档中精准定位子元素、孙子元素及特定属性节点,帮助开发者高效进行XML数据提取与处理。
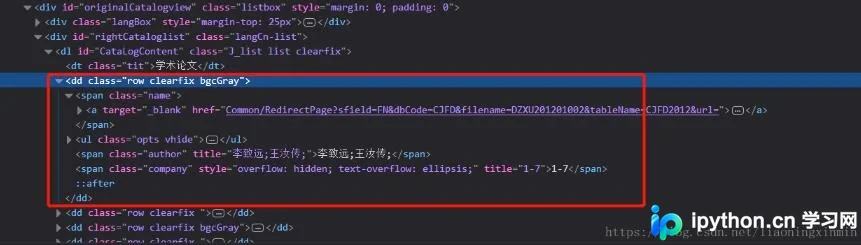
本文介绍如何使用Python的lxml库通过XPath定位HTML文档中的特定元素,并解决提取内容中出现的中文乱码问题。通过html.tostring获取字节流后,利用HTMLParser.unescape方法将HTML实体编码转换为可读字符串,从而完整保留原始文本内容。
本文通过五个Python代码实例,详解如何使用requests库进行网络爬虫开发。内容涵盖普通页面爬取、模拟浏览器请求规避限制、搜索引擎关键词抓取、图片保存以及IP地址归属地查询,提供完整代码与参数解析,帮助开发者快速掌握网络数据提取核心技巧。
本文汇总了Appium自动化测试中高频使用的ADB命令。内容涵盖设备连接检查、APK安装与卸载、进程管理、Shell基础操作、文件双向传输以及基于包名的Logcat日志过滤技巧,帮助测试人员提升Android测试效率。