

Python Selenium 通过 CDP 协议获取接口响应数据
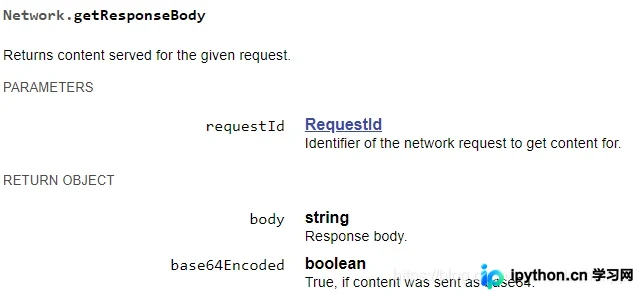
本文介绍如何在 Python Selenium 中通过 Chrome DevTools Protocol (CDP) 获取接口数据。Selenium 本身不提供直接查询接口响应的方法,但可通过配置性能日志(performance logging)捕获 requestid,进而调用 Network.getResponseBody 命令提取特定 URL 的完整响应内容。
2026-10-14
10

本文介绍如何在 Python Selenium 中通过 Chrome DevTools Protocol (CDP) 获取接口数据。Selenium 本身不提供直接查询接口响应的方法,但可通过配置性能日志(performance logging)捕获 requestid,进而调用 Network.getResponseBody 命令提取特定 URL 的完整响应内容。
本文详细介绍Python中BeautifulSoup库的核心查找方法find和find_all。通过构建实例、解析HTML结构,演示如何精准定位标签、提取文本与属性。重点讲解处理class关键字冲突的技巧,以及find_all在批量提取数据时的灵活应用,帮助开发者高效完成网页数据抓取任务。
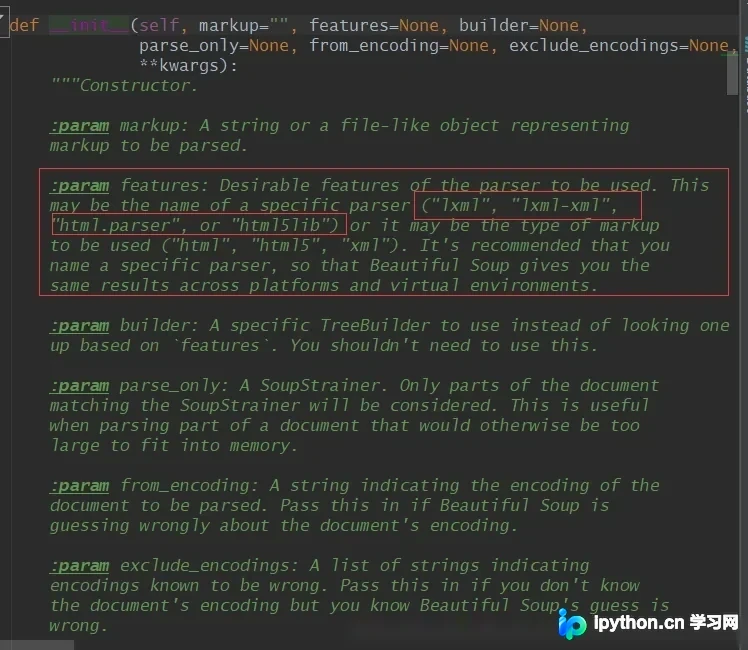
本文详细介绍Python内置函数help()的语法与使用方法。通过对比dir()函数,阐述如何利用help()查看模块、类及具体函数的帮助文档。文中包含查看for关键词、tkinter包及具体方法的具体代码示例,帮助开发者快速掌握Python官方文档查询技巧。
本文详细解析Scrapy中请求头部的生成机制与覆盖优先级。从自动添加的User-Agent和Accept-Encoding,到settings.py中的DEFAULT_REQUEST_HEADERS配置,再到Request对象及下载中间件中的自定义Header,层层剖析其生效顺序。特别指出Referer中间件的最高优先级特性及关闭方法,帮助开发者精准控制HTTP请求头部。
本文介绍如何使用 Python 的 subprocess 模块配合 stdout=subprocess.PIPE 实现子进程日志的实时读取。通过轮询 p.poll() 状态并逐行读取 stdout,可避免缓冲区阻塞,确保主进程能即时捕获子进程的输出内容。
本文通过Python脚本导入CSV数据至Oracle数据库,对比测试使用与不使用绑定变量时的执行耗时,以及开启数据库审计功能前后的性能差异。实验结果显示,未使用绑定变量会使运行时间增加约2.54倍,而开启审计功能后性能下降约2.32倍,且审计表sys.aud$占用大量表空间。建议生产环境尽量使用绑定变量并谨慎开启审计,可考虑通过堡垒机替代原生审计功能。
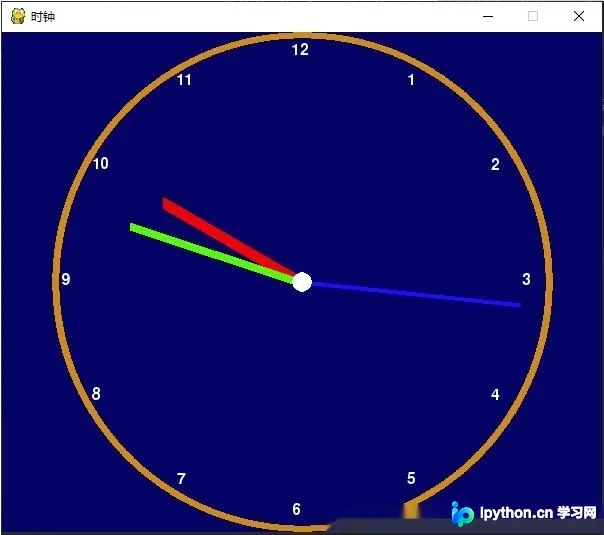
本文介绍如何使用Python的Pygame库绘制一个动态运行的时钟。通过初始化窗口、定义几何参数并利用datetime模块获取当前时间,计算时针、分针和秒针的角度与坐标,实现指针的实时移动。代码包含完整的界面绘制、数字标注及交互逻辑,适合Python图形编程入门学习。
本文介绍在 Windows 环境下使用 Python 获取和设置剪切板内容的两种方法。第一种通过 win32clipboard 直接读取文本;第二种封装为类并模拟 Ctrl+V 粘贴操作,适用于需要结合键盘模拟的自动化场景。
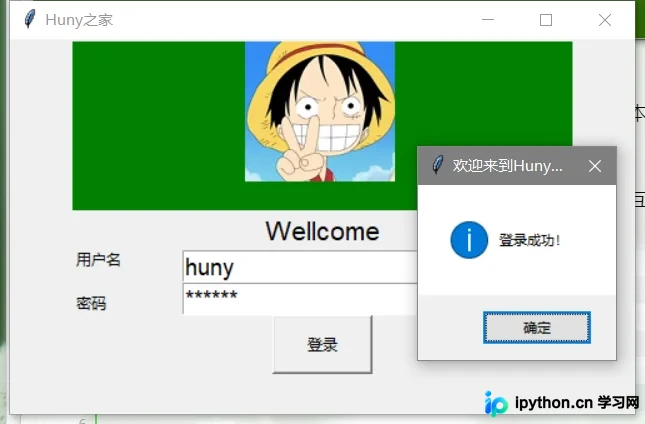
本文详细介绍Python标准GUI库Tkinter的使用方法,涵盖Button、Label等15种基础控件及其属性设置。解析pack、grid、place三种几何管理器的布局技巧,并提供创建简单登录界面和集成API的翻译小工具完整代码示例,帮助开发者快速上手Python桌面应用开发。
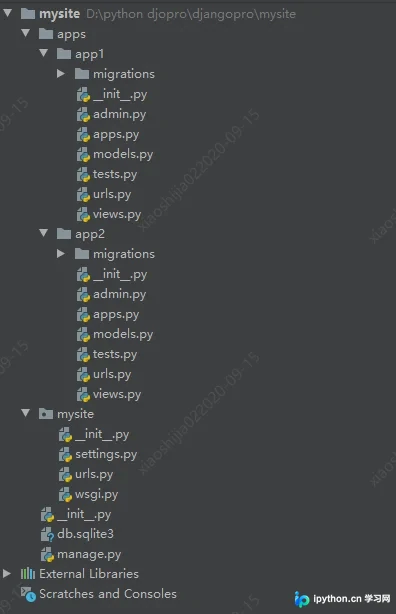
本文详细介绍Django项目中配置多个App的URL路由方法。通过示例展示如何在主urls.py中分发请求至各App,并配置各App的独立urls.py与views。同时涵盖settings.py中的App注册及启动服务命令,最后说明如何在不同App间通过导入models实现跨App数据访问。
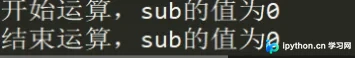
本文详解Python3中多线程同步指令Lock与RLock的使用。通过对比分析加锁与不加锁对共享变量sub的影响,揭示线程调度导致的数值混乱问题。重点讲解acquire与release方法的正确用法,以及RLock在多次请求锁时的递归等级处理,帮助开发者掌握线程解锁与资源保护的核心技巧。
本文系统梳理Python Scrapy框架在爬虫开发中的关键注意事项。涵盖利用Redis实现分布式去重与存储、通过Middleware处理代理IP与Headers、合理配置Settings文件、使用FormRequest提交表单数据,以及结合PhantomJS处理动态渲染页面的技术方案。旨在帮助开发者提升爬取效率与稳定性,解决常见技术痛点。