

Python3多线程编程:深入理解Lock与RLock及解锁机制

本文详解Python3中多线程同步指令Lock与RLock的使用。通过对比分析加锁与不加锁对共享变量sub的影响,揭示线程调度导致的数值混乱问题。重点讲解acquire与release方法的正确用法,以及RLock在多次请求锁时的递归等级处理,帮助开发者掌握线程解锁与资源保护的核心技巧。
多线程锁机制概述
日常生活中,为了保障房间物品的安全,我们会给门加上锁,需要进入时再打开。类似地,在前面的内容中我们介绍过多线程中的Lock(锁),其作用是在多个线程运行时防止出错而进行的锁定指令。然而在实际应用中,线程和指令并非只有一个,如果对所有操作都进行Lock锁定,反而会导致程序出错。因此,本文将全面讲解Lock的使用,并重点介绍其解锁方法。
由于线程之间的调度是随机的,在使用共享变量时,某个线程执行了n条指令后,CPU可能会切换到其他线程执行,这极易导致最终计算结果错误。为了确保多个线程同时操作内存中的同一资源时不产生混乱,我们需要使用锁机制。
Lock指令锁详解
Lock(指令锁)是提供的最低级别的同步指令。当Lock处于锁定状态时,它不属于任何特定的线程。Lock包含两种状态:锁定和非锁定,以及两个基本操作方法。
当一个线程请求锁定时,其他线程将无法获得该锁,直到持有锁的线程释放锁,其他线程才能继续使用。这就像使用独立卫生间,某人进入并锁上门后,其他人必须等待其出来才能使用。
指令锁只能被同一个线程调用一次。如果需要多次请求锁,则需要了解可重入锁(RLock)。
RLock可重入锁与解锁方法
RLock(可重入锁)是一种允许同一个线程多次请求的同步指令。RLock引入了“拥有线程”和“递归等级”的概念。当处于锁定状态时,RLock被某个特定线程拥有。拥有RLock的线程可以再次调用acquire(),但在释放锁时需要调用release()相同的次数。
具体操作方法如下:
acquire([timeout]):请求获得锁定。此操作会使线程进入同步阻塞状态。
release():释放锁。在使用此方法前,线程必须已经获得锁定,否则将抛出异常。
代码实例与结果分析
关于线程锁的案例,这里给出一个简单的指令锁示例,主要展示锁的作用。
import threading
sub = 0
num = 1000000
lock = threading.Lock()
def add():
  global sub,num
  for i in range(1,num):
    # 请求锁
    lock.acquire()
    sub += 1
    # 释放锁
    lock.release()
def red():
    sub -= 1
def main():
  print("开始运算,sub的值为{}".format(sub))
  t1 = threading.Thread(target=add,args=())
  t2 = threading.Thread(target=red,args=())
  t1.start()
  t2.start()
  t1.join()
  t2.join()
  print("结束运算,sub的值为{}".format(sub))
if __name__ == '__main__':
main()
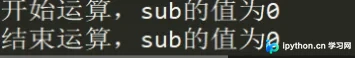
有锁时,加减算法肯定是交替执行的,但最终结果肯定仍为0。
注释掉锁后,再来看下结果。
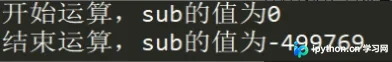
多次执行后,会发现运算结束后的sub值每次都不相同。这正是因为共享变量在线程之间产生了混乱,导致sub的值无法确定。
以上就是Python3爬虫中多线程进行解锁操作实例的详细内容,更多关于Python3爬虫中多线程如何进行解锁操作的资料请关注本站其它相关文章!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









