

Python字典树(Trie)实现与单词统计详解
本文通过Python代码详细演示了字典树(Trie Tree)的构建与使用方法。重点解析了TrieTree类的核心逻辑,包括addNode方法如何存储单词前缀及计数,以及countWord方法如何高效查询特定单词的出现频次。示例展示了从初始化到统计具体单词数量的完整流程,适用于理解字符串前缀匹配算法。
2026-10-13
20

本文通过Python代码详细演示了字典树(Trie Tree)的构建与使用方法。重点解析了TrieTree类的核心逻辑,包括addNode方法如何存储单词前缀及计数,以及countWord方法如何高效查询特定单词的出现频次。示例展示了从初始化到统计具体单词数量的完整流程,适用于理解字符串前缀匹配算法。
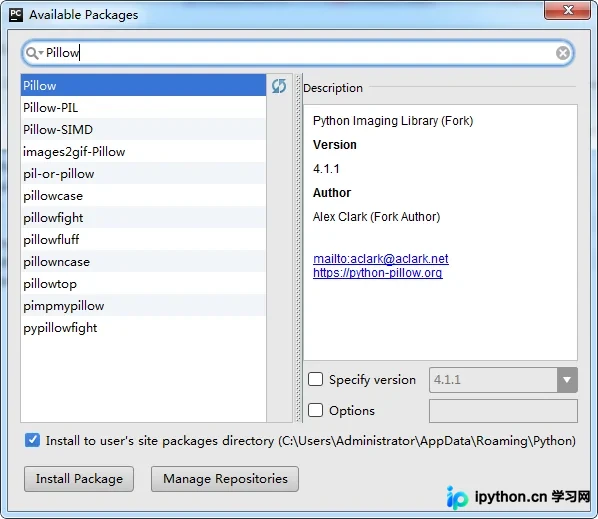
本文介绍如何使用Python的PIL(Pillow)库将图片转换为HTML网页。通过获取图片二进制数据,利用BytesIO处理并压缩图像,遍历像素RGB值生成带有颜色的HTML标签,最终填充模板输出HTML文件。该方法适用于简单的图像文字化展示场景。
本文详细介绍如何使用Python列表构造图的邻接矩阵。通过具体代码示例,演示无向图的边添加方法及矩阵输出结果。文章同时分析了邻接矩阵在顶点多边少时的空间浪费及查询效率缺陷,为理解图存储结构提供参考。
本文详细介绍如何使用py2exe工具将Python脚本打包为独立的Windows可执行文件(EXE)。通过编写setup.py配置文件,指定依赖库、图标及打包选项,并在命令行执行打包命令,即可生成可直接分发的应用程序。
本文深入解析Django的信号机制,阐述其基于观察者模式的工作原理。详细介绍pre_save、post_save等内置信号的使用场景,并通过代码示例演示如何注册回调函数。重点讲解利用receiver装饰器简化注册过程,以及如何在自定义信号中处理sender、instance等参数,实现如订单状态联动更新等复杂业务逻辑。
本文介绍如何在Python中通过自定义urllib2 Handler实现手动插入Cookie。由于标准库HTTPCookieProcessor缺乏直接设置Cookie的方法,通过继承BaseHandler并实现http_request方法,可将指定Cookie强制写入Request Header。该方法兼容现有Cookie处理流程,适用于需要客户端手动控制Cookie值的场景。
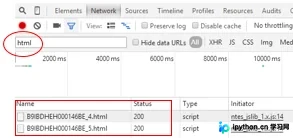
本文介绍使用Python正则表达式抓取网易新闻评论的方法。通过抓包工具定位隐藏评论接口,利用urllib2发起请求并获取HTML数据,再经正则处理提取JSON中的评论字段。代码包含分页处理、异常捕获及文件写入逻辑,适合Python初学者参考正则在爬虫中的应用。
本文详细解析NumPy库中np.nonzero()函数的核心用法。该函数用于返回数组中非零元素的索引位置。文章通过一维、二维及三维数组的具体代码示例,展示了返回值作为包含多个一维数组的元组的结构特征,并说明了如何利用np.transpose()将索引重组为坐标形式,帮助开发者高效处理数组筛选与定位任务。
本文详解Python中import文件夹下文件的正确方式。默认情况下直接导入子目录模块会报错,解决方法是在目标目录下创建空的__init__.py文件,将该目录转换为包。创建后即可正常导入,无需修改代码逻辑。
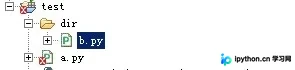
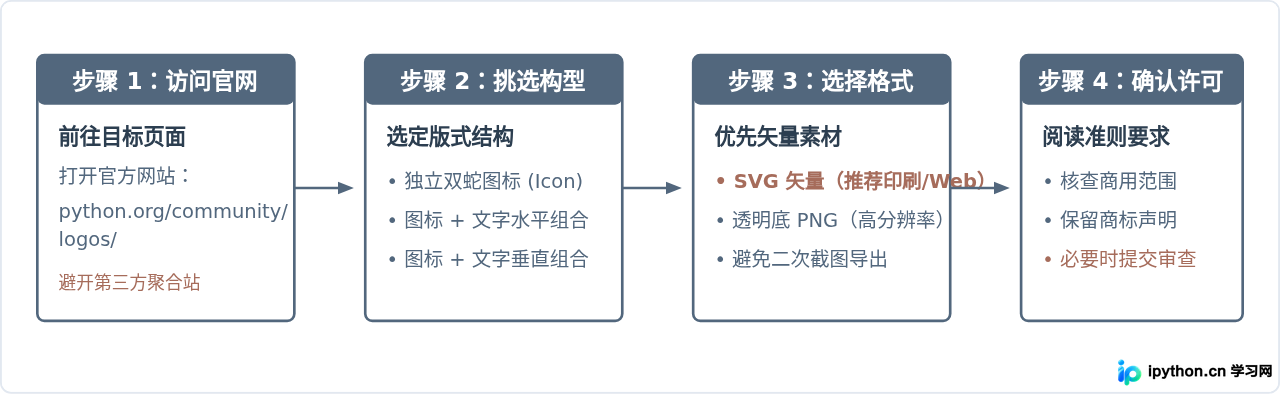
详细介绍Python官方高清矢量Logo的获取途径、核心视觉构成、Python软件基金会(PSF)商标合规政策以及实际项目中的排版与修改限制。
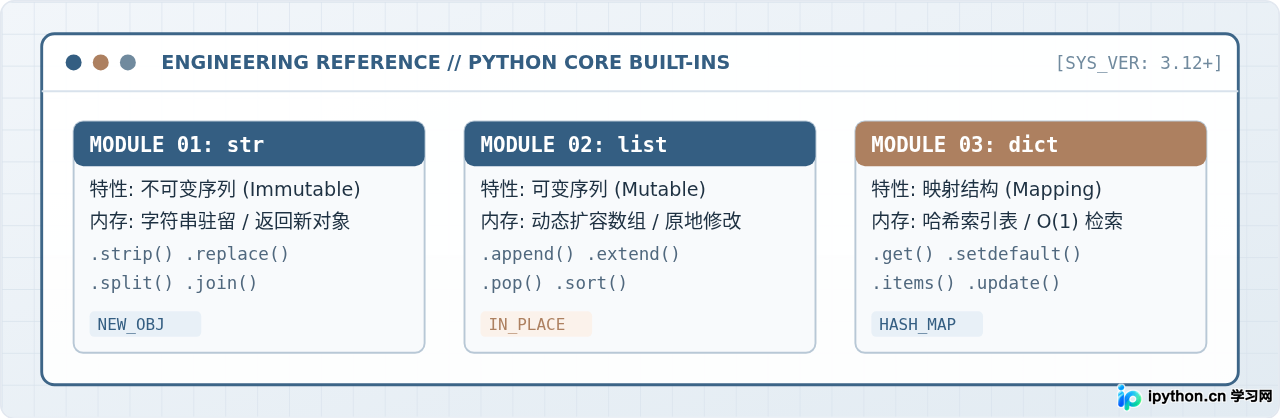
全面梳理Python三大核心内置数据类型str、list、dict的高频内置方法,深度剖析原地修改、返回值差异、底层原理与工程避坑实践。
上下文管理器是Python中管理资源分配与释放的核心机制。本文详解其工作原理,对比类实现与contextlib装饰器两种创建方式,并深入剖析文件读写、数据库事务及多线程锁等实战场景,附带异常处理规范与高级技巧,帮助开发者编写更健壮、易读的代码。