

Python常用数据类型内置方法速查:str、list、dict核心操作

在日常 Python 开发中,字符串(str)、列表(list)与字典(dict)是使用频次最高的三大原生数据结构。熟练掌握它们的核心内置方法,不仅能显著提升编码效率,更在于准确把握“不可变对象的生成机制”与“可变对象的原地修改特性”,避免因误解返回值或浅拷贝引发的隐蔽缺陷。本文将梳理这三大类型的关键方法、执行特征与实战注意事项。
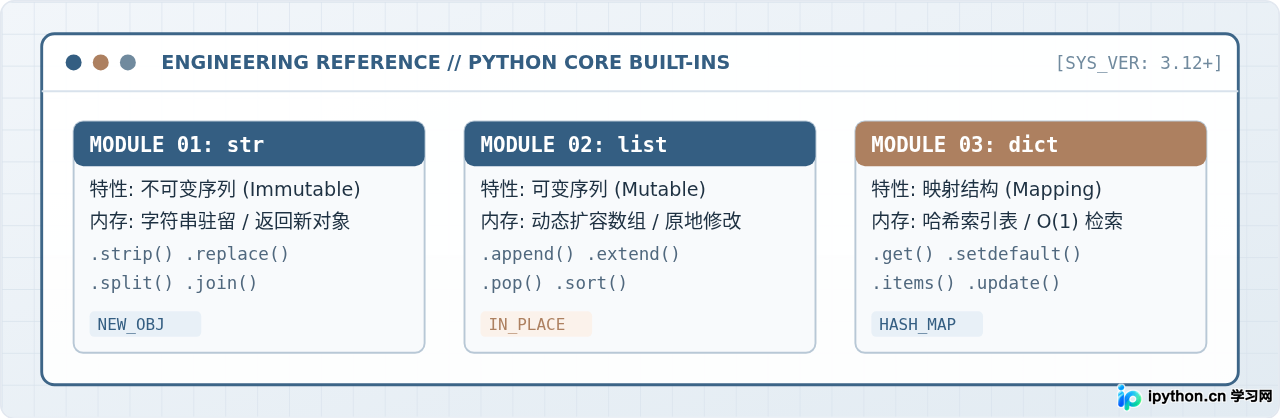
一、三类数据结构架构与行为对比
在深入具体方法前,首要任务是明确三者在内存模型、可变性与键约束上的本质区别。Python 对字符串采用不可变设计,任何看似“修改”字符的操作,本质都是分配新内存并构建新对象;列表使用底层连续指针数组,支持通过索引直接原地更改;字典则基于紧凑哈希表,通过散列算法实现接近常数时间复杂度 \(O(1)\) 的键值检索。
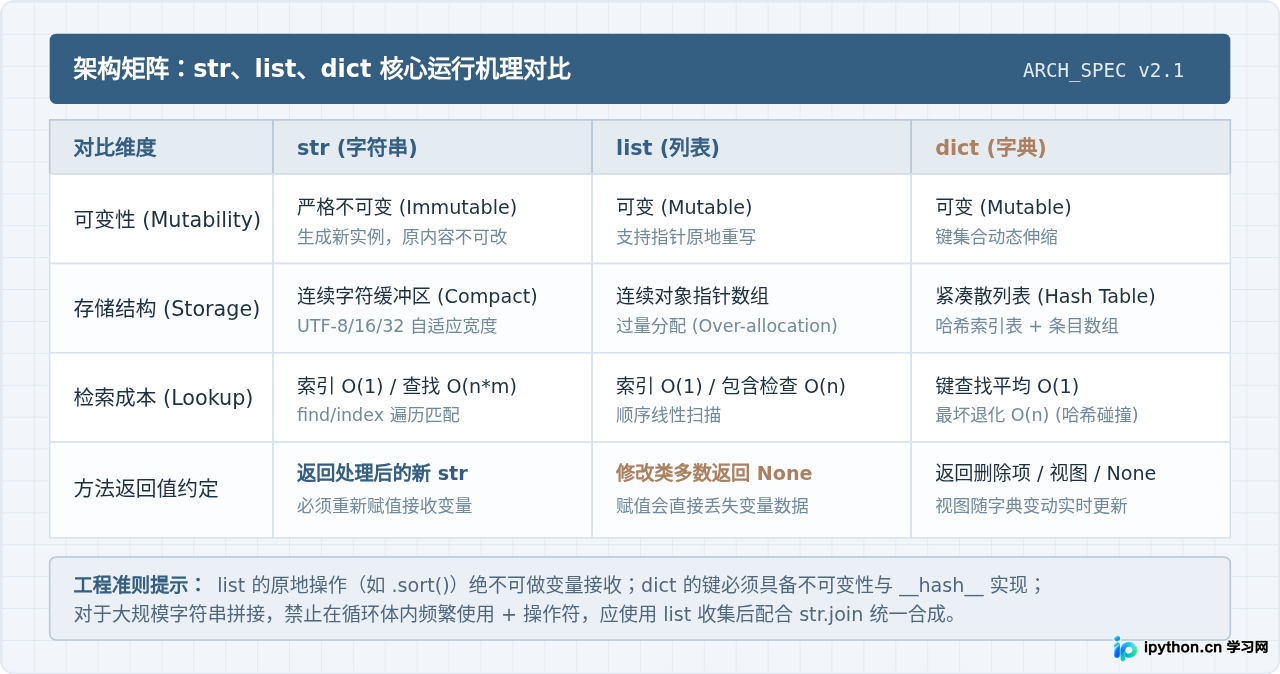
二、字符串(str)核心内置方法精要
由于字符串的不可变属性,所有对其进行的裁剪、替换、切分和格式化操作都会返回一个全新的字符串对象,原字符串在内存中保持原貌。
1. 检索与计数:find()、rfind() 与 index()
在检测子串位置时,find(sub[, start[, end]]) 和 index(sub[, start[, end]]) 的核心差异在于目标不存在时的处理逻辑:
find():当目标子串不存在时,返回-1,适合作为条件判断分支(例如if text.find("key") != -1)。rfind()则从右侧开始检索。index():当目标不存在时,直接抛出ValueError异常。只有在明确确认内容必须存在或外层包裹异常捕获机制时才建议使用。count(sub):返回子串在字符串中非重叠出现的次数。
# 检索示例
s = "python_automation_engine_python"

# find 与 index 对比
pos_find = s.find("auto")      # 输出: 7
pos_missing = s.find("java")   # 输出: -1 (安全无异常)

try:
    pos_idx = s.index("java")  # 抛出 ValueError: substring not found
except ValueError:
    pos_idx = None

count_py = s.count("python")   # 输出: 2
2. 边缘修剪与内容替换:strip() 与 replace()
处理文本输入或读取文件流时,空白字符的剔除与无效符号替换是最常见的第一步:
strip([chars]):移除字符串首尾处在指定字符集中的字符,默认为空白字符(包括空格、\t、\n、\r)。同理,lstrip()仅处理左侧,rstrip()仅处理右侧。replace(old, new[, count]):将字符串内的匹配项替换为新字符。可选参数count限制最大替换次数。
raw_line = " \t [CRITICAL ALERT: Node-01 Failed]\r\n "
clean_line = raw_line.strip()           # 输出: "[CRITICAL ALERT: Node-01 Failed]"
core_msg = clean_line.strip("[]")       # 输出: "CRITICAL ALERT: Node-01 Failed"

normalized = core_msg.replace("Failed", "Recovered", 1)
# 输出: "CRITICAL ALERT: Node-01 Recovered"
3. 切分与聚合:split()、rsplit() 与 join()
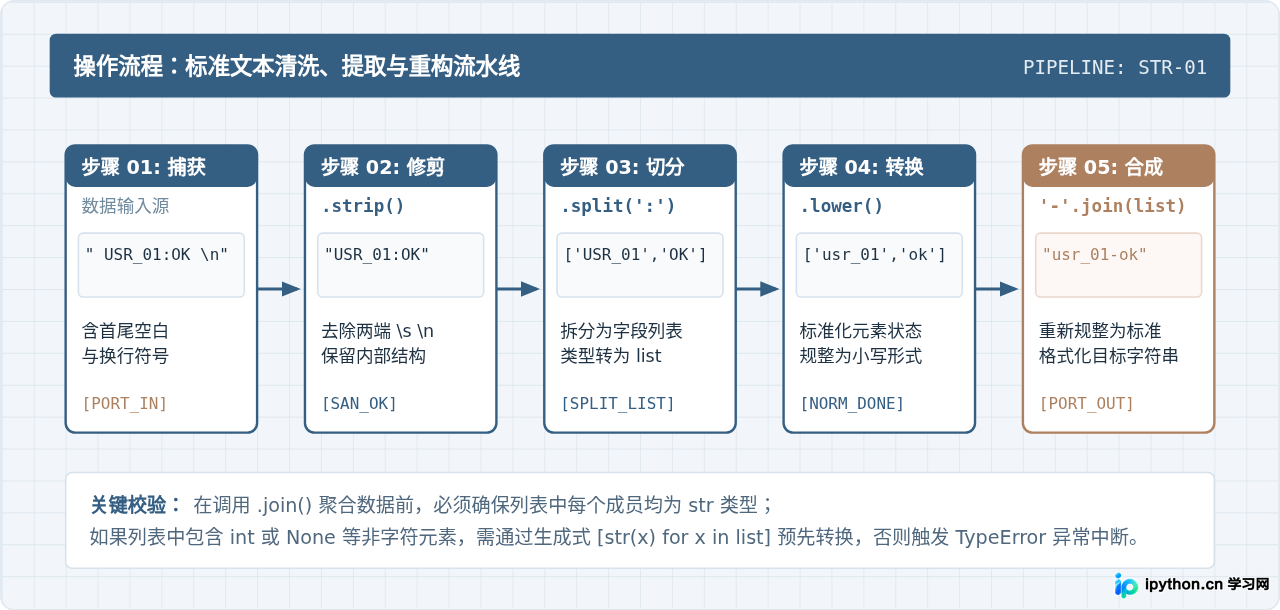
结构化字符串解析与组装的核心在于 split() 与 join() 的配合:
split(sep=None, maxsplit=-1):根据分隔符拆分。当sep=None时,会自动将连续的任意空白字符整体视为单个分隔符,且自动剔除首尾空字符串;若明确指定sep=",",则严格按照该符号切割,空内容将保留为空字符串。join(iterable):以当前字符串作为分隔锚点,将迭代对象中的所有子字符串拼接在一起。注意:被拼接迭代器中的所有元素必须严格为str类型,否则抛出TypeError。
三、列表(list)核心内置方法精要
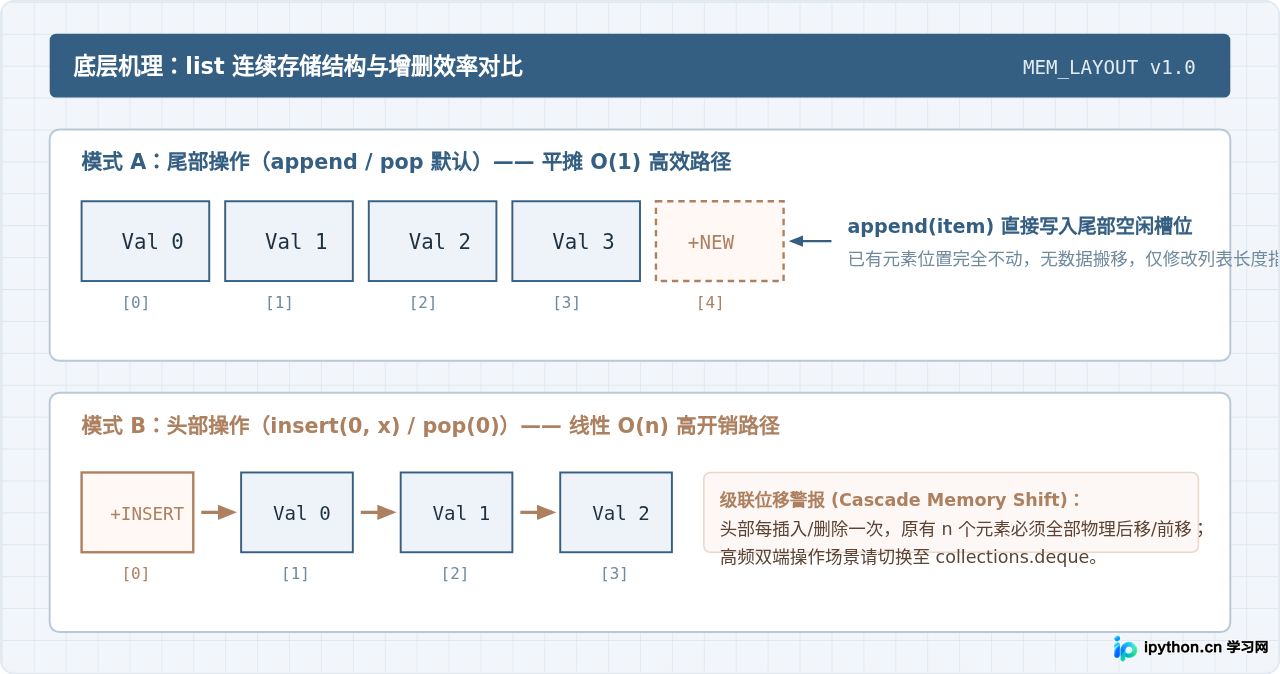
列表是可变序列,其底层是基于连续指针数组实现的。向列表增删元素时,首要关注的是原地修改机制(In-place Operation)与时间复杂度成本。
1. 元素追加与扩充:append()、extend() 与 insert()
append(x):将元素作为整体追加到列表末尾,耗时为平摊常数复杂度 \(O(1)\),返回None。extend(iterable):逐个解包可迭代对象并将其中所有元素依次追加至末尾,等同于lst += iterable。注意:如果错误地对append()传入列表,会形成嵌套列表[1, 2, [3, 4]]。insert(index, x):在指定索引前插入元素。在头部insert(0, x)会迫使后续所有元素向后顺移一位,时间复杂度为 \(O(n)\),数据量大时会成为性能瓶颈。
items = [10, 20]

# 追加单一元素
items.append(30)          # items: [10, 20, 30]

# 批量扩展
items.extend([40, 50])    # items: [10, 20, 30, 40, 50]

# 头部插入 (有元素搬移成本)
items.insert(0, 0)        # items: [0, 10, 20, 30, 40, 50]
2. 元素移除:pop()、remove() 与 clear()
pop([index]):移除并返回指定索引处的元素,默认参数为-1(即末尾)。末尾弹出为 \(O(1)\);若指定pop(0)弹出头部,同样会引起全量元素向前搬移,复杂度为 \(O(n)\)。当列表为空时抛出IndexError。remove(value):从左到右查找并移除第一个与给定值相等的元素,返回None。若该值不存在,抛出ValueError。clear():清空列表内所有元素,等同于del items[:]。
3. 排序与反转:sort() 与 reverse() 的陷阱
初学者最常见的逻辑 Bug 之一便是对 sort() 执行重新赋值:
items.sort() 是直接在当前内存块上对列表进行原地排序,其方法明确返回 None!如果编写 items = items.sort(),会导致 items 变量变为 None,原有列表数据彻底丢失。若需要保留原列表并生成新排序列表,必须使用全局内置函数 sorted(items)。
nums = [5, 2, 9, 1]

# 正确做法 1: 原地排序
nums.sort(reverse=True)   # nums 变为 [9, 5, 2, 1],返回 None

# 正确做法 2: 自定义键排序
records = [("Alice", 85), ("Bob", 92), ("Charlie", 78)]
records.sort(key=lambda x: x[1])  # 按成绩升序排序

# 正确做法 3: 生成新列表
orig = [3, 1, 2]
new_sorted = sorted(orig)         # orig 保持不变,new_sorted 为 [1, 2, 3]
四、字典(dict)核心内置方法精要
字典是基于哈希表实现的键值对集合。Python 3.7+ 已在语言规范层面保证字典按照插入顺序迭代。字典的键必须属于不可变且实现了 __hash__ 的可哈希对象。
1. 安全检索与初始化:get() 与 setdefault()
get(key[, default]):安全检索指定键。若键存在则返回对应值;若不存在则返回default(默认为None),坚决杜绝KeyError异常。setdefault(key[, default]):若键存在,返回现有值;若键不存在,则将key: default插入字典并返回default。该方法是进行就地结构初始化的利器。
config = {"timeout": 30, "retry": 3}

# 安全获取,无 KeyError
port = config.get("port", 8080)   # port 为 8080,config 保持不变

# 归类聚合常见用法:setdefault
groups = {}
groups.setdefault("dev", []).append("server-01")
groups.setdefault("dev", []).append("server-02")
# groups 结果为: {"dev": ["server-01", "server-02"]}
2. 视图对象与合并:items()、keys()、values() 与 update()
调用 d.keys()、d.values() 和 d.items() 返回的是动态字典视图对象(Dict Views)。视图不占用额外的数据副本内存,当原字典发生修改时,已有的视图会即时反映出该变动。
keys():返回键的视图,支持类似集合的交集&、并集|运算。items():返回(key, value)二元组视图,高频用于for k, v in d.items()循环遍历。update([other]):用另一个字典或键值对迭代器批量更新当前字典,已有键直接覆盖,新增键追加写入。pop(key[, default]):移除给定键并返回其对应的值。若未找到键且未指定default,抛出KeyError。
# 字典批量合并
settings = {"env": "prod", "workers": 4}
patch = {"workers": 8, "log_level": "INFO"}

settings.update(patch)
# settings 结果为: {"env": "prod", "workers": 8, "log_level": "INFO"}

# 安全弹出键
val = settings.pop("temp_key", "DEFAULT")  # 返回 "DEFAULT",无异常
五、核心方法速查决策树与避坑指南
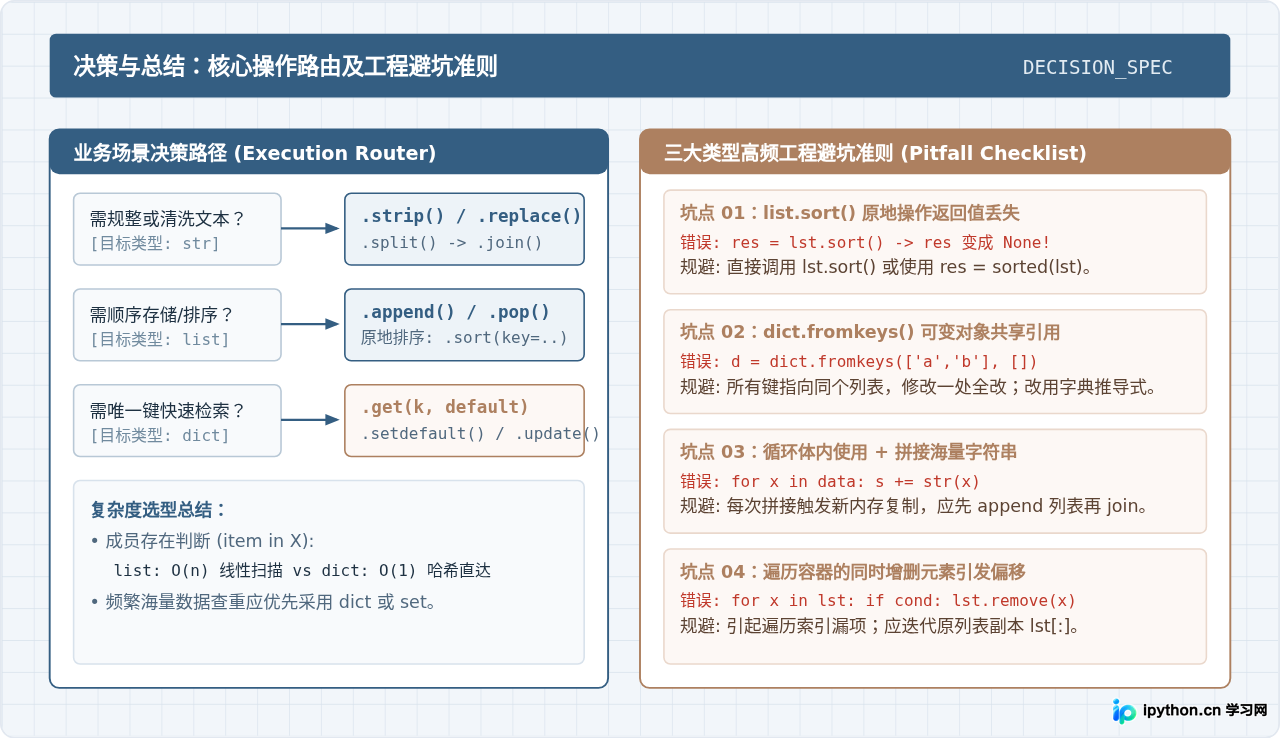
在具体的工程实践中,根据操作意图选择最契合的方法,能够显著简化代码逻辑并规避运行期故障。下图总结了数据处理场景下的决策路径与核心防坑准则。
六、高频速查汇总表
| 数据类型 | 操作类别 | 核心内置方法 | 返回值机制 | 核心应用场景与提醒 |
|---|---|---|---|---|
| str | 检索定位 | find(), rfind(), index() |
位置整数 / -1 |
找不到时 find 返 -1,index 抛 ValueError。 |
| str | 裁剪替换 | strip(), replace() |
新字符串对象 | 不可变类型,必须用变量接收处理后的结果。 |
| str | 切分组装 | split(), join() |
列表 / 字符串 | join 拼接时所有元素必须严格为 str。 |
| list | 添加扩容 | append(), extend(), insert() |
None (原地修改) |
append 尾部 \(O(1)\),insert(0) 头部 \(O(n)\)。 |
| list | 删除弹出 | pop(), remove(), clear() |
被删元素 / None |
pop() 默认弹出尾部;remove 仅删首个匹配项。 |
| list | 顺序重排 | sort(), reverse() |
None (原地修改) |
严禁将 sort() 结果赋值给变量(会赋为 None)。 |
| dict | 键值访问 | get(), setdefault() |
键对应值 / 默认值 | get 规避 KeyError;setdefault 实现原位缺失初始化。 |
| dict | 动态视图 | keys(), values(), items() |
Dict Views 视图对象 | 视图随底层数据联动更新,支持集合运算与解构遍历。 |
| dict | 批量修改 | update(), pop() |
None / 被删键值 |
支持字典解构合并;键必须具备不可变与可哈希特征。 |
综上所述,Python 的 str、list 和 dict 构成了应用逻辑处理的基石。在工程实践中,始终关注数据结构的可变性特征、原地修改机制的无返回值设计、以及时间复杂度的选型边界,能够确保编写出的 Python 程序既简洁优雅,又具备工业级的高性能与稳健性。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









