

Pandas时间数据处理技巧:从转换到重采样的完整指南
面对非标准时间字符串与海量交易记录,Pandas提供了一套从类型转换、频率重采样到向量化计算的完整方案。本文梳理了Timestamp与Period的应用场景、date_range参数组合、升降采样逻辑及滚动窗口用法,并附带股票周线生成案例与时区冲突排错指南,帮助开发者建立基于时间索引的高效数据处理流程。
2026-10-10
20

面对非标准时间字符串与海量交易记录,Pandas提供了一套从类型转换、频率重采样到向量化计算的完整方案。本文梳理了Timestamp与Period的应用场景、date_range参数组合、升降采样逻辑及滚动窗口用法,并附带股票周线生成案例与时区冲突排错指南,帮助开发者建立基于时间索引的高效数据处理流程。
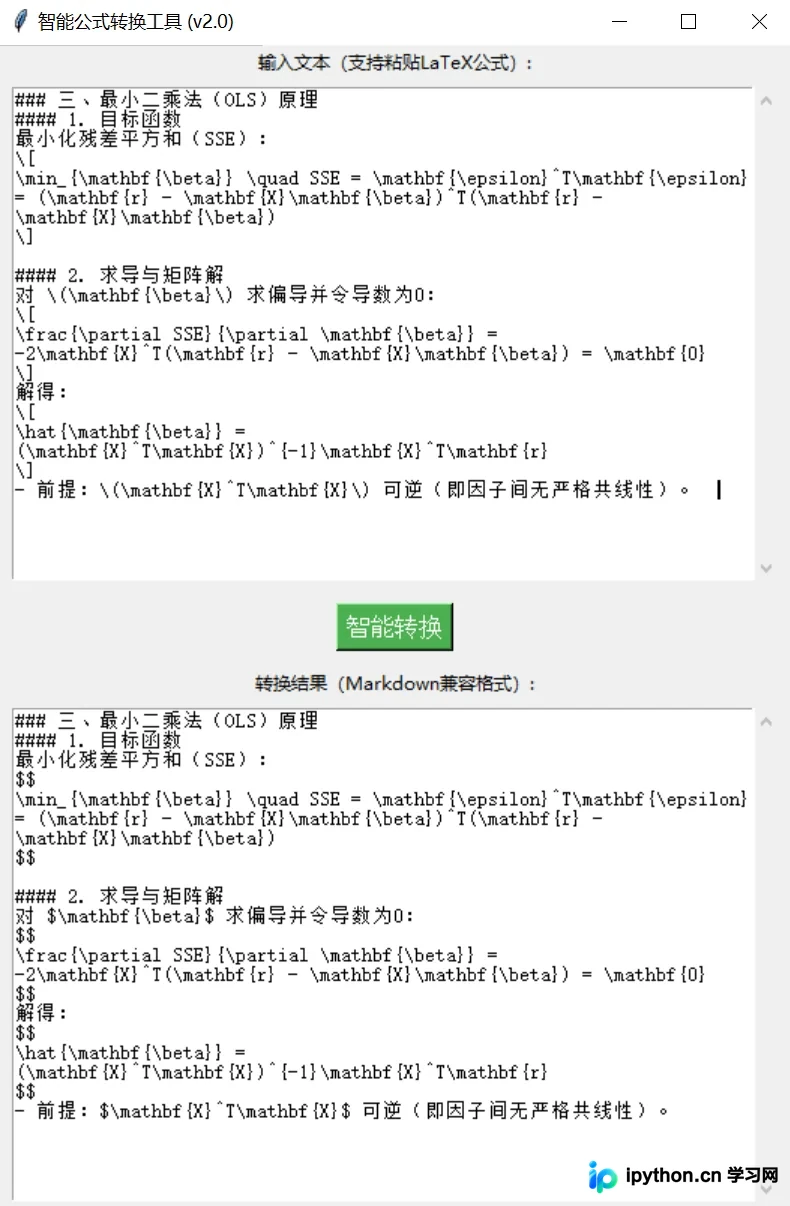
针对技术写作中MathML渲染异常与LaTeX格式错乱问题,本文介绍使用Python与Tkinter构建本地图形化工具的方法。通过集成XSLT解析器与正则表达式,实现MathML自动转LaTeX、行内与块级公式标准化,并在保留原文结构的前提下快速导出Markdown文件,全程支持Windows环境离线运行。
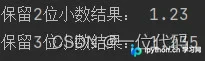
Python中截取浮点数精度通常采用百分号格式符、format格式化或内置round函数三种方式。前两者默认按标准四舍五入返回定长字符串,round函数直接返回数值但遵循银行家舍入规则。结合实际场景选择可精准控制显示位数与运算精度。
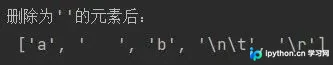
针对 Python 列表中存在空字符、纯空格、换行或制表符等无效元素的情况,本文介绍两种清理方法。通过 remove() 循环遍历可精确匹配特定字符,而推荐使用的列表推导式结合 strip() 函数能一次性过滤所有空白字符,兼顾执行效率与代码简洁性。
针对业务数据表中存在的分类标签重复、维护标准不一及缺失值干扰等问题,本文基于Python与Pandas库构建自动化字段清洗方案。通过字符串规范化、正则过滤、哈希索引去重与分块读取等核心操作,配合异常处理机制与模糊匹配扩展,提供从环境配置、脚本编写到结果验证的完整实践路径,有效替代人工排查,提升数据结构化质量。
Python 中的 len() 是用于获取对象元素数量的内置函数,以 O(1) 时间复杂度直接读取对象的长度属性。它广泛支持字符串、列表、元组、字典及集合等内置序列与映射类型,同时可被 NumPy 数组和 pandas DataFrame 等第三方数据结构继承。本文将详细解析其运行原理、适用边界,并结合输入校验、循环控制与数据切分等实际编码场景提供标准化代码示例,帮助开发者高效调用并避免类型错误。
本文详解Python内置函数locals()的原理与实操。通过函数作用域调用可获取当前局部变量的字典快照,常用于代码调试与日志记录。需注意模块级等价于globals(),且在函数内直接修改该字典不会改变实际变量值。掌握其只读观察原则能有效提升代码可读性与排查效率。
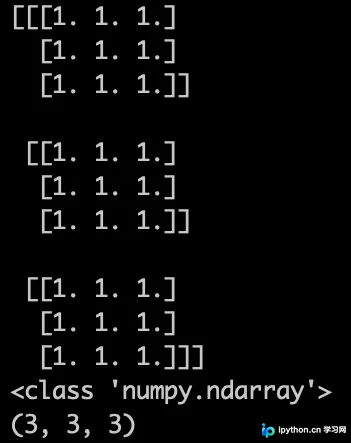
本文详细讲解在Python中如何利用NumPy库快速创建指定形状的三维数组,并通过理解深度、行与列的三维索引逻辑,演示如何将二维矩阵准确赋值至三维数组的不同切片层、行或列中,附带完整代码与运行结果对照。
本文详细演示如何使用 Python 通过 PyWinRM、Paramiko 与 Pypsexec 远程控制 Windows 服务器。涵盖命令执行、文件传输与定时任务配置步骤,提供完整代码示例与环境准备参数,适用于运维自动化与日常远程管理场景。
在Windows 11系统中原生命令行无法直接使用pip升级Python解释器。本文提供两种安全可靠的升级路径:利用系统自带Winget包管理器快速替换版本,以及通过Python官网安装器执行覆盖升级。内容涵盖环境核查、关键参数设置、多版本共存处理与常见报错排查,帮助开发者在无风险前提下完成版本迭代。
本文详解如何利用Python列表与字典生成式,将表单或JSON数据高效转换为结构化字段。通过SELECT结果转字典、INSERT动态拼接字段值、UPDATE灵活生成SET子句等实战案例,展示代码简化的具体写法与注意事项,帮助开发者提升数据处理效率并降低维护成本。
本文详细介绍如何利用Python的paramiko第三方库编写自动化脚本,完整涵盖SSH客户端实例化、账号密码与私钥双模认证、远程指令下发与结果流读取的全过程,并附带主机密钥安全配置规范及生产环境避坑指南。