

解决pandas .to_excel不覆盖已有sheet的问题
在使用pandas保存Excel文件时,直接调用to_excel会覆盖原有文件。本文介绍利用ExcelWriter结合openpyxl引擎,通过load_workbook加载已有工作簿,再写入新Sheet的方法,从而实现在不删除原有Sheet的前提下追加数据。
2026-10-13
20

在使用pandas保存Excel文件时,直接调用to_excel会覆盖原有文件。本文介绍利用ExcelWriter结合openpyxl引擎,通过load_workbook加载已有工作簿,再写入新Sheet的方法,从而实现在不删除原有Sheet的前提下追加数据。
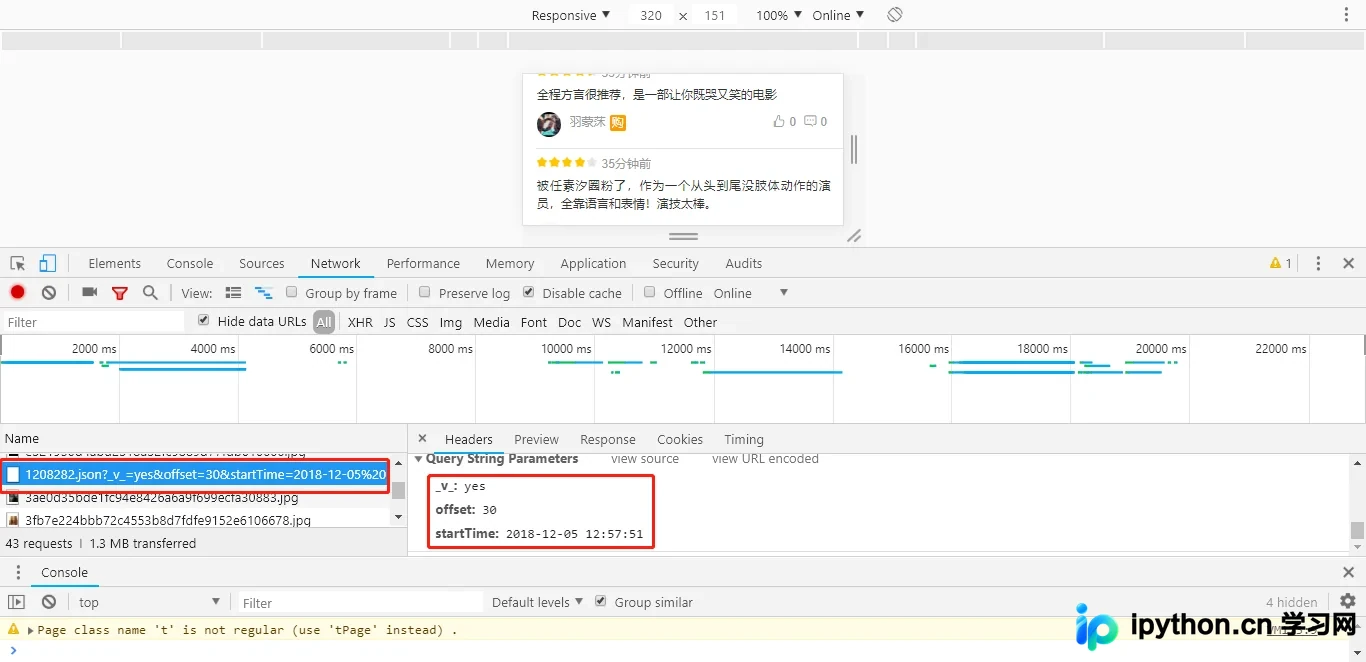
本文详细介绍使用Python采集猫眼电影《无名之辈》近两万条用户评论的全过程。通过移动端接口获取数据,利用jieba进行分词,结合pyecharts和matplotlib制作观众城市分布热点图、TOP20来源柱状图及评论词云。文中还包含对pyecharts源码的修改以解决城市简称匹配问题,提供完整代码供学习参考。
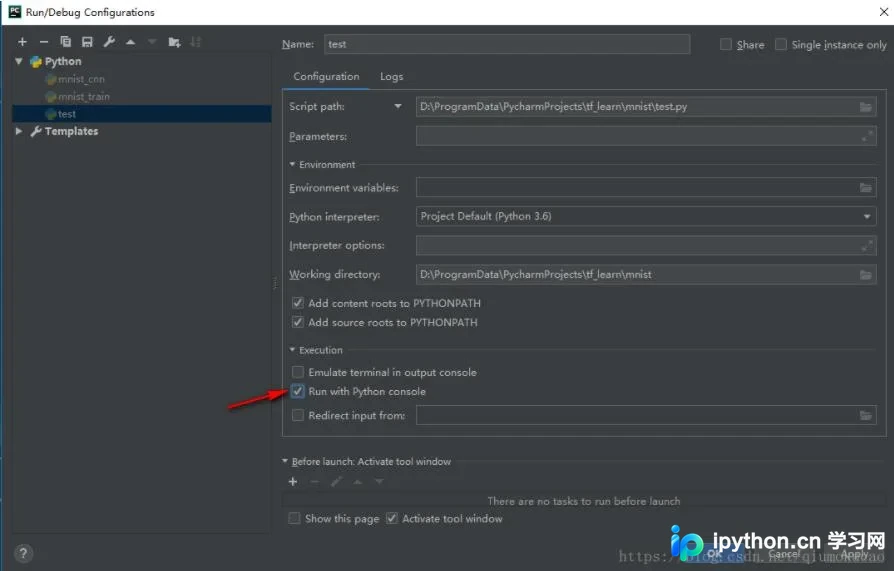
本文介绍了在PyCharm中运行程序时,若发现未打开Run窗口而是直接启动Python Console窗口的解决方法。通过进入Run菜单下的Edit Configurations选项,取消特定复选框即可恢复正常运行行为。
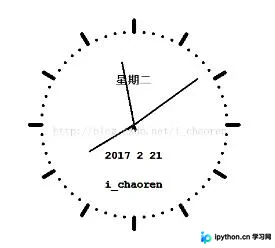
本文介绍如何利用Python的Turtle库绘制一个动态运行的钟表。通过面向对象编程思想,使用五个Turtle对象分别负责绘制表盘、模拟三根表针以及输出文字。程序利用ontimer()函数实现每秒刷新画面,展示完整的代码实现与注释说明。
本文介绍如何利用Python编写脚本爬取淘宝商品销量信息。通过指定关键词和分页参数,程序可自动获取商品列表并计算总销量。支持在代码中通过特定标记约束作者、时期等属性,适用于电商数据分析场景。
本文提供Python语言中生成和读取TXT、JSON以及CSV文件的完整代码示例。涵盖使用内置模块进行文本写入、字典序列化保存、表格数据生成,以及对应的文件读取与异常处理机制,帮助开发者快速掌握常见数据格式的文件IO操作。
本文介绍pandas中Series对象通过加法运算符进行数值相加时的索引对齐机制。当两个Series索引完全一致、顺序不同、存在部分重叠或完全无交集时,相加结果如何生成。重点说明NaN值的产生逻辑及数据类型变化,帮助开发者理解pandas自动对齐特性。
本文介绍在Python中获取包含中文字符串长度的两种常见方法。通过对比Unicode格式与UTF-8字节格式,展示使用len()函数时的不同结果,帮助开发者理解编码对字符串长度计算的影响,并提供简单的代码示例供参考。
本文介绍在Python中使用Pandas库重命名DataFrame轴索引的两种主要方法。通过index.map()可直接修改原数据,而rename()函数支持传入函数或字典进行灵活映射,并可选择是否原地修改。
本文介绍了如何在Python中使用Pandas库创建一个空的DataFrame,并通过循环方式逐步添加数据。主要展示了两种初始化空DataFrame的方法:无参数初始化和指定列名初始化,以及利用append方法将新数据帧合并到现有空数据帧中,实现动态赋值。
本文介绍在Python中消除序列重复值并保持原有顺序的三种方法。首先通过集合直接去重但无法保序;其次利用生成器和集合判断实现保序去重,要求元素可哈希;最后针对字典等不可哈希对象,通过自定义key函数进行去重。
本文详细解析pandas中loc与iloc在数据选取上的核心差异,loc基于标签索引支持按条件筛选,而iloc基于位置索引。通过具体代码示例展示如何选取指定行列及多条件组合取值,帮助开发者高效处理DataFrame数据。