

Python统计纯文本文件中英文单词出现个数的方法总结【测试可用】
本文介绍了Python统计纯文本文件中英文单词出现个数的四种方法。从基础的字符遍历到正则表达式匹配,再到逐行读取优化,最后推荐使用collections.Counter进行高效统计。文章提供了完整的代码示例、运行结果及测试文本,并附带在线工具推荐,适合Python初学者及需要处理文本数据的开发者参考。
2026-10-13
20

本文介绍了Python统计纯文本文件中英文单词出现个数的四种方法。从基础的字符遍历到正则表达式匹配,再到逐行读取优化,最后推荐使用collections.Counter进行高效统计。文章提供了完整的代码示例、运行结果及测试文本,并附带在线工具推荐,适合Python初学者及需要处理文本数据的开发者参考。
本文详细介绍 NumPy 库中丰富的数学函数与代数运算方法。内容涵盖三角函数、双曲函数、数值修约、指数对数及算术运算等基础数学工具,并深入讲解矩阵与向量积、特征值求解、逆矩阵计算等高级代数运算。通过具体代码示例,帮助开发者高效利用 NumPy 进行科学计算与数据分析。
本文深入解析Python自定义装饰器的实现原理,涵盖基础装饰器与带参装饰器的定义及调用机制。通过具体代码实例,阐明闭包、函数内存地址传递及多层封装的执行流程,帮助开发者掌握装饰器的核心用法。
本文介绍如何在Python中实现指定递归深度并忽略特定目录的文件查找功能。通过自定义函数,解决默认递归导致的最大深度报错问题,支持灵活设置查找层级和排除目录列表,适用于不同项目结构下的文件定位需求。
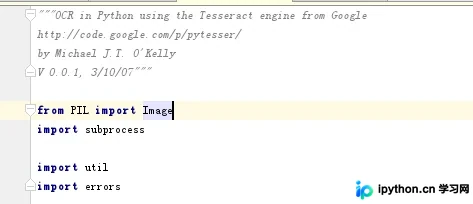
本文详细介绍在Python2环境下利用pytesser和PIL库实现图片文本识别的方法。涵盖从pytesser下载、解压安装到修改__init__.py文件的关键配置,以及PIL库的安装避坑指南。通过具体代码示例,指导用户解决常见报错,完成图片识别测试,并分析该方法的局限性及优化建议。
本文介绍TensorFlow中占位符placeholder的作用及feed_dict的数据馈送机制。通过解析参数定义、数据类型、形状设置及名称规范,结合字符串、数值及矩阵运算实例,展示如何高效构建计算图并避免节点冗余,适用于神经网络训练场景。
本文对比了CSV与NumPy .npy格式在存储效率上的差异,并通过实例演示了如何利用NamedTemporaryFile进行临时文件操作。文章详细讲解了使用np.save保存数组、检查.npy文件大小及形状的方法,并进一步介绍了利用pickle格式序列化存储pandas DataFrame的过程及读取方式,展示了.npy文件相比CSV显著更小的体积优势。
本文详细介绍NumPy中np.save和np.load函数的用法,讲解如何将数组以未压缩的二进制格式保存为.npy文件,以及如何利用np.savez将多个数组合并保存为压缩的.npz文件。通过具体代码示例,演示了单数组和多数组的保存与读取流程,并指出.npz文件返回类似字典的对象结构,便于通过键名获取数据。
本文介绍Python3中实现无重复字符串全排列的两种方法。第一种通过固定首位字符并递归处理剩余部分;第二种利用递归交换字符位置,保持前缀不变并遍历后续组合。文章对比了两种思路的执行效率与代码逻辑,帮助读者深入理解递归在排列组合中的应用。
本文详细解析平衡二叉树的定义与不平衡处理机制,重点阐述左偏与右偏时的旋转策略。通过具体节点示例说明为何选择特定子节点作为新根,并附带完整的Python代码实现及前序遍历结果验证,帮助开发者理解平衡二叉树的构建逻辑。
本文介绍在 Python 中如何在字典内嵌套列表。通过初始化空列表并使用 append 方法添加多个子列表,实现数据结构构建。同时演示如何获取嵌套列表长度、通过索引访问特定子列表及元素,帮助开发者掌握基础的数据组合技巧。
本文详细介绍Python环境中Numpy库的安装步骤,涵盖pip工具配置、环境变量设置及whl离线包安装方法。通过具体命令行示例演示如何成功导入Numpy并生成随机4x4矩阵,验证环境配置有效性,适合初学者快速上手科学计算库。