Python 内置方法 __del__ 与 __str__ 详解
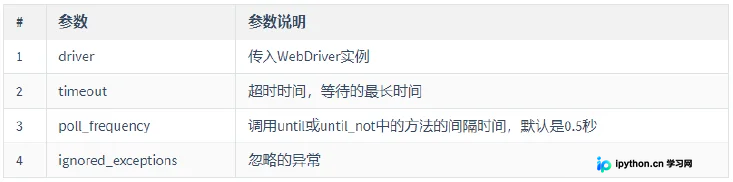
本文详细解析Python中__del__与__str__两个内置方法。__del__在对象销毁前自动调用,用于管理资源释放;__str__控制print输出格式,需返回字符串。通过Cat类示例,展示对象生命周期管理及自定义打印内容的实现方式。
2026-10-15
10

本文详细解析Python中__del__与__str__两个内置方法。__del__在对象销毁前自动调用,用于管理资源释放;__str__控制print输出格式,需返回字符串。通过Cat类示例,展示对象生命周期管理及自定义打印内容的实现方式。
本文介绍使用Python第三方库imap-tools简化邮件附件下载的方法。通过封装imaplib,该模块能显著减少代码量。文中提供了基于Python 3.8环境的完整示例,展示如何登录IMAP服务器、遍历邮件并保存附件文件,同时附带原生imaplib与BeautifulSoup解析邮件内容的对比代码。
本文深入解析Python中的高阶函数概念,详细阐述map、filter和reduce三个内置高阶函数的定义、用法及内部实现机制。通过代码示例展示如何将函数作为参数或返回值,并对比模拟函数与原生函数的执行结果,帮助开发者掌握这些核心工具的实际应用。
本文详细介绍如何利用Pandas对DataFrame和Series数据进行可视化。涵盖折线图、条形图(含水平与堆积)、散点图、饼图、蜂巢图及箱线图的绘制方法与参数配置,并演示subplots函数实现多子图布局,帮助开发者在数据处理中快速生成直观图表。
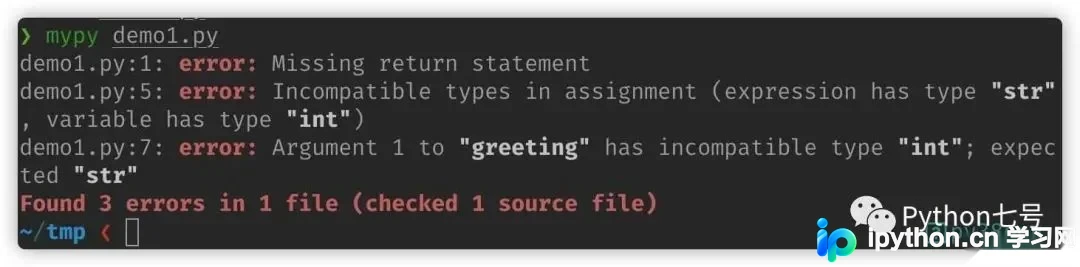
mypy 是 Python 的静态类型检查器,能验证带有类型提示的代码,提前发现潜在错误。本文介绍 mypy 的安装方法、执行检查流程、忽略特定行的技巧,以及配置文件(如 mypy.ini)的查找顺序和常用配置项,帮助开发者提升代码可读性与可维护性。
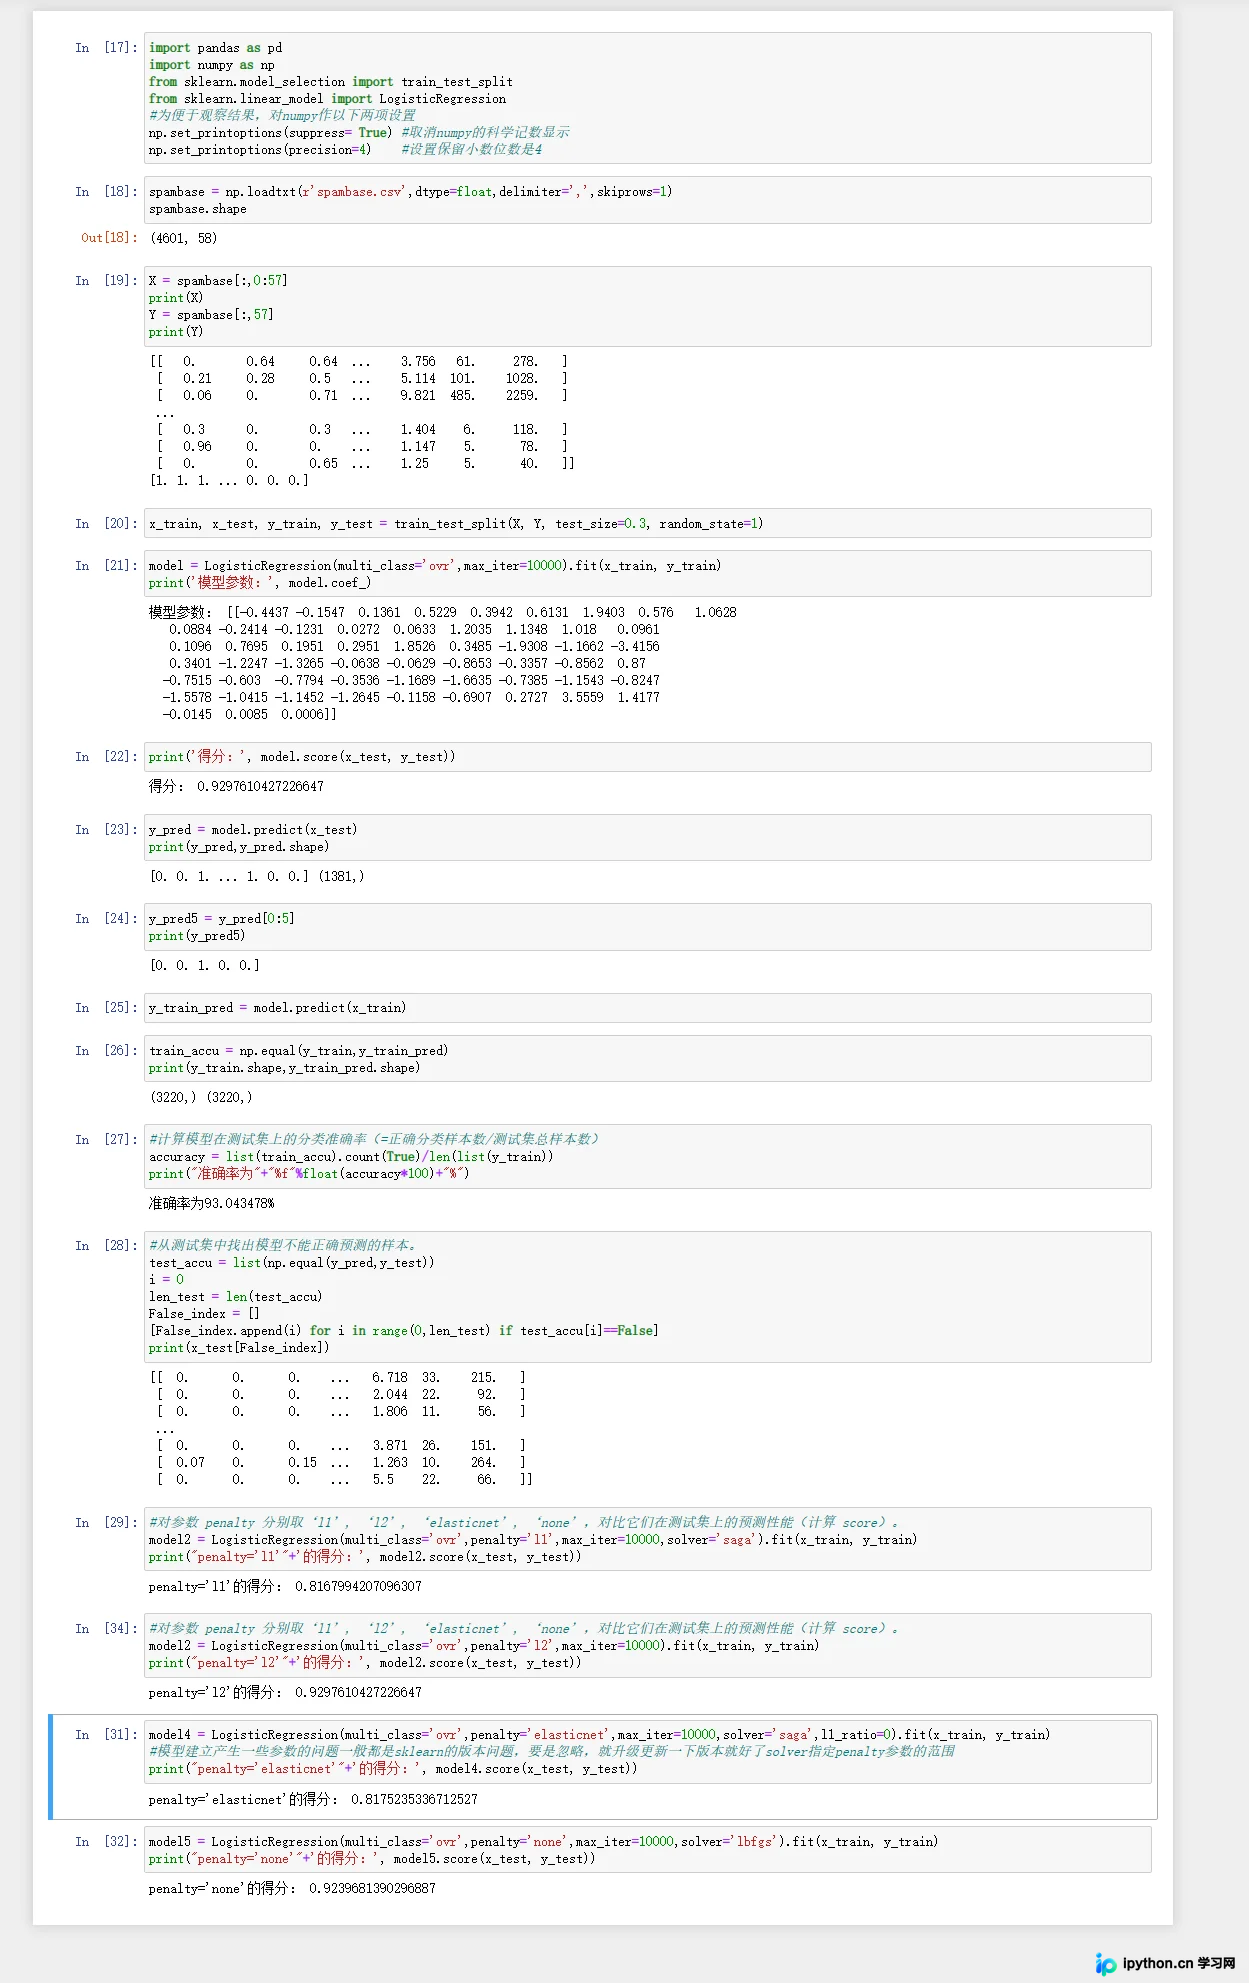
本文详细介绍如何使用Python和逻辑回归算法对垃圾邮件数据集进行分类。内容涵盖数据预处理、训练集与测试集划分、模型构建及参数调优。通过对比l1、l2、elasticnet和none等不同惩罚项对模型性能的影响,并计算分类准确率及错误样本,帮助读者掌握逻辑回归在文本分类中的实际应用。
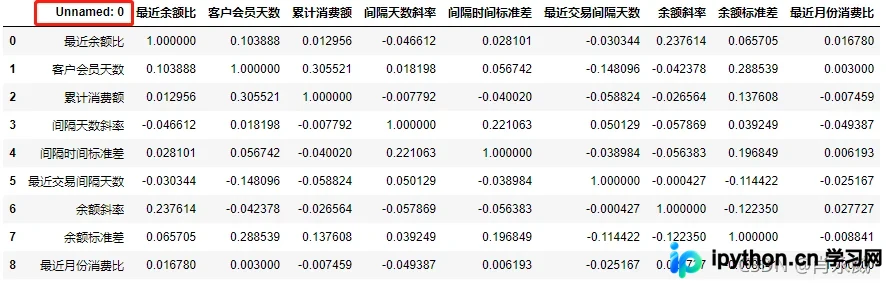
本文介绍在使用Pandas读取Excel文件时,因计算相关系数导致出现Unnamed列的问题。通过两种方法解决:一是筛选保留正常列名,二是直接使用drop删除指定列。适用于处理包含未命名索引列的数据清洗场景。
本文详细介绍两个实用的Python装饰器:用于处理外部API调用或爬虫中超时问题的timeout装饰器,以及用于调试和演示代码执行顺序的trace装饰器。通过具体代码示例,展示如何自定义异常处理与sys.settrace机制,提升Python开发的健壮性与可维护性。
本文详细解析Python中处理数据缺失值的8种核心方法,涵盖使用dropna删除含缺失值的行列、基于阈值过滤,以及利用fillna进行常数、聚合值、前后值填充及多数据源替换。通过具体参数如how、thresh、limit和subset的讲解,帮助开发者根据数据特征选择最优策略,确保数据分析的准确性与完整性。
本文详细介绍Python列表的基本操作,涵盖添加元素(append、extend、insert)、删除元素(del、pop、remove、clear)、修改元素及查找元素(index、count)等方法。通过具体语法格式与代码示例,解析各方法的参数含义、使用场景及常见错误处理,帮助开发者掌握列表的高效操作技巧。
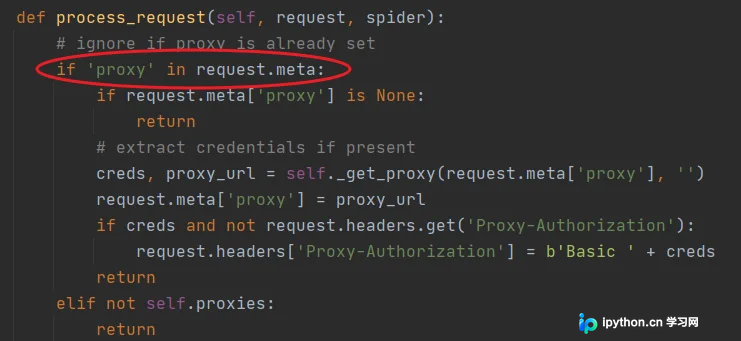
本文详细介绍Scrapy框架中代理中间件的使用与自定义方法。涵盖HttpProxyMiddleware的默认配置、通过Request meta参数设置代理、抓取快代理IP并验证可用性,以及继承HttpProxyMiddleware和直接编写中间件类两种自定义实现方案,帮助开发者解决IP被封或访问受限问题。
本文详解Selenium自动化测试中的三种核心等待方式:固定时间sleep、隐式等待implicitly_wait及显式等待WebDriverWait。通过对比分析各方法的优缺点、适用场景及代码示例,帮助开发者解决元素定位失败问题,提升脚本稳定性与执行效率。