Python 获取 Chrome 浏览器保存密码的方法(80+版本)
本文介绍如何使用 Python 读取 Google Chrome 浏览器保存的登录密码。针对 Chrome 80 及以上版本采用的新加密机制,脚本通过读取 Local State 文件获取加密密钥,结合 AESGCM 算法解密存储在 Login Data 数据库中的密码数据。文章提供了完整的 Python 代码示例及必要的依赖库安装说明。
2026-10-14
22

本文介绍如何使用 Python 读取 Google Chrome 浏览器保存的登录密码。针对 Chrome 80 及以上版本采用的新加密机制,脚本通过读取 Local State 文件获取加密密钥,结合 AESGCM 算法解密存储在 Login Data 数据库中的密码数据。文章提供了完整的 Python 代码示例及必要的依赖库安装说明。
本文详细介绍Python中Pandas库的pivot()函数,用于数据重塑。解析index、columns、values三大参数,提供完整代码示例及注意事项,如使用reset_index()处理结果,帮助开发者高效进行数据分析与表格转换。
本文详解如何利用Python实现Appium相关端口的检测与释放。通过Socket模块判断端口占用状态,并结合CMD命令(netstat、taskkill)或os.popen接口强制释放被占用端口,解决自动化测试中常见的端口冲突问题。
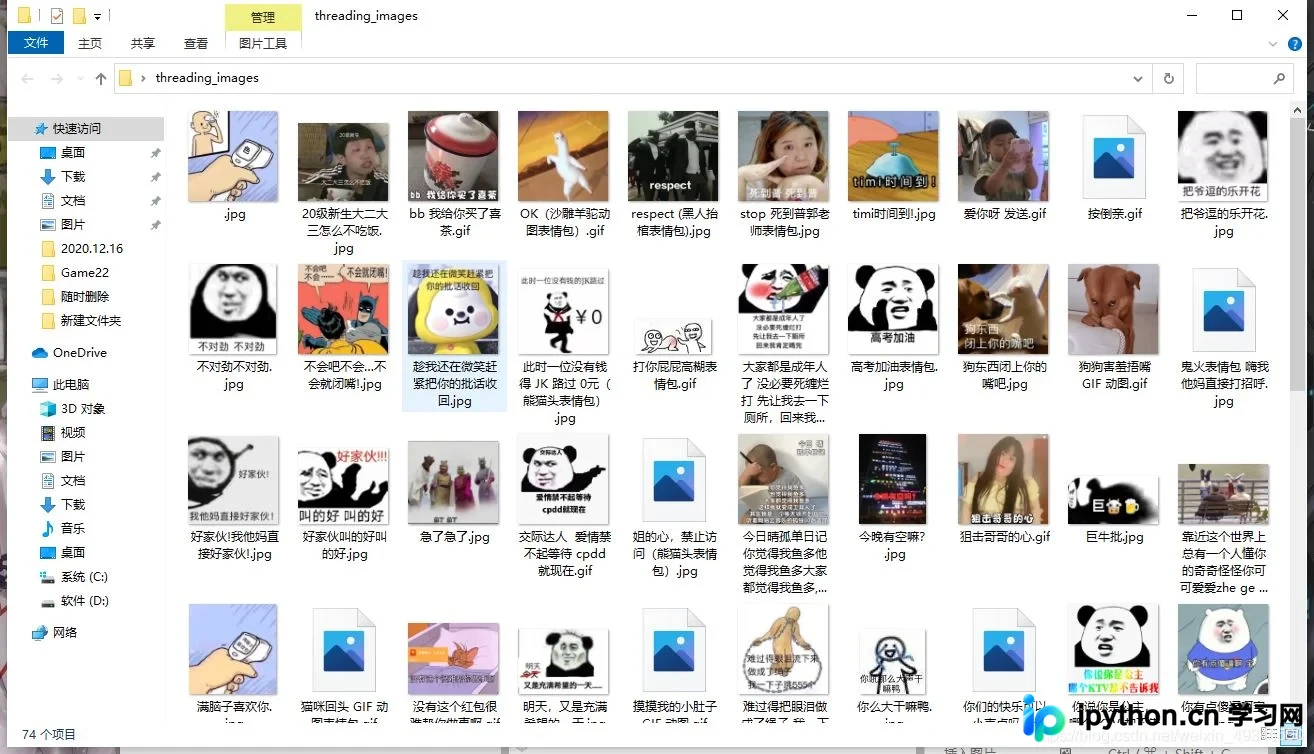
本文详细介绍如何使用Python结合requests、bs4及多线程技术,实现海量表情包的自动抓取与本地保存。内容涵盖环境配置、核心类设计、URL解析逻辑及完整的爬虫代码示例,帮助开发者快速掌握并发爬取技巧。
本文介绍使用Python编写自动整理文件脚本的方法,支持按后缀名对图片、视频、文档等进行分类归档。针对无Python环境的用户,详细讲解了如何利用PyInstaller将脚本打包为独立的EXE可执行文件,实现跨平台分享与使用,并包含完整的代码示例与操作命令。
本文介绍如何利用 pandas 的 read_csv 函数中的 chunksize 参数,实现对大型 CSV 文件的逐块读取与处理。通过示例代码演示了 TextParser 对象的迭代使用、Series 对象的 value_counts 统计以及 add 方法的累加合并技巧,有效解决内存溢出问题,适用于海量数据清洗与分析场景。
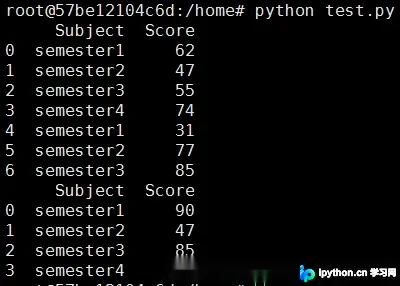
本文介绍在Python Pandas库中如何计算两个Dataframe的交集与差集。通过pd.merge方法结合inner连接获取交集,支持指定列进行匹配。对于差集,演示了利用concat和drop_duplicates去除重复项的方法,分别计算df1-df2及df2-df1的结果,并提供另一种基于append和drop_duplicates的实现思路,帮助开发者高效处理数据差异。
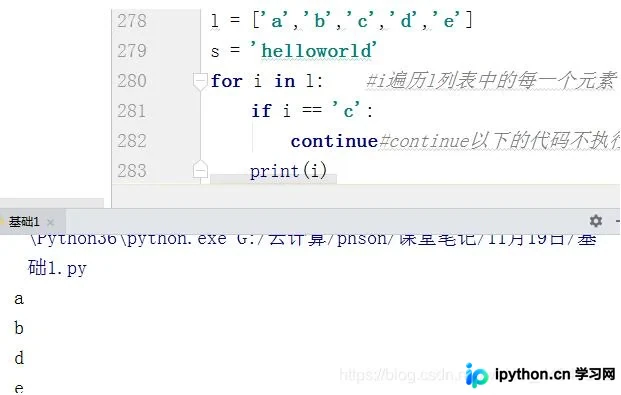
本文探讨在Python的for循环中直接调用pop方法删除元素时,为何会意外跳过某些元素。核心原因在于for循环基于迭代器机制,删除元素后索引偏移导致迭代器指向下一个元素,从而跳过原相邻项。文章提供了使用切片副本nums[:]遍历的解决方案,并简要回顾了continue、break和pass在循环中的基本用法。
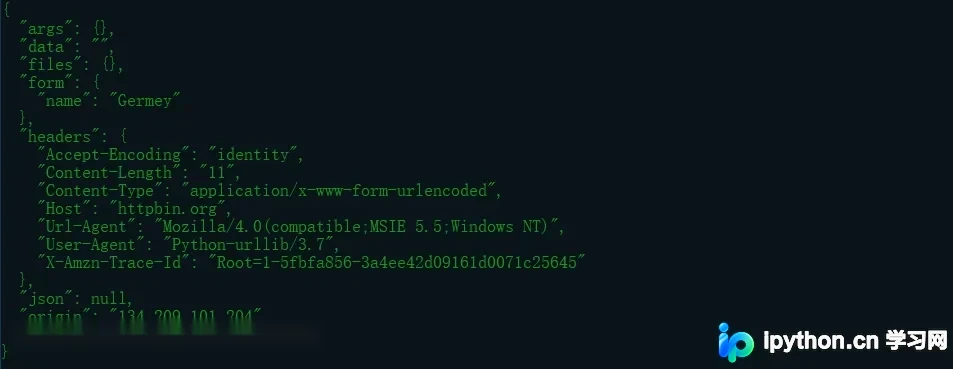
本文深入解析Python标准库urllib.request模块。详细讲解Request类的构造参数与数据编码,阐述Handler与Opener的协作机制。通过身份验证、代理配置及Cookie持久化(Mozilla与LWP格式)的完整代码示例,展示如何灵活构建HTTP请求处理器,适用于Python网络编程与爬虫开发场景。
本文详细介绍在Python中将普通元组转换为namedtuple的两种主要方法。通过解包字典(**dict)或利用类型赋值技巧,可以实现元组到具名元组的转换。文章包含具体代码示例及注意事项,帮助开发者理解namedtuple的兼容性与使用场景。
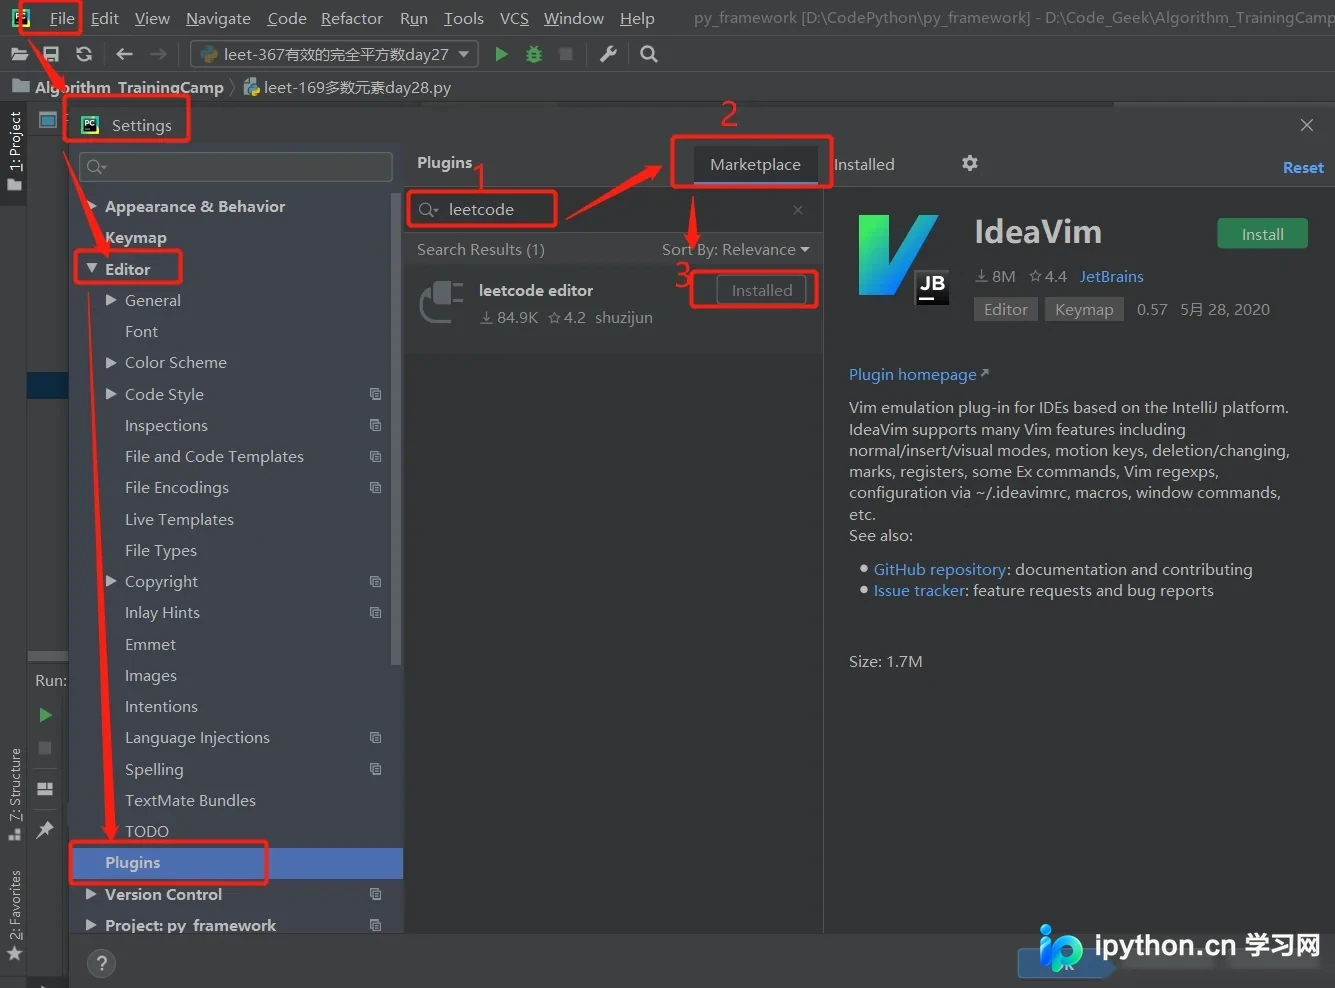
本文详细介绍在PyCharm中安装和使用LeetCode插件的完整流程。内容涵盖插件安装、IDE重启、账号登录配置、题库浏览、本地编码调试以及代码提交测试等关键步骤,帮助开发者在熟悉的IDE环境中高效进行算法练习与在线评测。
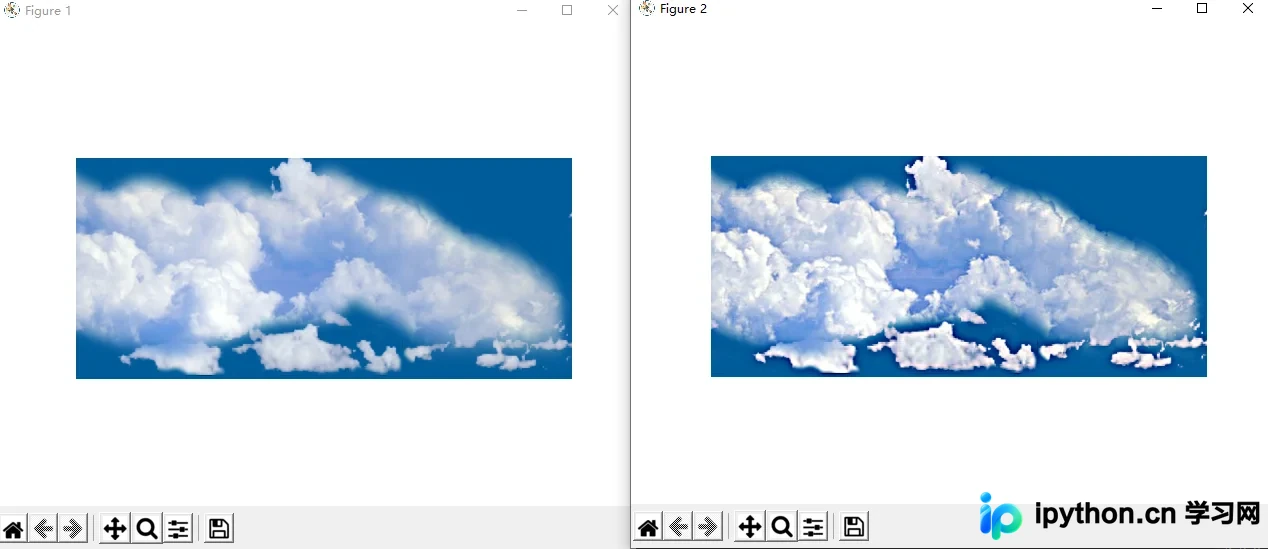
本文介绍如何使用Python实现Photoshop中的USM(Unsharp Mask)锐化效果。通过结合高斯模糊与原始图像,利用公式计算锐化结果,并对数值进行饱和处理,最终展示处理前后的对比图像。