

Python for循环中pop元素导致跳过问题的原理与解决

本文探讨在Python的for循环中直接调用pop方法删除元素时,为何会意外跳过某些元素。核心原因在于for循环基于迭代器机制,删除元素后索引偏移导致迭代器指向下一个元素,从而跳过原相邻项。文章提供了使用切片副本nums[:]遍历的解决方案,并简要回顾了continue、break和pass在循环中的基本用法。
Python for循环中pop元素导致跳过问题的原理与解决
在学习Python的过程中,可能会遇到这样一个场景:需要遍历一个数组,当发现数组中存在与指定数值相同的元素时,将其删除。
这里有一个关键约束:不能开辟额外的内存空间,所有的处理操作必须直接在原数组上进行。
nums = [0,1,2,2,3,0,4,2]
val = 2
for i in nums:
 if(i == val):
  idx = nums.index(i)
  nums.pop(idx)
print(nums)
最初尝试的代码实现如下,运行后的输出结果却出现了意料之外的问题。
[0, 1, 2, 3, 0, 4] //中间的2居然没有删除
为了解决这个问题,我对代码进行了调整,在每次循环过程中打印当前的状态,以便观察具体执行情况。
0loop [0, 1, 2, 2, 3, 0, 4, 2]
1loop [0, 1, 2, 2, 3, 0, 4, 2]
2loop [0, 1, 2, 3, 0, 4, 2]//这里被跳过了
3loop [0, 1, 2, 3, 0, 4, 2]
4loop [0, 1, 2, 3, 0, 4, 2]
5loop [0, 1, 2, 3, 0, 4, 2]
6loop [0, 1, 2, 3, 0, 4]
问题根源分析
问题的根源在于Python的for循环是通过迭代器实现的。当使用pop方法删除当前元素后,后续元素会向前填补被删除位置的空缺,而循环迭代器会自动指向下一个索引位置。这种机制导致原本位于被删除元素之后的那个元素(例如数值2)被迭代器跳过,从而未能被检查和删除。
解决方案
查阅相关资料后,发现一种适合该场景的处理方式,即通过创建列表的浅拷贝来进行遍历。
for i in nums[:]: //在这里nums[:]相当于复制了一份,但是并不是同一份。
  if(i == val):
    idx = nums.index(i)
    nums.pop(idx)
采用该方法后的输出结果如下:
[0, 1, 3, 0, 4]
补充知识:循环控制语句
补充知识:Python中for循环里continue、break和pass关键字的用法。
1、continue:用于跳过当前循环剩余的代码,直接开始执行下一次循环。
l = ['a','b','c','d','e']
for i in l:    #i遍历l列表中的每一个元素
  if i == 'c':
    continue   #continue以下的代码不执行直接进入下一个循环
  print(i)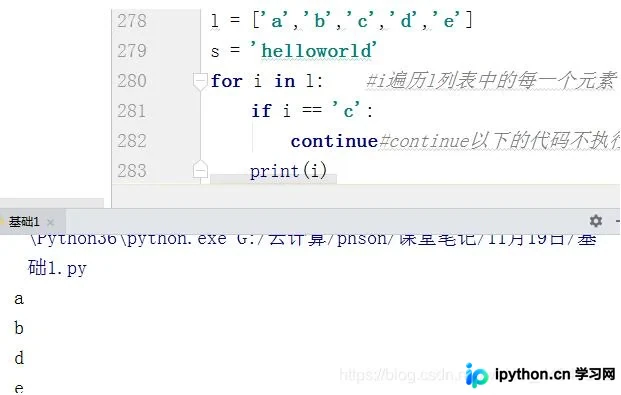
2、break:用于立即中断整个循环,不再执行后续任何代码。
l = ['a','b','c','d','e']
for i in l:
  if i == 'c':
    break #break直接跳出循环,break以下代码全部不执行
  print(i)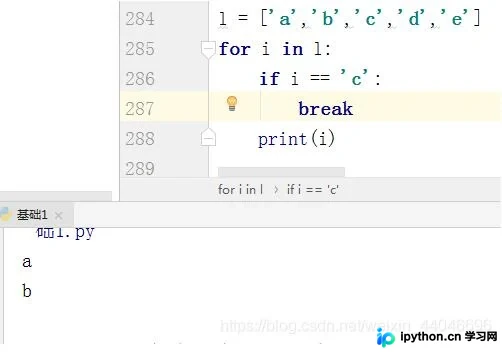
3、pass:作为占位符,表示什么都不操作,继续执行循环的下一步。
l = ['a','b','c','d','e']
for i in l:  #i遍历l列表中的每一个元素
  if i == 'c':
    pass
  print(i)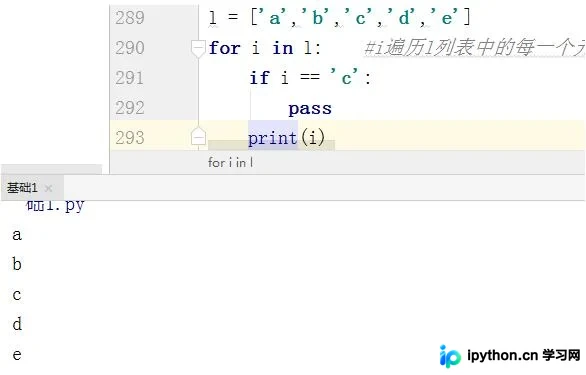
以上为个人经验分享,希望能为大家提供参考。也希望大家多多支持本站。如有错误或未考虑完全的地方,欢迎留言讨论,望不吝赐教。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









