Python实现决策树算法:基于MNIST数据集的ID3模型训练与评估
本文详细解析使用Python实现决策树算法的全过程,重点介绍基于ID3算法在MNIST手写数字数据集上的应用。内容涵盖数据加载、二值化处理、树构建逻辑及准确率评估,展示了未剪枝ID3模型在60000条训练数据下的85.9%正确率及356秒运行耗时,为理解决策树原理与代码实现提供完整参考。
2026-10-14
23

本文详细解析使用Python实现决策树算法的全过程,重点介绍基于ID3算法在MNIST手写数字数据集上的应用。内容涵盖数据加载、二值化处理、树构建逻辑及准确率评估,展示了未剪枝ID3模型在60000条训练数据下的85.9%正确率及356秒运行耗时,为理解决策树原理与代码实现提供完整参考。
本文详细解析Python中利用urllib库抓取网页时添加请求头(Headers)的两种常用方法。第一种通过build_opener结合addheaders实现,需注意headers需为元组类型;第二种通过创建Request实例对象,支持字典类型传入及add_header方法追加。文章对比了两种方式的参数格式差异与适用场景,帮助开发者避免类型错误并成功获取网页内容。
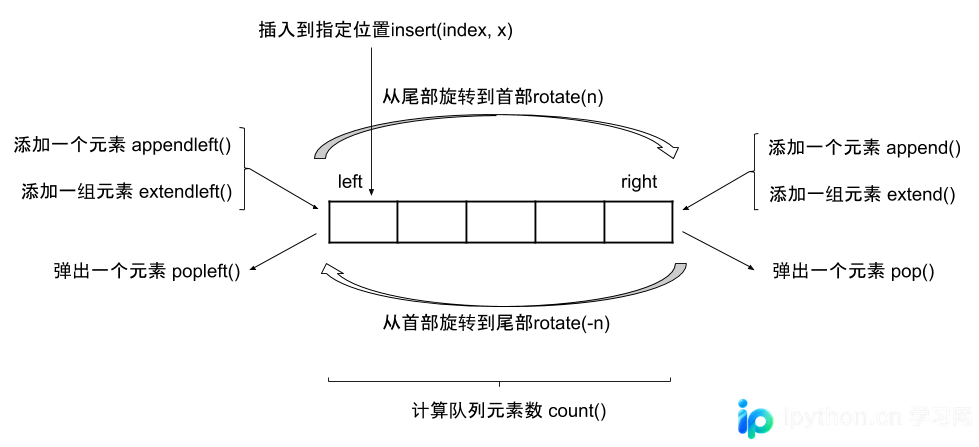
本文深入解析 Python 中四种队列实现机制。重点对比 collections.deque 与 list 在时间复杂度上的差异,阐述其线程安全特性。同时分析 queue.Queue、asyncio.Queue 及 multiprocessing.Queue 在多线程、协程及多进程场景下的适用性、阻塞机制与底层实现差异,帮助开发者根据场景选择最优队列方案。
本文介绍Python中xmltodict模块的安装方法及核心用法。该模块可轻松实现XML与Python字典的双向转换,特别适用于微信公众号、微信支付等场景下的数据解析。文章提供了dict转xml和xml转dict的完整代码示例,并解决了根节点唯一性的常见报错问题。
本文深入解析Python中的字符串Intern(驻留)机制,解释其通过共享不可变对象提升性能的原理。重点探讨自动Intern的限制条件,如仅包含字母、数字和下划线的短字符串(通常小于20字符)会被自动驻留。同时对比Shell交互式环境与PyCharm等IDE在字符串处理上的差异,并分析编译期与运行期字符串拼接对Intern效果的不同影响。
本文详解如何在Python中调用百度识图API。首先指导用户前往百度智能云注册并获取AK和SK密钥,随后提供完整的Python代码模板,涵盖Token获取、图片Base64编码及API请求流程,帮助开发者快速实现图像识别功能。
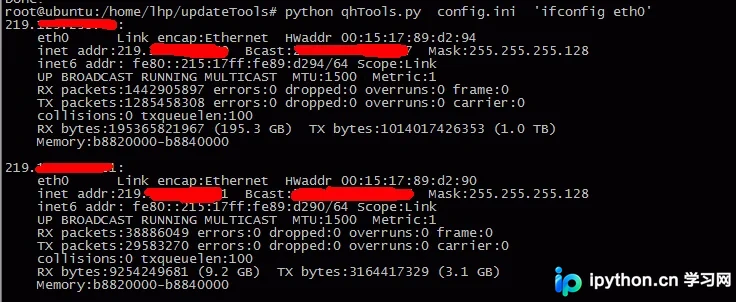
本文详细介绍如何利用Python的Paramiko库实现远程服务器的SSH连接与命令执行。内容涵盖基于用户名密码及公钥认证的两种连接方式,演示SFTPClient进行文件上传下载的代码示例,并提供一个支持多线程批量执行Shell命令的完整脚本,帮助开发者高效管理远程主机。
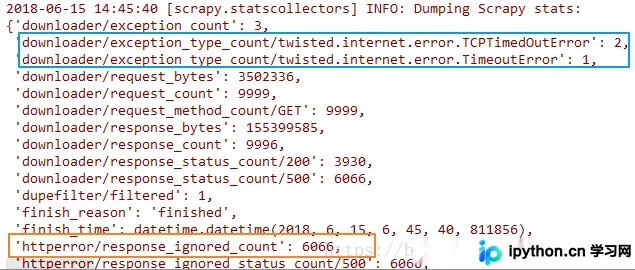
本文详解Scrapy中处理下载错误的两种主要场景:HTTP状态码异常(如403/500)与代码执行异常。通过深入分析RetryMiddleware源码,揭示process_response与process_exception的工作机制,并提供一个自定义中间件模板,用于兜底捕获未重试成功的请求,确保爬虫在长时间运行时的稳定性与数据完整性。
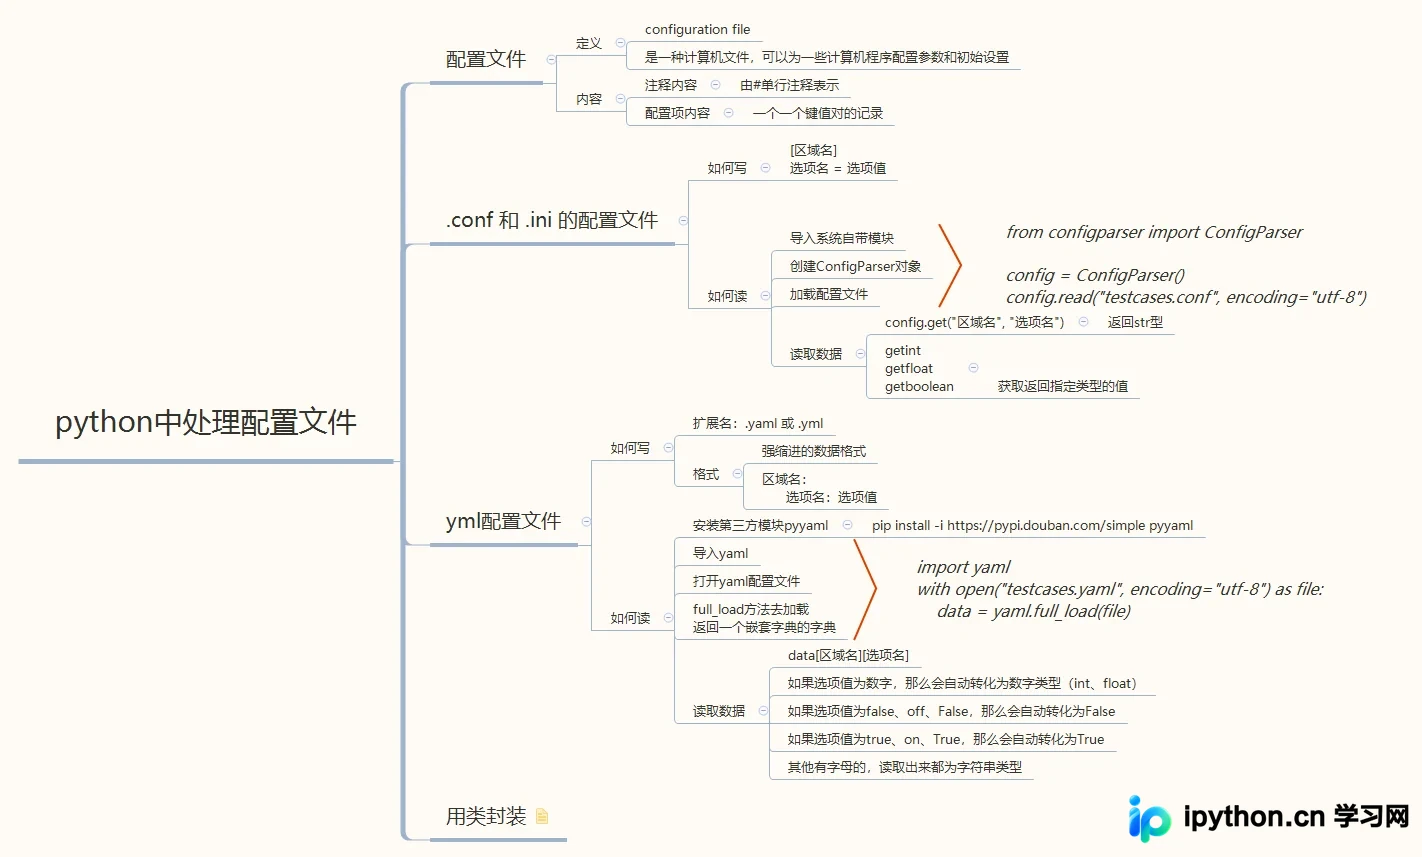
本文详细介绍如何在Python中利用yaml库读取和处理配置文件。通过一个具体的HandleYaml类封装示例,演示如何加载YAML文件并提取指定键值对数据,帮助开发者高效管理项目配置参数。
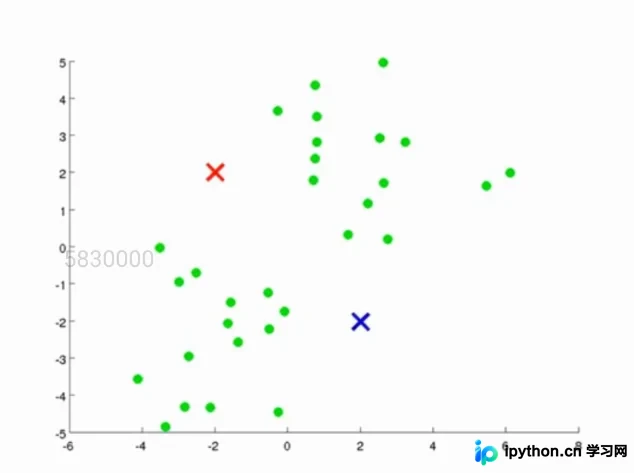
本文详细解析K-Means均值聚类算法的核心原理,包括质心初始化、距离计算、类别分配及质心更新迭代过程。通过Python代码结合make_blobs数据集,演示如何利用scikit-learn进行聚类建模与可视化,帮助读者理解无监督学习中的特征分组逻辑。
本文深入解析Python中内存泄漏与内存溢出的成因及区别。详细阐述循环引用、全局容器等泄漏根源,并提供基于gc和objgraph模块的实战诊断步骤。同时针对内存溢出场景,给出从参数调整到代码审查的完整解决方案,帮助开发者高效定位并修复内存问题。
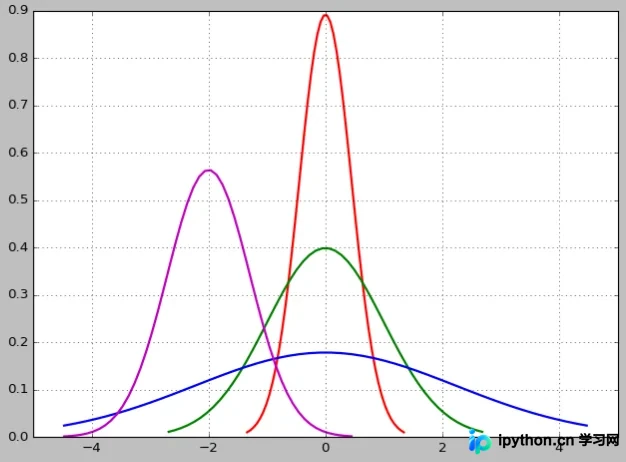
本文介绍如何利用Python的Matplotlib和NumPy库绘制正态分布的概率密度函数。通过设定不同的均值和标准差参数,代码展示了多条正态曲线的对比效果,帮助理解正态分布中参数对曲线形态的影响。