

Scrapy异常处理实战:捕获HTTP错误与代码异常
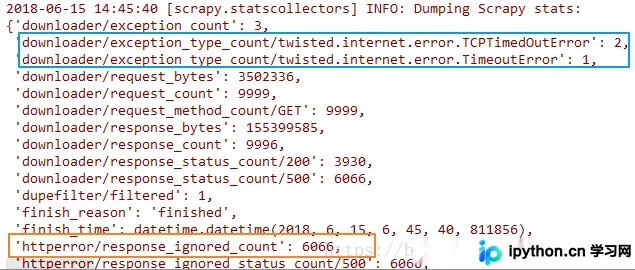
本文详解Scrapy中处理下载错误的两种主要场景:HTTP状态码异常(如403/500)与代码执行异常。通过深入分析RetryMiddleware源码,揭示process_response与process_exception的工作机制,并提供一个自定义中间件模板,用于兜底捕获未重试成功的请求,确保爬虫在长时间运行时的稳定性与数据完整性。
2026-10-14
23

本文详解Scrapy中处理下载错误的两种主要场景:HTTP状态码异常(如403/500)与代码执行异常。通过深入分析RetryMiddleware源码,揭示process_response与process_exception的工作机制,并提供一个自定义中间件模板,用于兜底捕获未重试成功的请求,确保爬虫在长时间运行时的稳定性与数据完整性。
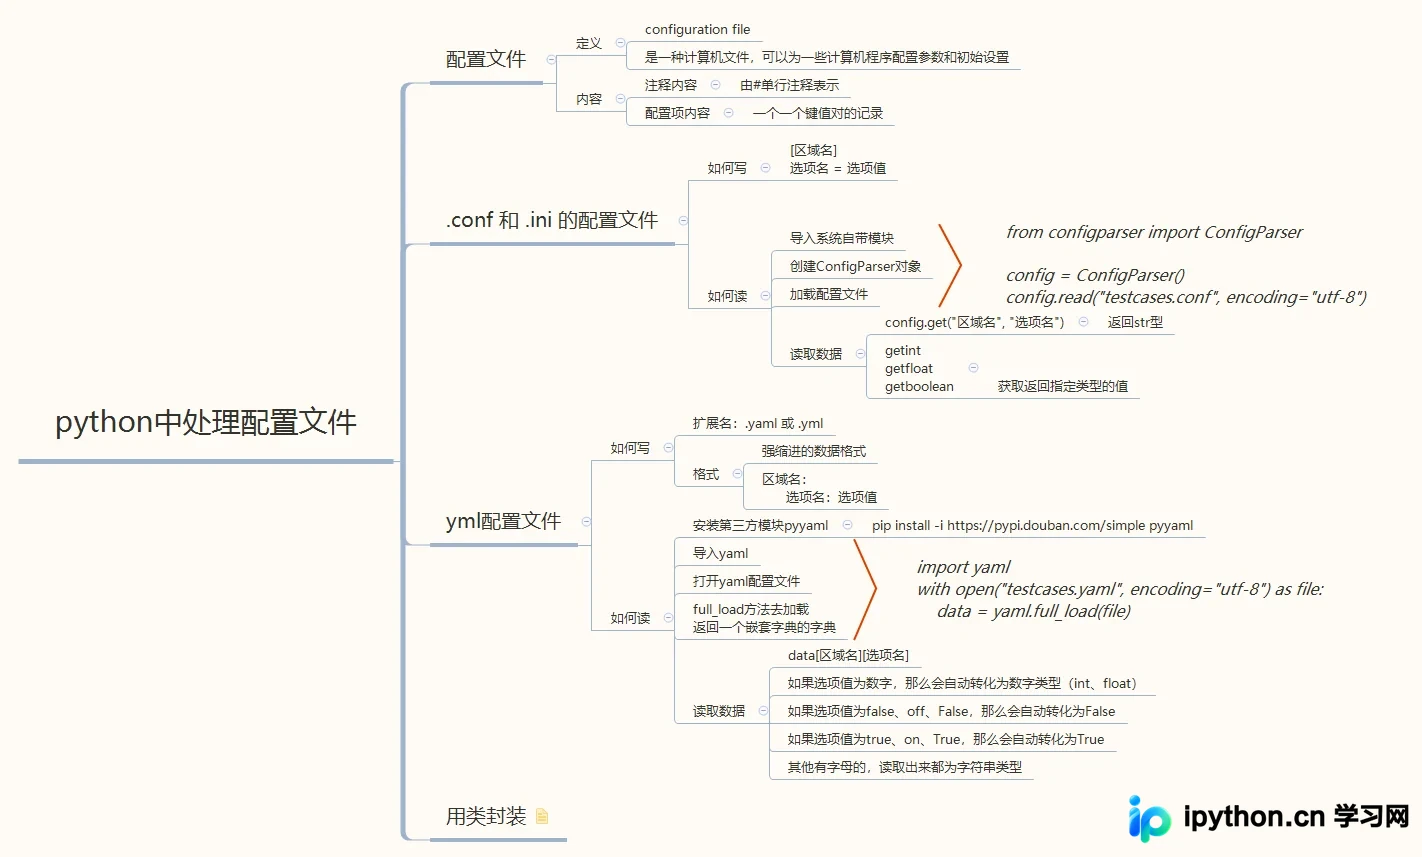
本文详细介绍如何在Python中利用yaml库读取和处理配置文件。通过一个具体的HandleYaml类封装示例,演示如何加载YAML文件并提取指定键值对数据,帮助开发者高效管理项目配置参数。
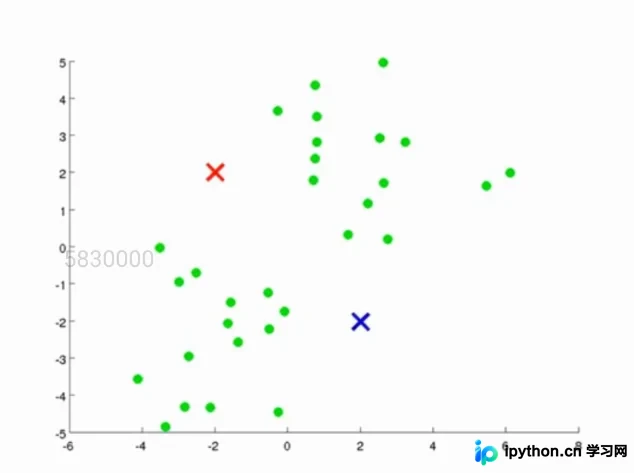
本文详细解析K-Means均值聚类算法的核心原理,包括质心初始化、距离计算、类别分配及质心更新迭代过程。通过Python代码结合make_blobs数据集,演示如何利用scikit-learn进行聚类建模与可视化,帮助读者理解无监督学习中的特征分组逻辑。
本文深入解析Python中内存泄漏与内存溢出的成因及区别。详细阐述循环引用、全局容器等泄漏根源,并提供基于gc和objgraph模块的实战诊断步骤。同时针对内存溢出场景,给出从参数调整到代码审查的完整解决方案,帮助开发者高效定位并修复内存问题。
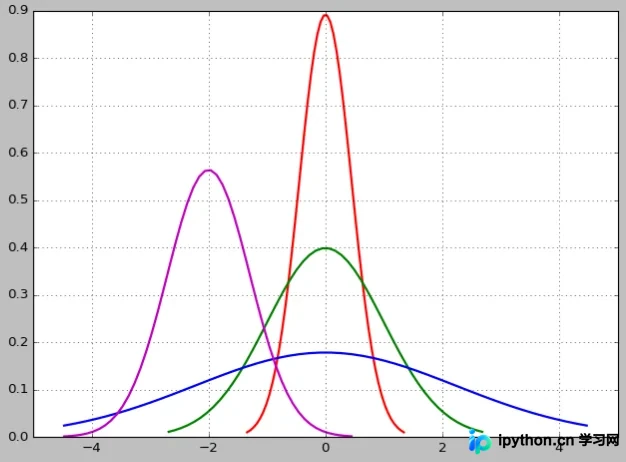
本文介绍如何利用Python的Matplotlib和NumPy库绘制正态分布的概率密度函数。通过设定不同的均值和标准差参数,代码展示了多条正态曲线的对比效果,帮助理解正态分布中参数对曲线形态的影响。
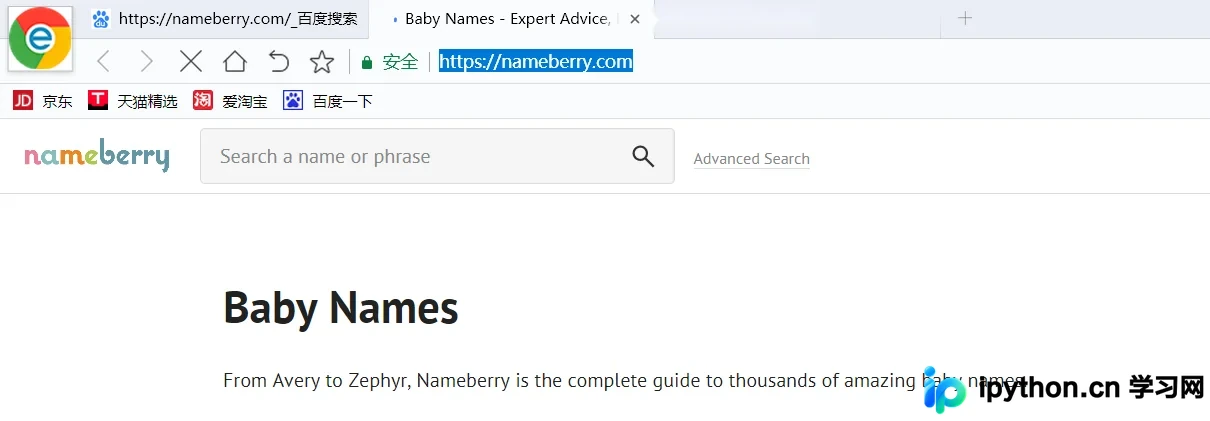
本文以Nameberry网站为例,详细演示使用Python抓取网页评论数据的完整流程。内容涵盖从分析网页结构、自动生成A-Z链接、处理分页逻辑,到解析HTML提取姓名、用户名、时间及评论内容的全过程。文中提供了基于requests和BeautifulSoup的核心代码片段,并强调了遵守爬虫协议及异常处理的重要性,帮助开发者掌握基础爬虫技巧。
本文详细介绍Python中zip()函数的核心用法。通过实例演示如何将多个可迭代对象打包为元组,处理长度不一致的情况,并利用*操作符解压。此外,还涵盖利用zip()将列表转换为字典、同时遍历多个字典键值对的高级技巧,帮助开发者高效处理数据聚合与迭代任务。
本文提供 Python 中使用 PyCryptodome 库进行 RSA-OAEP 加密与解密的完整代码示例。内容涵盖如何生成 1024 位 RSA 密钥对、导出公钥与私钥,以及如何利用 PKCS1_OAEP 方案对字符串进行加密并还原。代码包含详细的注释,适用于需要实现非对称加密功能的 Python 开发者参考。
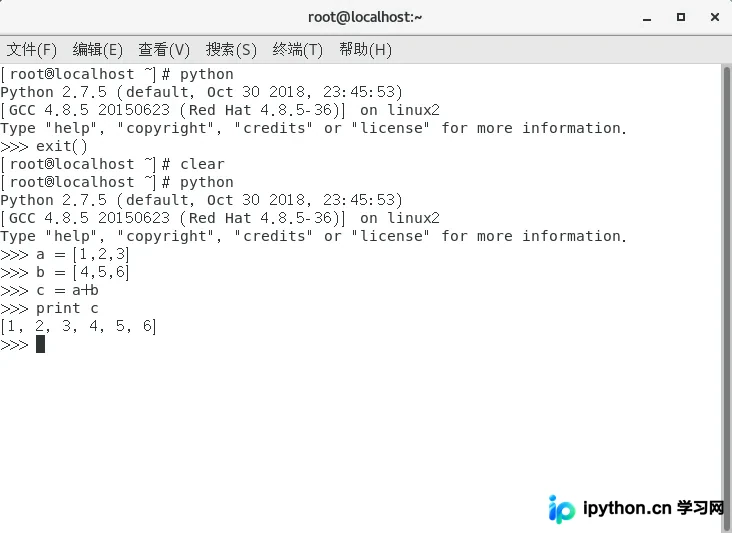
本文详解Python中合并两个列表的三种方式:使用+运算符、extend()方法及append()方法。重点区分+生成新对象与extend原地修改的区别,并澄清append仅添加单个元素的特性,帮助开发者根据性能需求选择合适方案。
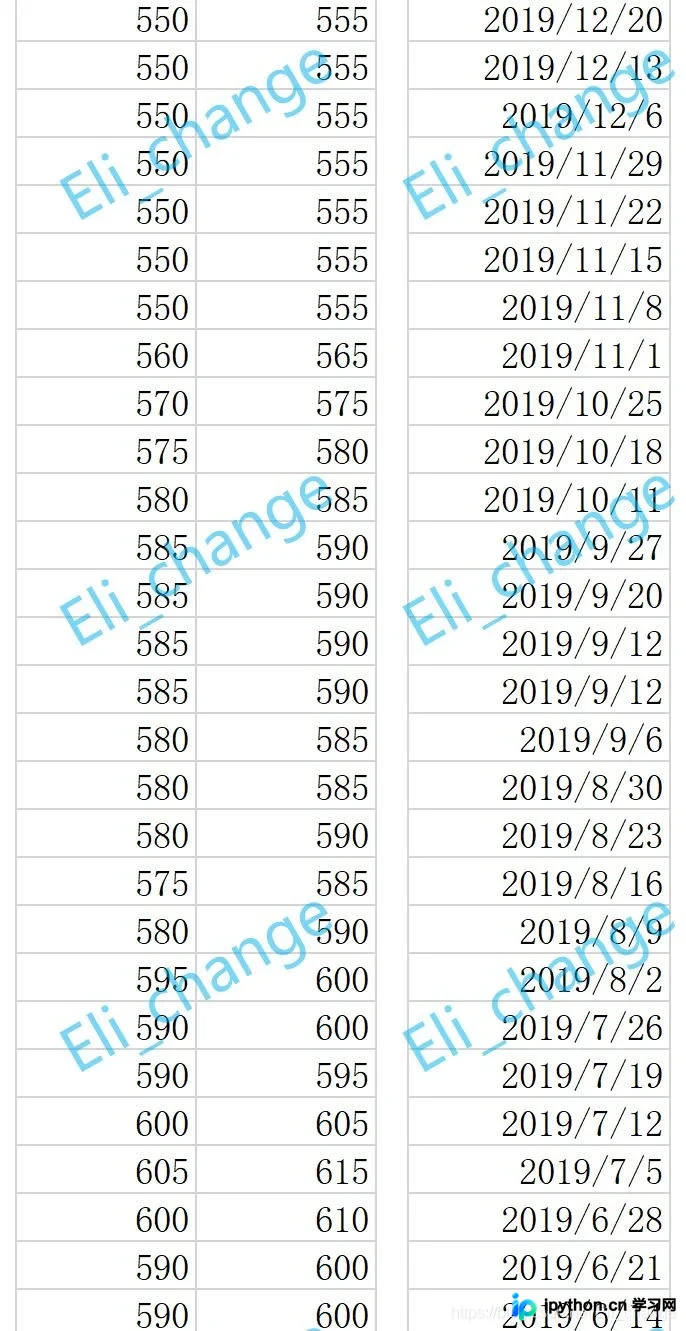
本文介绍如何使用Python读取包含日期和价格的CSV文件,通过字符串处理将多列数据分离为最高价、最低价和均价列表。利用matplotlib库绘制折线图,并使用reversed()函数调整时间轴顺序,最终生成清晰的周价格波动图表。
本文介绍如何利用Python的paramiko库实现交换机密码的批量修改。通过安装依赖、编写SSH连接脚本并执行命令行指令,可自动化完成多台设备的配置更新与保存,提升网络运维效率。
本文详解Python中bool函数的核心用法。bool函数用于判断参数的真假值:数字中仅0为False,其余为True;字符串中None或空串为False,非空为True;空列表、字典及元组返回False,否则为True。通过实际案例展示如何利用bool判断变量是否已设置,帮助开发者准确掌握类型转换逻辑。