

Jupyter Notebook 完整显示行列与解决输出截断问题
本文介绍如何在 Jupyter Notebook 中通过 pd.set_option 配置最大显示行数和列数,以及浮点数精度,确保数据预览完整。同时提供解决更换主题后输出区域字符截断的 CSS 修改方案,包括调整 div.output_area 的 padding 值,帮助开发者优化数据查看体验。
2026-10-13
24

本文介绍如何在 Jupyter Notebook 中通过 pd.set_option 配置最大显示行数和列数,以及浮点数精度,确保数据预览完整。同时提供解决更换主题后输出区域字符截断的 CSS 修改方案,包括调整 div.output_area 的 padding 值,帮助开发者优化数据查看体验。
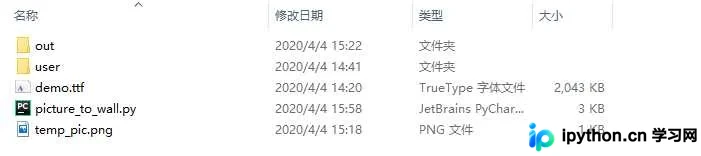
本文介绍如何使用Python的PIL库生成照片墙。通过生成文字图像,利用透明度映射技术将小图片拼贴到文字区域,实现个性化照片墙效果。文章涵盖PIL基础、图像格式转换、像素操作及透明度处理等核心知识点,并提供完整代码示例与目录结构说明。
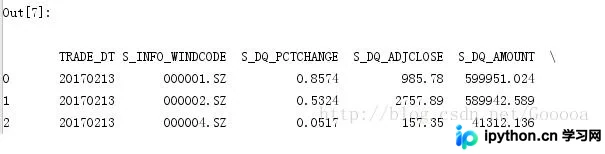
本文主要介绍如何解决Python中DataFrame打印结果自动换行的问题,通过设置pd.set_option('display.width', 5000)调整显示宽度。同时补充了Python2.7中实现字符不换行打印的三种方法:使用print后加逗号、引用__future__模块自定义end参数以及调用sys模块直接输出,帮助开发者灵活控制输出格式。
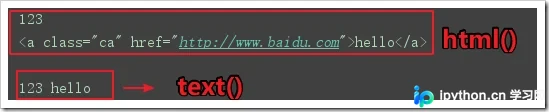
本文详解Python爬虫中PyQuery模块的基本用法。PyQuery基于lxml,提供类似jQuery的API解析HTML/XML。内容涵盖模块安装、三种初始化方式(字符串、URL、文件)、丰富的CSS选择器(标签、类、ID、属性、伪类)及DOM操作(查找、过滤、添加/移除Class)。通过豆瓣新书爬取实例,演示如何定位元素、提取文本属性及处理分页逻辑,适合Python初学者快速掌握网页数据抓取技巧。
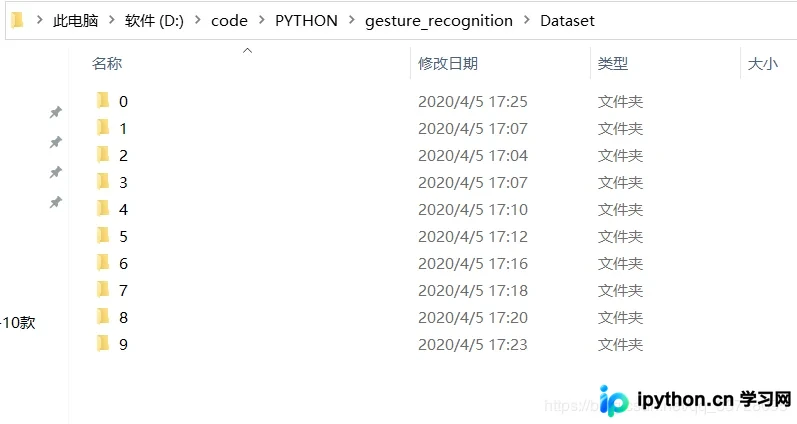
本文详细介绍如何使用 TensorFlow 2.x 构建自定义图像数据集以训练手势识别模型。内容涵盖从摄像头采集图片、整理目录结构、读取文件路径,到使用 tf.data 进行图像预处理和批量加载的全过程。通过具体代码示例,展示如何构建训练集与测试集,为后续模型训练奠定基础。
本文详细介绍如何在Python3中配置和使用logging模块。通过封装配置类与日志类,实现从配置文件读取日志设置。内容涵盖日志级别说明、Python2与Python3的实现差异,以及解决日志污染、多文件输出和日志轮转等实际问题的进阶方案,提供完整代码示例。
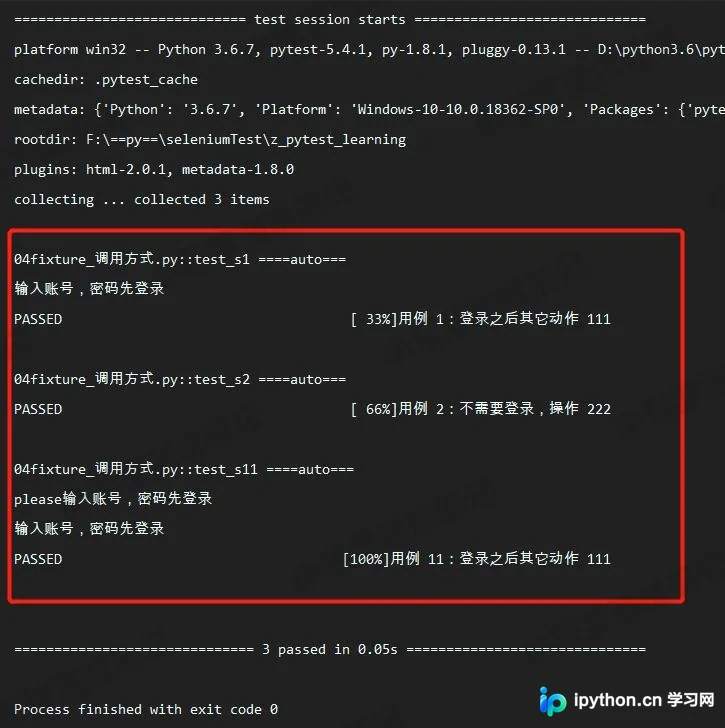
本文深入解析Pytest框架中fixture的核心用法,涵盖scope作用域(function至session)、autouse自动调用、params参数化及ids标识。详细演示通过函数传参、usefixtures装饰器及autouse三种调用方式,并对比session与function的实例化顺序。重点讲解利用yield关键字和addfinalizer实现Teardown后置清理的逻辑与异常处理差异,提供完整代码示例与注意事项。
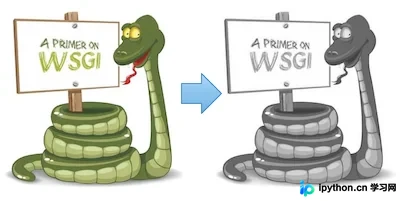
本文详细介绍如何使用Python的PIL库(Pillow)进行图片灰度处理。涵盖从环境配置、库安装到核心代码实现的完整流程,重点解析Image对象的convert('L')方法应用。通过具体代码示例和运行结果,展示如何将彩色JPG图片转换为灰度图像,适合Python初学者及需要批量处理图片的技术人员参考。
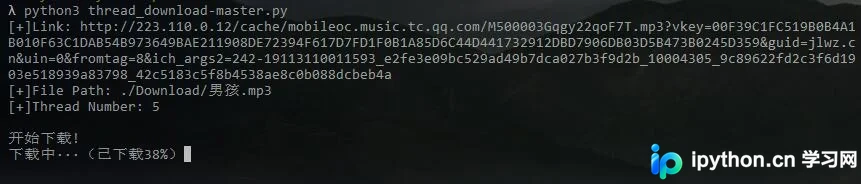
本文介绍使用Python实现多线程下载网络资源的完整脚本。通过Download类计算文件总大小并分配线程任务,结合ThreadDownload类继承threading.Thread实现并发读写。代码包含URL请求头设置、分块下载逻辑及进度回显功能,适用于歌曲或大文件的高效下载场景。
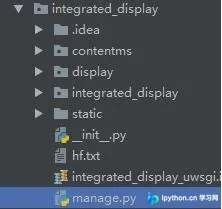
本文介绍在Django项目中新增App的两种常用方法:通过PyCharm工具栏或命令行执行startapp命令。创建后需在settings.py中注册。针对多App场景,重点讲解如何通过目录结构区分静态资源,并在urls.py中配置不同App的路由映射,解决同名文件冲突及URL路由问题。
本文深入解析Django中单条记录保存的两种主要方式:save()与update()。通过对比底层生成的SQL语句,指出update在批量或单条更新时具有更高的执行效率。此外,文章详细讲解了save(commit=False)方法在处理非表单字段(如author)时的应用场景,以及配合save_m2m()处理多对多关系的完整流程,帮助开发者写出更高效的Django代码。
本文介绍使用Python爬取手机号前7位归属地的实现方案。通过对比单线程与多线程版本,展示从耗时1个半小时到2-3分钟的优化过程。单线程处理10000次查询需约90分钟,而多线程(32线程)处理1000条数据仅需2-3分钟,CPU占用约70%。最终40多个号段、41万条数据的爬取总耗时约1-2小时,提供了完整的代码示例与性能数据。