

Python在main中调用函数内嵌套函数的方法及列表处理技巧
本文详解Python中如何在外部调用函数内部定义的嵌套函数,通过返回内部函数引用实现灵活调用。同时探讨在函数内处理列表或矩阵时,如何避免修改原数据的问题,提供字典转列表及引入numpy库两种解决方案,确保原数据结构不受影响。
2026-10-13
19

本文详解Python中如何在外部调用函数内部定义的嵌套函数,通过返回内部函数引用实现灵活调用。同时探讨在函数内处理列表或矩阵时,如何避免修改原数据的问题,提供字典转列表及引入numpy库两种解决方案,确保原数据结构不受影响。
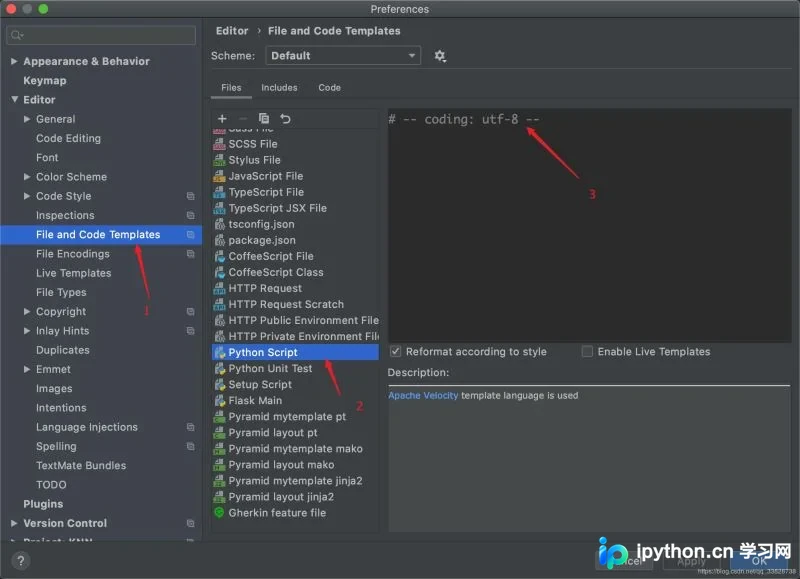
本文详细介绍如何在 PyCharm 中设置默认的 UTF-8 编码格式,避免代码因编码问题报错。同时提供两种常见的 Python 文件头部编码声明注释写法,帮助开发者规范代码格式,提升开发体验。
本文详解Python爬虫应对常见反爬策略的三种核心方案:通过维护代理IP池解决IP限制与验证码问题;利用time.sleep控制访问频率以规避限流;以及通过设置User-Agent和Referer头伪装浏览器身份。内容涵盖Requests与Urllib库的具体代码实现,帮助开发者提升爬虫稳定性。
本文介绍如何利用C#中的System.Net.Mail命名空间下的SmtpClient类,快速实现支持HTML格式的邮件发送功能。通过封装SendSmtpEmail方法,可传入服务器地址、凭据及收件人信息,完成基础的SMTP协议通信。适合需要集成通知功能的桌面或Web应用参考。
本文解析在Python的for循环中直接调用list.remove()导致元素漏删的根本原因。由于列表长度动态变化与迭代器索引递增不同步,部分目标元素会被跳过。通过复制列表副本进行遍历和删除操作,可有效避免此问题,确保数据处理的完整性与安全性。
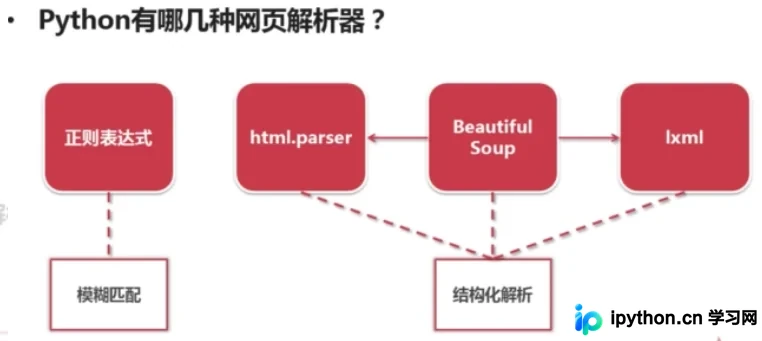
本文详解Python中常见的网页解析工具,包括正则表达式、html.parser、BeautifulSoup及lxml。重点介绍基于DOM树的结构化解析原理,并通过urllib与requests库结合BeautifulSoup的完整代码示例,展示如何获取和解析网页内容,帮助开发者快速掌握网页数据提取的核心方法。
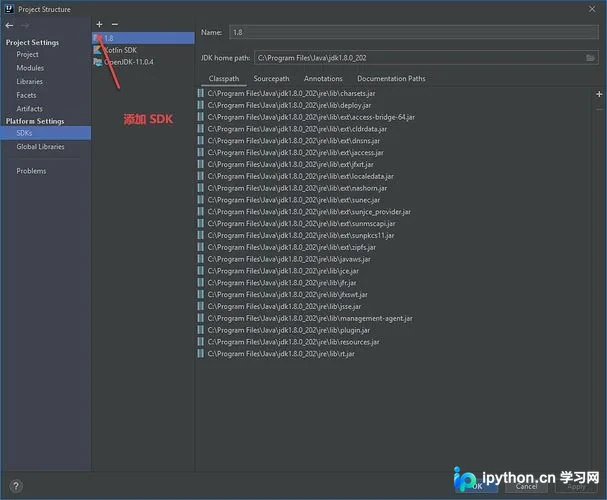
本文详解在 IntelliJ 中配置 Anaconda Python SDK 的操作流程。通过 Project Structure 添加 SDK,系统可自动识别已安装的 Anaconda,若未安装则需先完成环境部署。配置完成后保存并等待库刷新,即可在项目中正常使用 Python 环境进行开发。
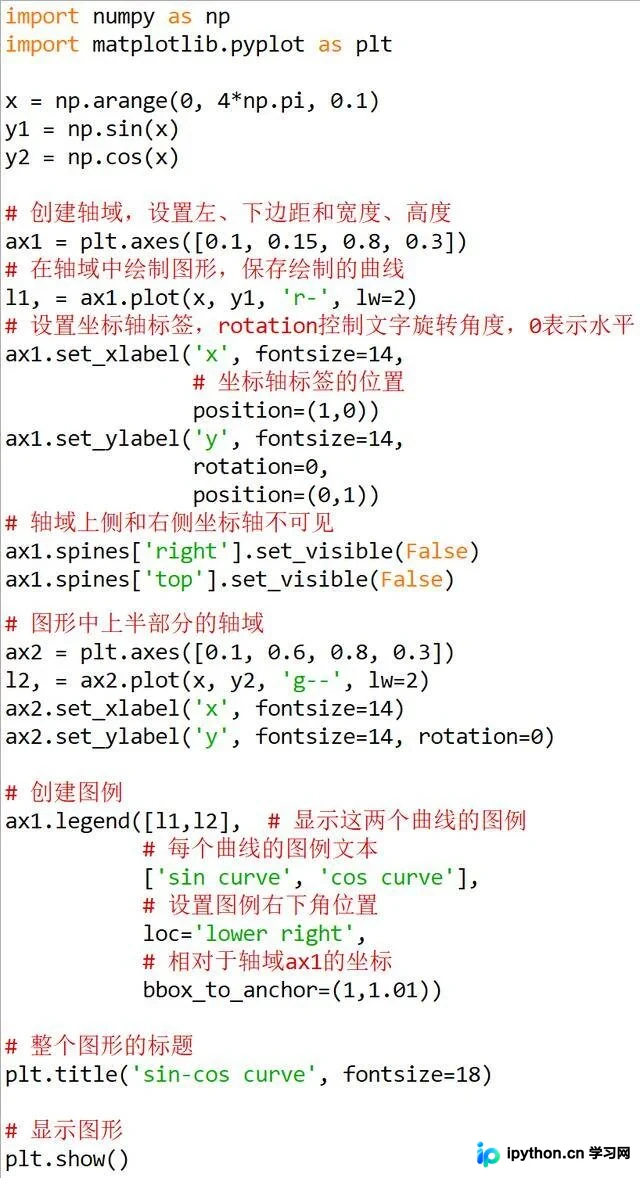
本文通过四个 Python matplotlib 实例,详细演示了如何创建轴域、设置坐标轴标签与图例位置。内容涵盖正余弦曲线绘制、图例字体与背景样式定制、多子图图例合并显示,以及复杂图形中多个图例的共存处理,帮助开发者掌握高级可视化技巧。
本文详细介绍如何利用Python结合Tesseract引擎实现图片文字识别。内容涵盖Tesseract的安装与系统环境变量配置、中英文语言包的下载与部署,以及使用pytesseract和Pillow库进行单张和批量图片识别的具体代码示例。同时分析了不同字体和倾斜角度对识别准确率的影响,为开发者提供实用的OCR解决方案。
本文详细介绍使用Python爬虫批量获取动漫网站截图的完整流程。通过requests发送请求,利用正则表达式解析HTML提取图片链接与标题,结合os库管理文件存储,并引入time模块控制爬取频率以遵守网站规范。文章提供完整代码示例及分页处理技巧,帮助初学者快速掌握图片抓取实战技能。
本文详细介绍Python中的注释写法,包括以#开头的单行注释和多行字符串(三引号)的多行注释。通过实例演示如何查看函数文档字符串,帮助开发者规范代码说明,提升代码可读性。
本文详细解析Python中threading模块的使用,重点介绍Thread类的target、args及kwargs参数配置。通过抓取天气数据的实例,演示如何创建线程列表、启动子线程以及利用join方法实现主线程与子线程的同步,确保程序逻辑完整执行。