


在 Atmosphere 通信正常时直接关闭浏览器,不少项目都会偶尔看到一条 WARN:Exception during suspend() operation。这类日志最容易被当成连接中断的附带噪声,但如果只停留在“浏览器关闭导致的 harmless warning”这个判断上,往往会错过真正的问题入口。本文按源码追到 AtmosphereResourceImpl 与 scalatra-atmosphere 的监听器实现,说明这条日志究竟从哪里来、为什么堆栈默认被藏起来,以及线上该怎样判断它是框架噪声还是业务监听异常。
为什么会看到这条 WARN
问题现象很直接:在 Atmosphere 通信正常的情况下关闭浏览器,日志里有时会出现下面这一行。
[qtpxxx-xx] WARN org.atmosphere.cpr.AtmosphereResourceImpl - Exception during suspend() operation xxxException
单看 WARN 级别,很多人第一反应是“应该问题不大”。但真正让人别扭的是两点:一是日志没有直接给出清晰的出错行;二是用户明明只是关闭浏览器,为什么服务端会报出看起来像框架内部异常的消息。
这里先说明一下排查环境。源码观察的是 Atmosphere 2.4.13,对比过 2.6.x,这块逻辑基本没变。至于 2.5.x,原文环境里并不能正常跑起来;同时新版本和 Scala 的兼容性也不理想,所以实际项目里很容易还停留在较老组合上。这一点很关键,因为它意味着你看到的日志,很可能不是某个新版本刚引入的问题,而是这套调用链长期如此。
从 AtmosphereResourceImpl 追到 onDisconnect
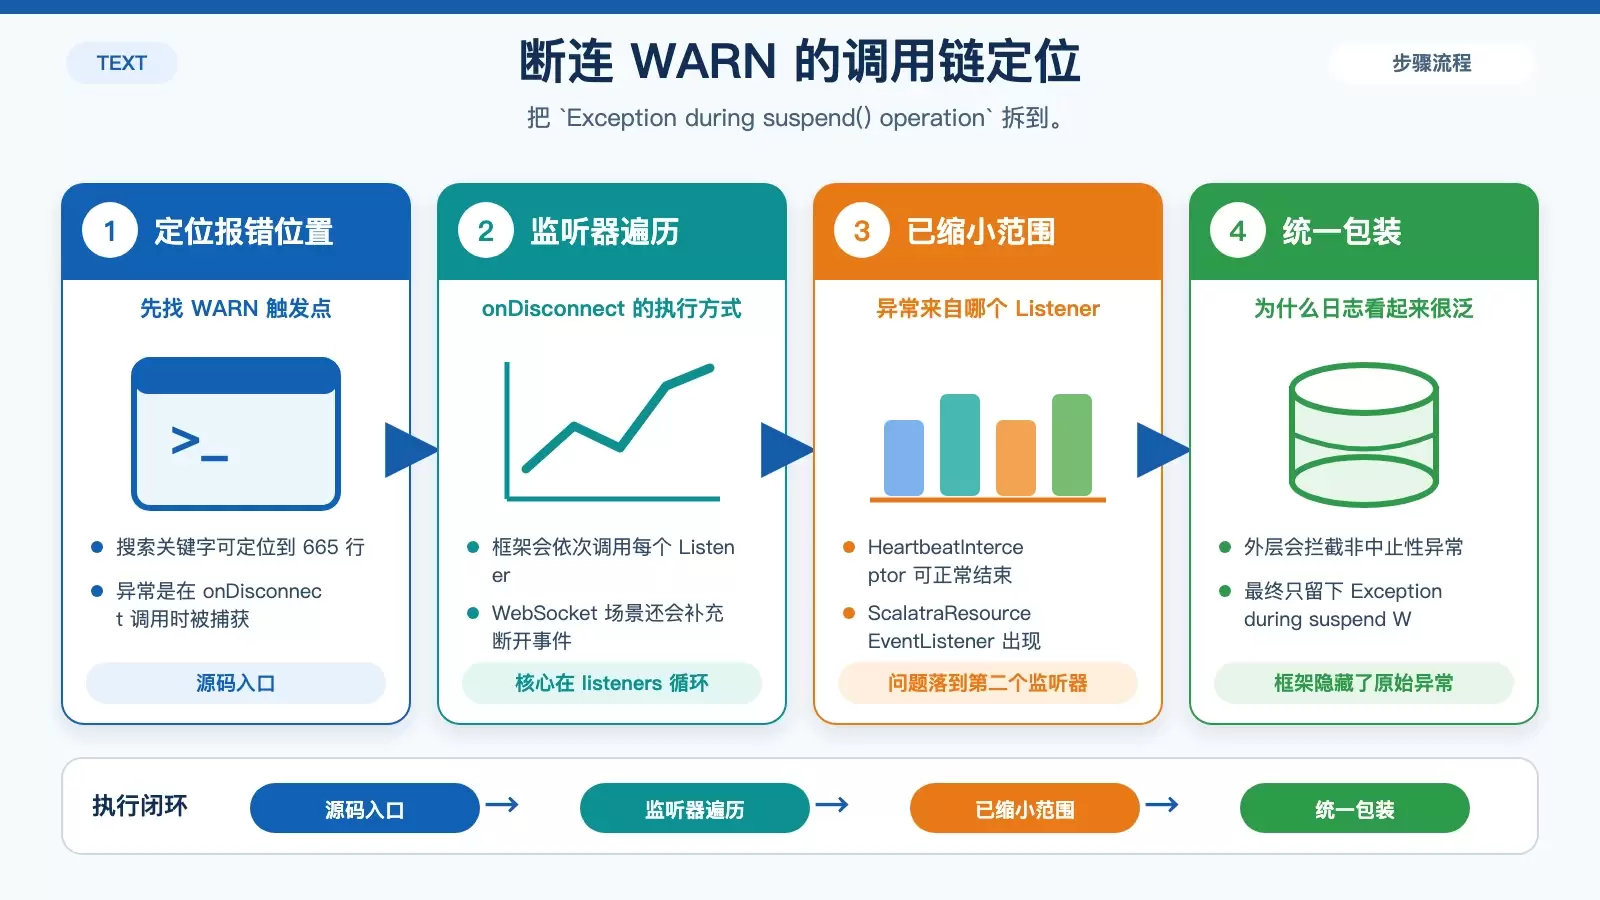
在 AtmosphereResourceImpl 中直接搜索 Exception during suspend,可以定位到报错位置。按原文给出的版本,位置在 665 行。逐步调试后会发现,异常是在调用 onDisconnect 时被捕获的;继续跟到 753 行,可以看到这段核心代码:
void onDisconnect(AtmosphereResourceEvent e) {
    for (AtmosphereResourceEventListener r : listeners) {
        r.onDisconnect(e);
        if (transport.equals(TRANSPORT.WEBSOCKET) && WebSocketEventListener.class.isAssignableFrom(r.getClass())) {
            WebSocketEventListener.class.cast(r).onDisconnect(new WebSocketEventListener.WebSocketEvent(1005, CLOSE, webSocket));
        }
    }

    if (e.getResource() != null) {
        config.framework().notifyDestroyed(e.getResource().uuid());
    }
}
这段代码的含义并不复杂:连接断开时,框架会遍历当前资源上挂着的所有 Listener,依次调用它们的 onDisconnect。如果是 WebSocket 传输,还会补一次针对 WebSocketEventListener 的断开事件。最后,如果资源对象还在,就通知框架销毁对应资源。
也就是说,这里的异常并不一定来自 Atmosphere 自己的网络层收尾动作,更可能来自某个监听器在断开回调里的执行失败。原文环境里,正常情况下会挂两个监听器:
org.atmosphere.interceptor.HeartbeatInterceptor$2(Heartbeat Interceptor Support)org.scalatra.atmosphere.ScalatraAtmosphereHandler$ScalatraResourceEventListener
实际调试结果是,第一个监听器能正常结束,第二个监听器触发了空指针。到这里,问题范围已经明显缩小:这条 WARN 的来源不是“浏览器关闭”本身,而是“断开事件触发后,某个监听器在处理断开逻辑时抛了异常”。
真正出错的位置在 Scalatra 的断开监听
继续进入第二个监听器,也就是 scalatra-atmosphere 里的实现。原文使用的是 _2.12:2.65 版本;这里之所以会看到两个版本号,是因为在 Gradle 依赖坐标里,Scalatra 的包名本身带有 Scala 版本后缀,而子模块还有自己的发布版本号。作者也检查过 2.7.1,对应代码仍然一样。
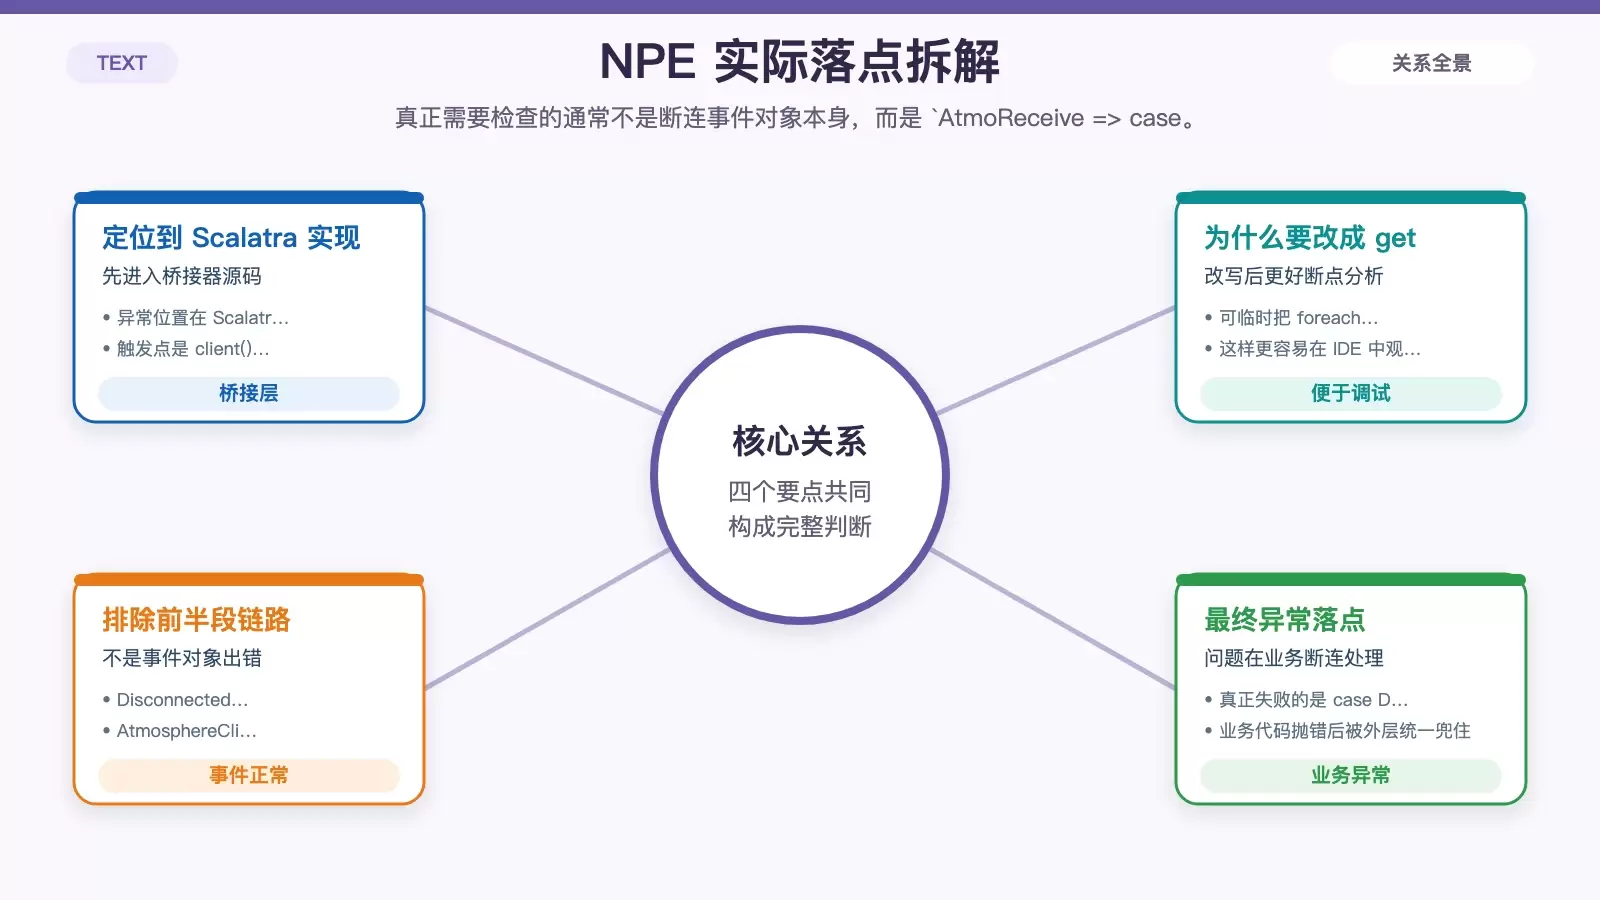
具体实现位于 org.scalatra.atmosphere.ScalatraAtmosphereHandler.scala。发生异常的位置在 36 行,也就是调用 client() 的地方:
def onDisconnect(event: AtmosphereResourceEvent): Unit = {
  val disconnector = if (event.isCancelled) ClientDisconnected else ServerDisconnected
  client(event.getResource) foreach (_.receive.lift(Disconnected(disconnector, Option(event.throwable))))
  //      if (!event.getResource.isResumed) {
  //        event.getResource.session.invalidate()
  //      } else {
  event.getResource.session.removeAttribute(org.scalatra.atmosphere.AtmosphereClientKey)
  //      }
}
为了更容易调试,原文建议临时把这段 foreach 改成直接 get,这样更容易在 IDE 里停住并观察对象状态:
client(event.getResource).get.receive.lift(Disconnected(disconnector, Option(event.throwable)))
最后定位到的结果是:空指针并不在 Disconnected(disconnector, Option(event.throwable)) 这个事件对象构造上,也不在框架取到的 AtmosphereClient 本身,而是在业务定义的 AtmoReceive => case Disconnected 分支中抛出了异常。
换句话说,client(event.getResource).get.receive 已经拿到了你在使用 Atmosphere 时定义的消息接收器;真正炸掉的是这个接收器处理 Disconnected 事件时执行的那段业务逻辑。只要这里出现任何非中止性的异常,外层的 AtmosphereResourceImpl 就会把它兜住,再统一打出 Exception during suspend 这条 WARN。而更详细的堆栈信息,只有在 DEBUG 日志级别下才会输出。
这条日志到底是不是“无害”
围绕这个问题,Vaadin 社区里也有人讨论过,因为 Vaadin 同样使用了 Atmosphere。帖子的回复认为:如果异常发生在用户关闭浏览器时,它通常是无害的;服务端并不知道浏览器是正常关闭、页面崩溃,还是通信链路中途断开,所以记录一条异常日志可以理解。
这个解释有一定现实背景,但如果严格按源码逻辑看,它并不能完整覆盖问题本质。因为从这里的调用链可以看出,被记录下来的并不是“浏览器关闭”这个动作本身,而是“断开事件回调中某个监听器执行失败”。
也就是说,无论用户是主动关掉浏览器、网络闪断,还是服务端主动断开,对 Atmosphere 来说都会进入断开回调。真正决定这条 WARN 会不会出现的,不是断开的原因,而是 Disconnected 这一路监听逻辑里有没有抛异常。
这就意味着以下几类问题都会被包装成同一条日志:
- 断开时记录日志的代码本身抛错;
- 更新用户在线状态时抛错;
- 向其他客户端广播离线消息时抛错;
- 监听器内部访问了空对象、失效 session 或其他业务资源。
因此,这条 WARN 不能简单理解为“用户关浏览器,忽略即可”。更准确的说法应该是:浏览器关闭只是触发了 onDisconnect,但真正记录下来的是断开处理代码里发生的异常。它有可能是无害噪声,也完全可能是业务断连流程的真实 bug。
为什么默认看不到堆栈,以及能怎么处理
这个问题的另一个麻烦点,在于日志可观察性并不好。AtmosphereResourceImpl 会拦截这些异常并统一输出 WARN,但详细堆栈默认并不会在常规日志级别直接展开,所以你看到的经常只是一条不够具体的提示。
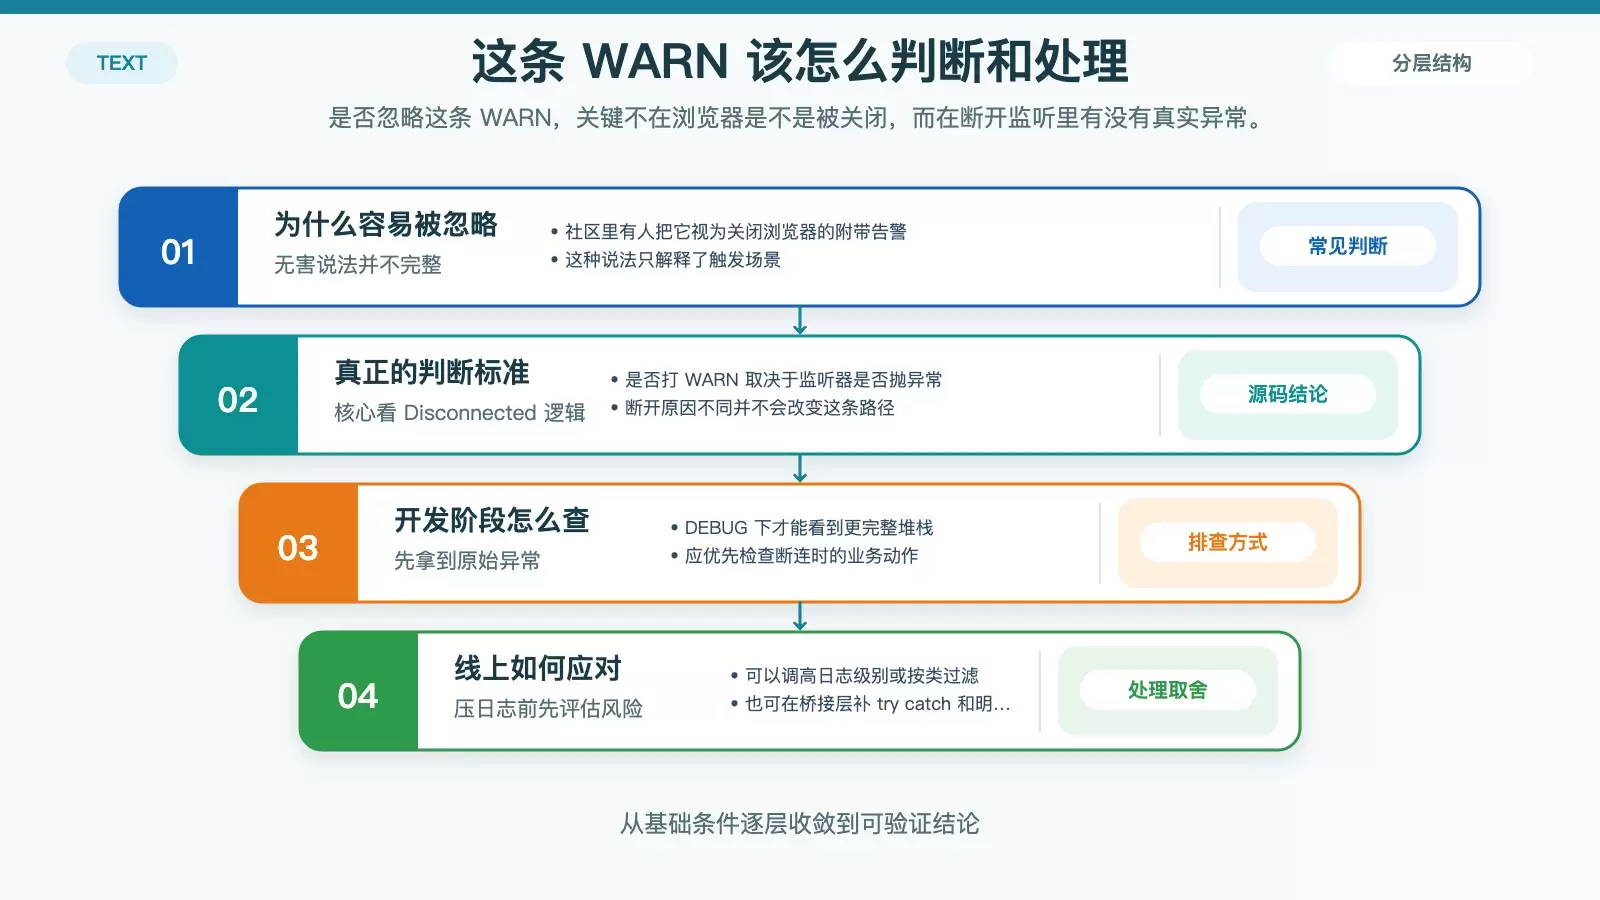
从原文分析来看,这段 WARN 基本没有更细粒度的开关控制。只要 Disconnected 监听异常,就会落到这里。因此,想“关闭这条日志”通常只有几种粗粒度办法:
- 把相关类的日志级别调高到
ERROR,让这类WARN不再输出; - 对
org.atmosphere.cpr.AtmosphereResourceImpl单独做日志过滤; - 开发和排障阶段把日志调到
DEBUG,拿到真实堆栈,先把断开监听里的异常找出来。
但这里有个明显代价:如果在线上只是简单压掉 WARN,你也可能顺手把真实的断连处理异常一起藏掉。对于依赖长连接维护用户状态、在线人数、会话广播的系统来说,这不是一个理想方案。
更稳妥的思路是把问题分成两层处理:
先确认是不是业务侧 Disconnected 逻辑异常
既然调试已经证明 NPE 来自 AtmoReceive => case Disconnected,那就应该优先检查这段业务代码是否访问了可能为空的对象、已销毁的会话或不可重入的资源。很多“浏览器一关就报错”的现象,实际上只是平时不容易命中的边界条件在断开回调里暴露了出来。
再决定是否要在桥接层补日志
原文最后提到一个很现实的改法:既然问题集中在 scalatra-atmosphere 的 onDisconnect,理论上可以在这里包一层 try catch,直接以更明确的 ERROR 或至少完整堆栈的方式打印出来。作者也提到,同文件下面的 liftAction() 本来就有 try catch,甚至直接 printStackTrace(),说明桥接层并不是完全不能做这件事。
只是从项目维护现实看,这类修补未必容易推动。Scalatra 把不少子组件放在主项目体系里,边界并不干净;而从框架责任划分上,Scalatra 也很可能认为这个问题应该由 Atmosphere 自己处理。于是最终常见的结果就是:框架层保持现状,使用方只能自己在业务逻辑或本地分支里兜底。
版本现状与选型判断
这次排查顺带暴露了 Atmosphere 生态的另一个问题:维护状态并不理想。原文提到 AtmosphereResourceImpl 这个类本身就超过一千行,全类多个方法累计抛出 22 个异常,内部职责偏重,异常处理方式也不算清晰。
还有一个细节很能说明问题:类中某条错误消息附带的链接早已失效。原文指出,在 144 行(较新版本中在 141 行)有一个关于获取 Session 的问题链接,指向的是 GLASSFISH-18856。但 java.net 早已关闭,2016 年 Oracle 就公告下线相关站点;后续 GitHub 上与该问题关联的旧讨论链接也已经找不到,甚至出现 404。这说明这套代码里有些历史包袱已经长期无人收拾。
所以,站在工程选型角度,这次结论其实不只是“怎么定位一条 WARN”,还包括一个更实际的判断:如果你的项目已经被 Scalatra 绑定在 Atmosphere 之上,那短期内需要接受它的历史行为,并为断开回调补充更强的自检和日志;如果还处于可选型阶段,Atmosphere 并不是一个足够让人放心的新项目方案。
至少在现有实现里,这条 Exception during suspend() operation 不该被理解成单纯的网络层提示。它更像一个被框架统一包装后的异常出口,真正的故障点往往在你自己的 Disconnected 处理逻辑里。先把这里查清,再决定是否压日志,才是更稳妥的排查顺序。









