


前端页面是否泄漏内存,往往不是靠一次 DevTools 排查就能兜住,真正难的是把问题前移到自动化测试和发布流程里。本文把可执行的做法拆成四部分:如何采样堆内存、怎样用 DOM 节点数做跨浏览器兜底、何时导出堆快照,以及如何设置告警级与阻断级阈值,让内存问题真正成为 CI/CD 里的质量红线。
用 Puppeteer 或 Playwright 采样堆内存变化
在自动化性能测试里,第一步不是直接下结论“发生了泄漏”,而是先把每次操作前后的内存变化记录下来。对于 Chromium 环境,可以直接通过 page.evaluate(() => performance.memory) 获取堆内存数据,把原本肉眼观察的过程改成脚本采样。
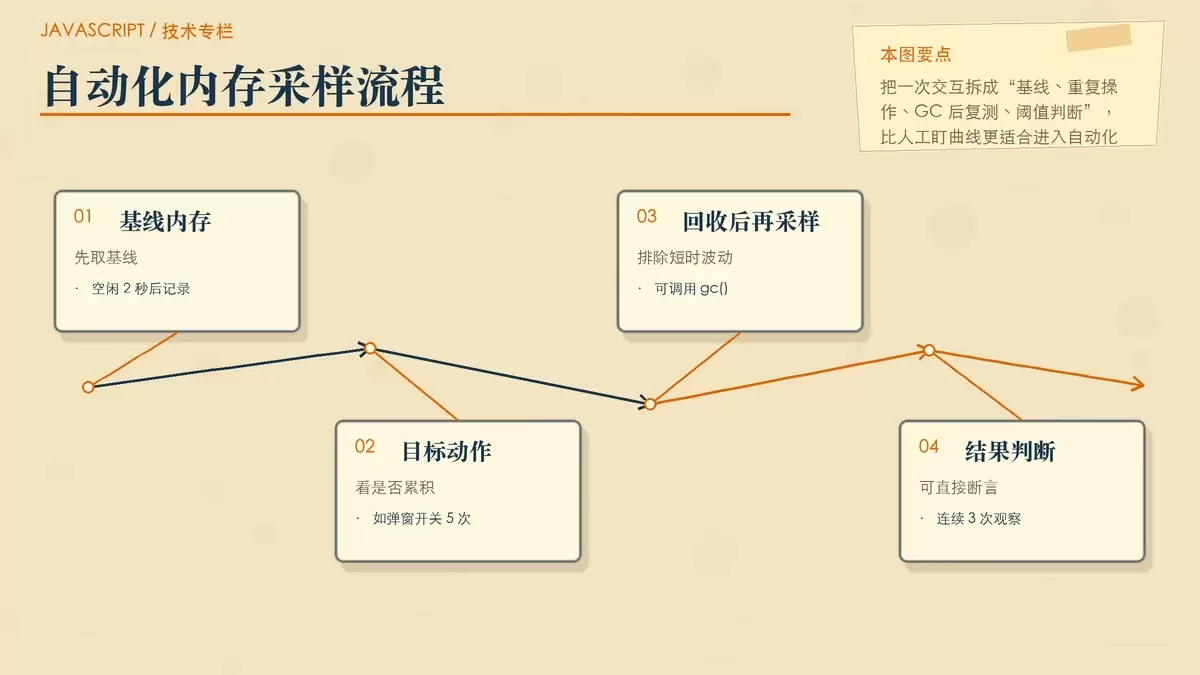
一条常见的测试路径可以这样设计:
- 进入页面后空闲 2 秒,记录基线内存:
usedJSHeapSize - 执行目标操作,例如“打开弹窗 → 关闭 → 重复 5 次”
- 操作结束后等待 GC 完成;如需主动触发,可调用
await page.evaluate(() => gc()),前提是浏览器启用了--js-flags="--expose-gc" - 再次采样并计算差值;如果连续 3 次操作后内存增幅 > 15MB,即可判定测试失败
这套思路的重点,是把“偶发上涨”与“重复操作后不回落”区分开。一次性峰值未必代表泄漏,但同一动作反复执行后堆占用持续抬升,通常更值得警惕。
page.evaluate(() => performance.memory)
await page.evaluate(() => gc())
为什么还要同时监控 DOM 节点数
performance.memory 只在 Chrome 系环境可用,因此如果要把规则用于更完整的自动化体系,仍然需要一个跨浏览器的兜底指标。最实用的选择之一,就是统计页面当前 DOM 节点总数:document.querySelectorAll('*').length。
DOM 节点数不是直接的内存值,但它常常能反映泄漏的副作用,尤其适合发现组件销毁不完整、事件绑定未释放、路由切换后旧节点残留这类问题。
- 在路由切换、组件销毁后统计全量节点数,并与前一状态对比
- 如果节点数持续增加,例如每次进入列表页都新增
200+,且返回后没有回落,通常说明 DOM 未被清理,或者仍被 JS 强引用 - 可设置基础阈值:单次操作后节点增量 > 50,或一次会话内累计增长 > 500,即标记为可疑泄漏
这类指标的价值在于稳定。即便拿不到精确堆大小,只要页面结构不断膨胀,测试也能先一步发现风险,而不是等线上用户把标签页挂到卡死才回头排查。
堆快照怎么接入 CI 做离线比对
如果说内存采样和 DOM 统计解决的是“发现异常”,那么堆快照更适合回答“异常到底堆在哪”。在 Playwright v1.40+ 中,可以使用 page.takeHeapSnapshot() 导出 .heapsnapshot 文件,再交给 Node.js 脚本做离线比对。
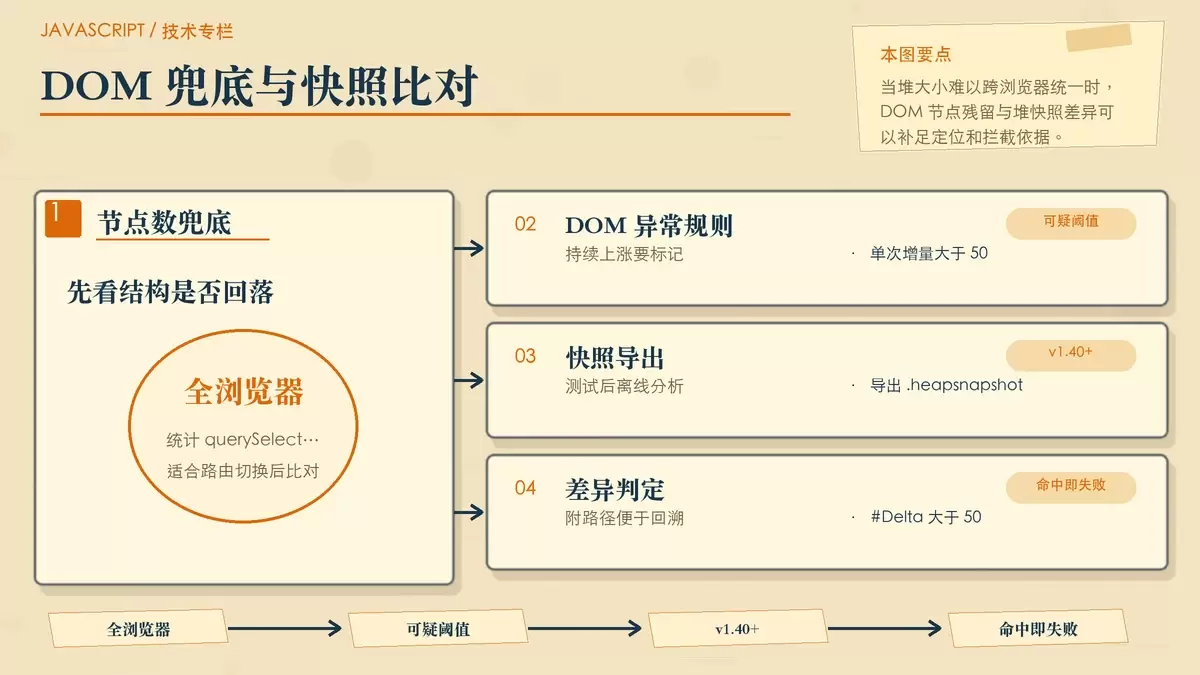
推荐的流程是:测试开始时保留一份 baseline 快照,关键操作全部完成后再导出 final 快照,然后用脚本比较两者的类型分布差异。
- 提取构造函数统计,例如
Closure、Detached HTMLDivElement实例数 - 对比 baseline 与 final,筛选
#Delta > 50且Retained Size > 2MB的类型 - 一旦命中规则,直接
fail test,并把快照文件路径附在结果中,便于研发回溯
这一步不一定要每条 E2E 用例都执行,因为堆快照本身成本更高,更适合放在关键页面、核心交互链路,或者作为夜间构建、专项性能回归的一部分。它的优势不是“更快”,而是能提供足够明确的定位线索。
page.takeHeapSnapshot()怎样把内存泄漏变成质量红线
自动化监控真正落地,关键在于阈值设计。不是所有内存增长都应该拦截,缓存、预加载和编辑器初始化都可能带来合理上涨,因此质量门禁必须分级,而不是一刀切。
一套更适合工程落地的规则,可以按影响程度拆成三层:
- 阻断级(直接 fail CI):同一操作重复 5 次后,JS 堆峰值增幅 ≥ 50MB,或 Detached DOM 节点数 ≥ 100
- 告警级(记录但不阻断):
Closure实例增长 ≥ 200,或全局变量新增 ≥ 5 个,可通过Object.keys(window).length的差值判断 - 白名单机制:对已知大缓存模块,例如富文本编辑器初始化,添加 ignore 标签,减少误报
这样处理有两个好处。第一,研发能清楚知道哪些问题会卡发布、哪些只是提示观察;第二,测试规则能随着业务逐步校准,而不是因为误报过多被团队绕开。
如果要把它当成长期机制,建议优先覆盖最容易反复进入的用户路径,例如列表页切换、弹窗打开关闭、富交互组件销毁重建等场景。这些链路最容易出现“每次多一点、几轮后就失控”的典型泄漏,也最适合用自动化脚本稳定复现。









