

Python内置函数大全:按功能分类的完整列表与速查
全面梳理Python 3官方内置函数,按类型转换、数值计算、迭代操作、反射与属性、输入输出、动态执行及面向对象7大维度完整分类,提供高频函数详解、易混淆辨析与避坑指南。
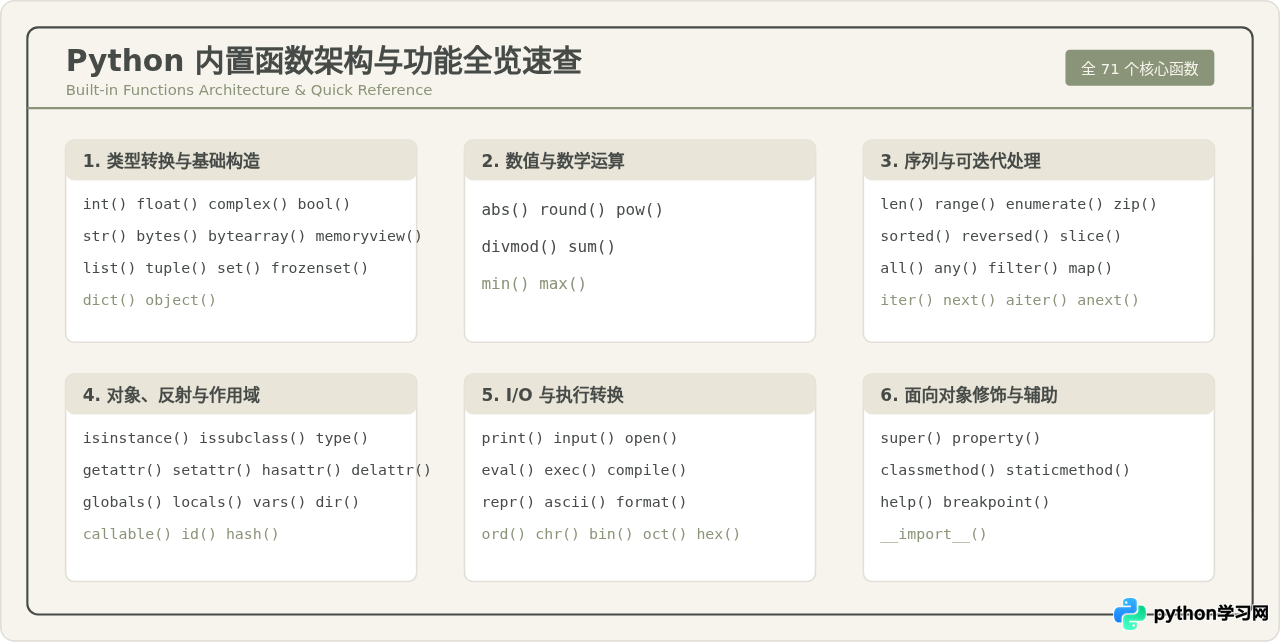
Python 解释器内置了约 70 个无需额外导入即可直接调用的函数与类型构造器。本文围绕这批核心工具,按照实际开发功能划分为 7 大类别,提供完整的速查清单、典型代码示例与应用边界,并对日常编程中最容易混淆的函数进行逐一对比说明。
一、为什么要熟练掌握内置函数?
Python 的内置函数直接驻留在 builtins 模块中。在解释器启动时,这些函数会被加载到全局命名空间的内置作用域中。相较于第三方库或自己用纯 Python 编写的循环逻辑,内置函数大多由 C 语言(CPython 实现)直接底层封装,不仅执行速度极快,而且经过了严格的边界测试。
合理使用内置函数不仅能显著减少代码行数,还能让代码具备更优的可读性与惯用法(Pythonic)特征。例如使用 enumerate() 替代手动维护计数器,使用 any() 和 all() 替代繁琐的布尔判断循环等。
二、按功能分类的内置函数完整列表
1. 类型转换与基础数据构造(15个)
这部分严格来说多为 Python 的内置类型构造器(Constructor),但在语法上作为函数调用使用,负责基础类型实例化与类型强制转换。
| 函数名 | 核心功能与说明 | 速查示例 |
|---|---|---|
bool(x) |
将参数转换为布尔值,根据真值测试规则返回 True 或 False | bool(0) -> False |
int(x, base=10) |
转换为整型,支持传入字符串与进制基数 | int("1a", 16) -> 26 |
float(x) |
转换为浮点数,支持无穷大 "inf" 与 "nan" |
float("3.14") -> 3.14 |
complex(r, i) |
构造复数实部与虚部 | complex(1, 2) -> (1+2j) |
str(object) |
将对象转换为用户友好的字符串表示(调用 __str__) |
str(100) -> "100" |
bytes(x) |
返回不可变字节序列(0-255 整数序列或编码文本) | bytes("hi", "utf-8") |
bytearray(x) |
返回可变字节数组 | bytearray(b"abc") |
memoryview(obj) |
创建对象的内存视图缓冲区,实现零拷贝切片 | memoryview(b"abc") |
list(iterable) |
将可迭代对象构建为可变列表 | list((1, 2)) -> [1, 2] |
tuple(iterable) |
将可迭代对象构建为不可变元组 | tuple([1, 2]) -> (1, 2) |
set(iterable) |
构建无序且不重复的可变集合 | set([1, 2, 2]) -> {1, 2} |
frozenset(it) |
构建不可变集合,可作为字典键或存入集合 | frozenset([1, 2]) |
dict(**kw / it) |
构建键值对字典映射 | dict(a=1, b=2) |
object() |
返回最基础的新对象实例,没有属性字典,常用于哨兵 | SENTINEL = object() |
bin(x) / oct(x) / hex(x) |
将整数转换为二进制、八进制、十六进制字符串 | hex(255) -> "0xff" |
2. 数学运算与数值处理(7个)
提供基础运算、绝对值、极值与进位控制,无需导入 math 模块即可直接运行。
| 函数名 | 核心功能与说明 | 速查示例 |
|---|---|---|
abs(x) |
返回数值的绝对值;若为复数则返回其模长 | abs(-5) -> 5 |
divmod(a, b) |
同时计算商与余数,返回元组 (a // b, a % b) |
divmod(10, 3) -> (3, 1) |
pow(base, exp, mod=None) |
快速幂运算,若指定 mod 则执行高效模幂运算 (base**exp)%mod |
pow(2, 3) -> 8 |
round(number, ndigits=None) |
四舍六入五成双(银行家舍入法)取整或保留指定小数位 | round(2.5) -> 2; round(3.5) -> 4 |
sum(iterable, start=0) |
对可迭代对象中的数值求和,不可用于字符串拼接 | sum([1, 2, 3], 10) -> 16 |
max(arg1, arg2, *args, key=None) |
返回最大值,支持传入 key 函数自定义比较规则 | max(['a', 'bbb'], key=len) -> 'bbb' |
min(arg1, arg2, *args, key=None) |
返回最小值,支持 default 参数处理空序列 | min([], default=0) -> 0 |
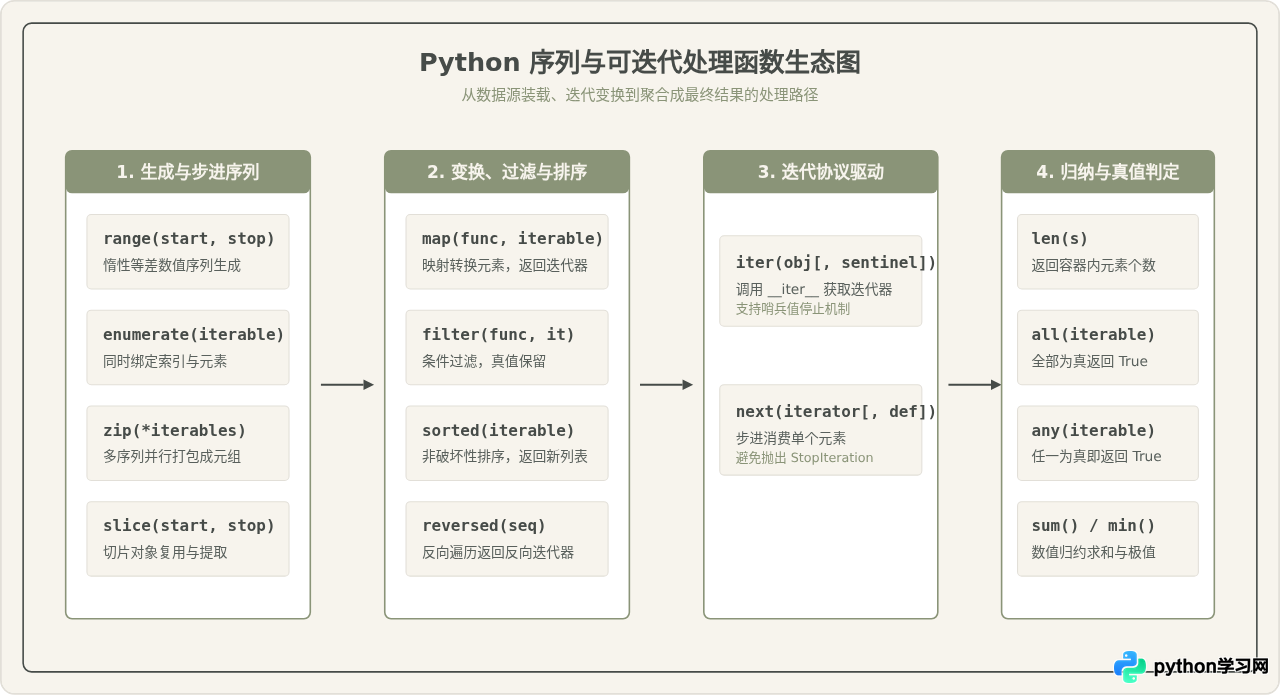
3. 序列与可迭代对象处理(14个)
这是 Python 函数式编程与日常数据清洗最常用的工具链,几乎涵盖了所有循环、切分与聚合场景。
| 函数名 | 功能说明 | 速查示例 |
|---|---|---|
len(s) |
返回对象的长度或元素个数(调用 __len__) |
len("Python") -> 6 |
range(stop) |
生成不可变的等差整数序列,支持负步长 | list(range(0, 5, 2)) -> [0, 2, 4] |
enumerate(iterable, start=0) |
返回枚举对象,产出元组 (index, item) |
for i, v in enumerate(items): ... |
zip(*iterables, strict=False) |
并行合并多个迭代器对应位置的元素为元组 | list(zip([1,2], ['a','b'])) |
sorted(it, key=None, reverse=False) |
返回排序后的全新列表,原数据不发生变化 | sorted([3, 1, 2]) -> [1, 2, 3] |
reversed(seq) |
返回反向迭代器(需支持 __reversed__ 或序列协议) |
list(reversed([1, 2, 3])) |
filter(function, iterable) |
提取使函数返回值为真的元素;若为 None 则过滤假值 | list(filter(None, [0, 1, False, 2])) -> [1, 2] |
map(function, *iterables) |
对可迭代对象的每个元素应用指定函数,惰性计算 | list(map(str, [1, 2])) -> ['1', '2'] |
all(iterable) |
若 iterable 中所有元素真值均为 True(或为空)返回 True | all([True, True]) -> True |
any(iterable) |
只要 iterable 中有任一元素为真即返回 True;空则返回 False | any([False, True]) -> True |
iter(object[, sentinel]) |
获取迭代器;传入 sentinel 时每次调用 object 直到等于哨兵 | it = iter([1, 2]); next(it) |
next(iterator[, default]) |
获取迭代器的下一个元素,迭代结束时返回 default 或抛异常 | next(it, None) |
slice(start, stop, step) |
返回切片对象,等价于 [start:stop:step] |
s = slice(1, 4); "abcdef"[s] -> "bcd" |
aiter(async_iterable) / anext() |
Python 3.10+ 新增,返回异步可迭代对象的异步迭代器及步进 | await anext(async_it) |
4. 反射、自省与作用域探索(14个)
Python 具备极强的动态特性,这一组函数允许开发者在运行时检查对象的属性、元数据及命名空间。
| 函数名 | 功能说明 | 速查示例 |
|---|---|---|
type(object) / type(name, bases, dict) |
查看对象类型,或动态创建新类 | type(123) -> int |
isinstance(obj, class_or_tuple) |
判断对象是否是某类或其子类的实例(推荐类型检查方式) | isinstance(True, int) -> True |
issubclass(class, classinfo) |
检查指定类是否为目标类的子类 | issubclass(bool, int) -> True |
hasattr(obj, name) |
判断对象是否包含指定字符串名称的属性或方法 | hasattr("str", "strip") -> True |
getattr(obj, name[, default]) |
获取对象属性;不存在时若未提供 default 则抛出 AttributeError | getattr(obj, "val", 0) |
setattr(obj, name, value) |
设置对象属性的值,等价于 obj.name = value |
setattr(obj, "x", 10) |
delattr(obj, name) |
删除对象属性,等价于 del obj.name |
delattr(obj, "x") |
callable(object) |
判断对象是否可以被调用(如函数、类、定义了 __call__ 的实例) |
callable(len) -> True |
id(object) |
返回对象的内存唯一标识符(CPython 中为内存地址) | id(a) == id(b) |
hash(object) |
返回对象的哈希值;不可哈希对象(如列表、字典)调用将报错 | hash("abc") |
dir([object]) |
返回对象的所有有效属性与方法名称列表;无参时返回当前作用域名称 | dir([]) |
vars([object]) |
返回模块、类、实例的 __dict__ 属性;无参等价于 locals() |
vars(user_obj) |
locals() |
更新并返回当前局部作用域字典(函数内不可靠修改) | locals() |
globals() |
返回当前模块全局作用域字典(修改直接影响模块全局变量) | globals()["DEBUG"] = True |
5. 输入输出、文件与格式化(7个)
负责控制台交互、磁盘 I/O 以及文本显示转换。
| 函数名 | 功能说明 | 速查示例 |
|---|---|---|
print(*objs, sep=' ', end='\n', file=sys.stdout, flush=False) |
将对象输出到指定流,支持自定义分隔符与立即刷新 | print("A", "B", sep="-") -> A-B |
input([prompt]) |
读取标准输入并以字符串形式返回,自动剥离末尾换行 | name = input("请输入: ") |
open(file, mode='r', encoding=None) |
打开文件并返回文件流对象,推荐搭配 with 上下文使用 |
with open("f.txt", "r", encoding="utf-8") as f: |
format(value[, format_spec]) |
根据格式规范对值进行格式化转换(如对齐、千分位、精度) | format(1234567, ",") -> "1,234,567" |
repr(object) |
返回对象的规范字符串表示,力求可以传给 eval() 重建 |
repr("hello\n") -> "'hello\\n'" |
ascii(object) |
类似 repr,但将非 ASCII 字符转义为 \x、\u |
ascii("中文") -> "'\\u4e2d\\u6587'" |
ord(c) / chr(i) |
单个字符与其对应的 Unicode 码位整数之间双向转换 | ord('A') -> 65; chr(65) -> 'A' |
6. 动态执行与编译控制(4个)
支持直接在运行时将字符串当做 Python 代码编译与执行,灵活性高但需要警惕代码注入风险。
| 函数名 | 功能说明 | 速查示例 |
|---|---|---|
eval(expression, globals=None, locals=None) |
求值单个表达式字符串并返回结果 | eval("1 + 2 * 3") -> 7 |
exec(object, globals=None, locals=None) |
执行动态生成的代码块或语句(不返回计算结果) | exec("a = 1\nb = a + 2") |
compile(source, filename, mode) |
将代码编译为代码对象,配合 exec 或 eval 重复执行 | code = compile("x+1", "", "eval") |
__import__(name) |
解释器底层的导入钩子,业务中通常推荐 importlib.import_module |
math = __import__("math") |
7. 面向对象修饰器与交互辅助(7个)
涵盖 Python 面向对象高级属性控制以及交互式调试工具。
| 函数名 | 功能说明 | 速查示例 |
|---|---|---|
super([type[, obj]]) |
返回代理对象,按照方法解析顺序(MRO)委托父类方法 | super().__init__() |
property(fget, fset, fdel) |
将方法包装为属性访问,常用作 @property 装饰器 |
@property def age(self): ... |
classmethod(function) |
将方法转为类方法,第一个参数隐式接收类本身 cls |
@classmethod def from_dict(cls): ... |
staticmethod(function) |
将方法转为静态方法,不隐式接收实例或类 | @staticmethod def util(): ... |
help([object]) |
启动内置帮助系统或直接打印对象的 docstring 文档 | help(str.split) |
breakpoint(*args, **kws) |
Python 3.7+ 原生断点,自动调用底层调试器(如 pdb) | breakpoint() |
三、核心易混淆函数对的深度辨析
初学者和中级开发者常常在特定函数对的选择上存在疑惑。理解它们的内部运作原理与成立前提,能够帮助我们写出更健壮的代码。
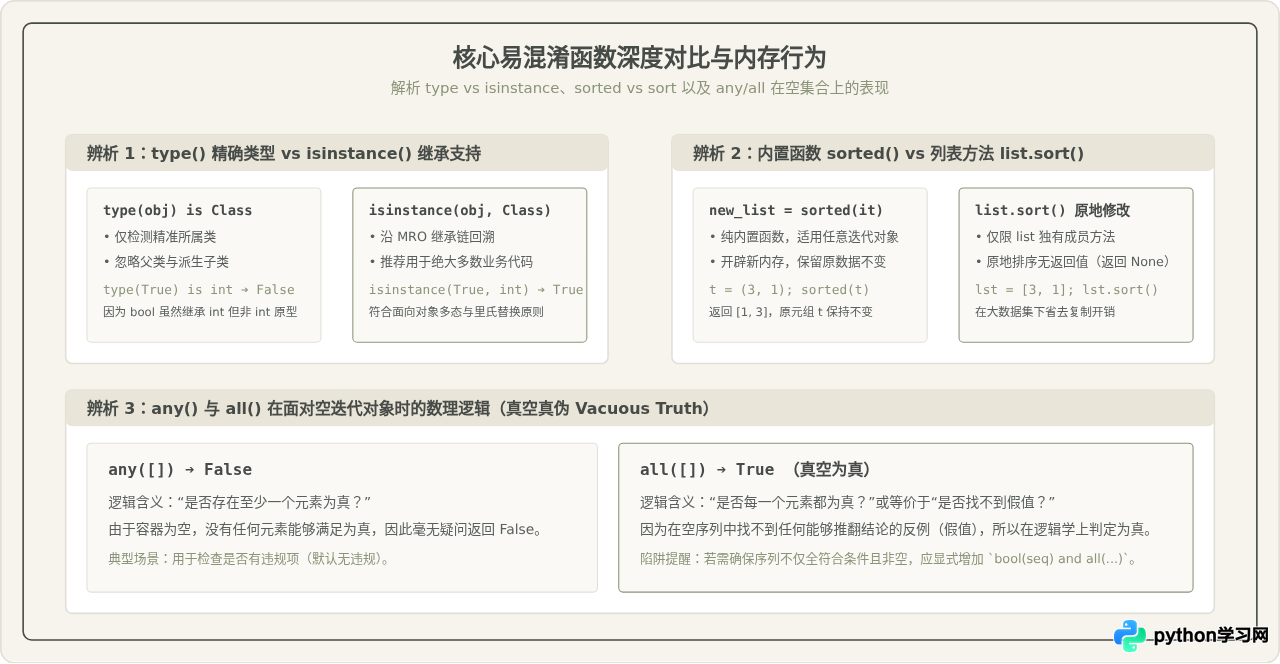
1. 为什么推荐 isinstance() 而非 type() 进行类型断言?
部分初学者认为 type(obj) is int 比 isinstance(obj, int) 更加“干净准确”。但这种做法打破了面向对象的多态性。
# 场景:Python 中的布尔类型 bool 实际继承自整型 int
print(isinstance(True, int))  # 输出: True (符合逻辑,True 在算术中可代表 1)
print(type(True) is int)       # 输出: False (无法匹配)

# 自定义派生类
class SecureString(str):
    pass

token = SecureString("secret_token")
print(isinstance(token, str))  # 输出: True,兼容字符串全部标准接口
print(type(token) is str)      # 输出: False,导致外部逻辑误判拒绝
只有当你必须严格拒绝任何派生子类、只接受纯粹的原生基类时,才使用 type() is Target,绝大多数常规场景务必使用 isinstance()。
2. iter() 的双参数哨兵模式(容易忽略的高级用法)
一般用法中,我们只传入一个对象 iter(iterable)。但 iter(callable, sentinel) 提供了极具魅力的循环步进机制:
# 传统按块读取文件
with open("data.bin", "rb") as f:
    while True:
        chunk = f.read(1024)
        if chunk == b"":
            break
        process(chunk)

# 使用 iter() 哨兵模式简化
with open("data.bin", "rb") as f:
    for chunk in iter(lambda: f.read(1024), b""):
        process(chunk)
这种形式省去了手动 break 和临时变量检查,代码清晰且富有表现力。
四、生产实践避坑指南与最佳实践
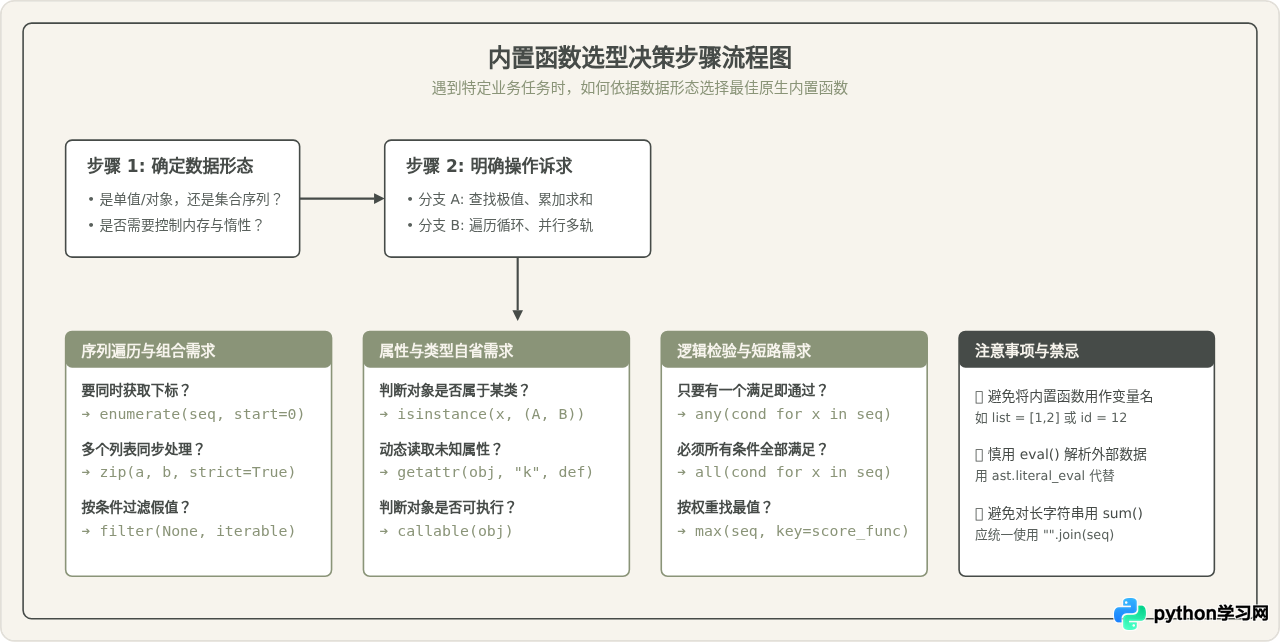
Python 的变量查找规则遵循 LEGB(Local -> Enclosing -> Global -> Built-in)。如果在局部作用域将变量命名为
list = [1, 2, 3] 或 id = 100,会使该作用域内的内置函数 list() 和 id() 被覆盖遮蔽,后续尝试调用 list() 时将抛出 TypeError: 'list' object is not callable。
当从接口、前端或用户输入中反序列化 Python 原生格式(如字符串字典
"{'a': 1}")时,切勿直接使用 eval(),否则可能遭受 __import__('os').system('rm -rf /') 注入攻击。应统一使用标准库中的 ast.literal_eval(),它仅求值字面量结构,遇到语句或函数调用直接报错,确保安全。
在现代 Python 开发中,列表推导式与生成器表达式通常比普通的
map() 和 filter() 更加直观。例如 [x * 2 for x in nums if x > 0] 往往优于 map(lambda x: x*2, filter(lambda x: x>0, nums))。但在已经存在现成命名字典或转换函数时,map(int, str_list) 则依然比 [int(x) for x in str_list] 更简短纯粹。
五、总结与速查建议
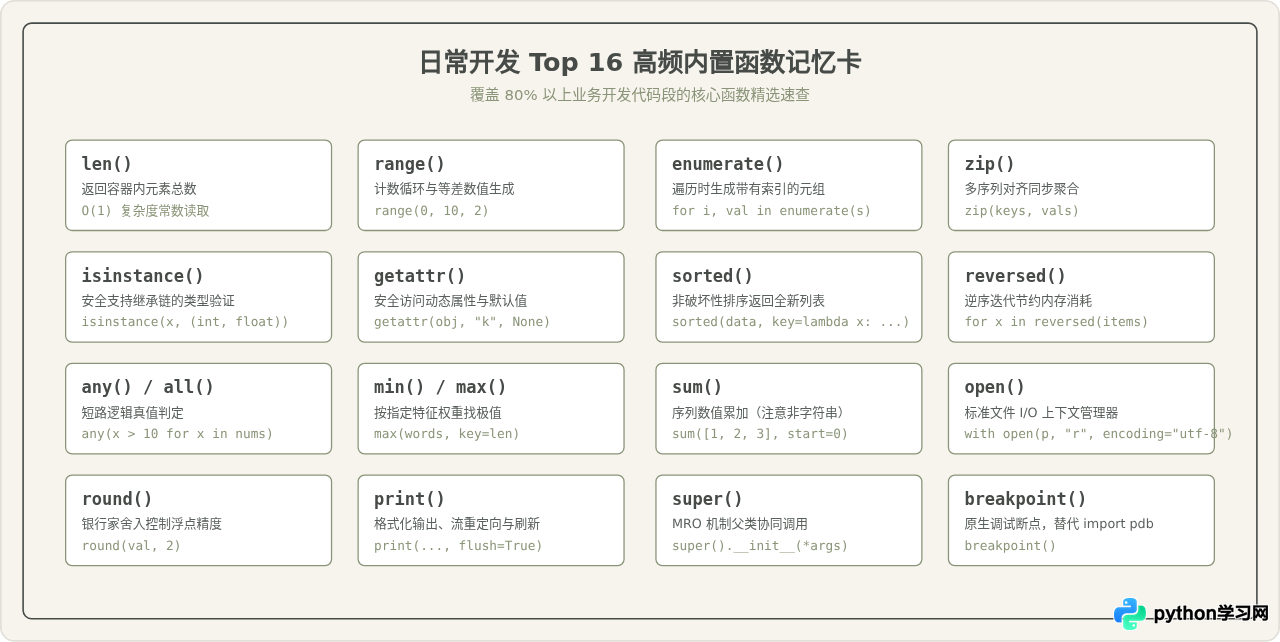
熟练使用 Python 内置函数是写出地道 Python 代码的基础。在日常编码中,建议优先建立以下反射习惯:
- 需要下标时,第一时间想到
enumerate(),杜绝for i in range(len(lst))这种反模式。 - 多个关联列表遍历时,使用
zip(),必要时传入strict=True保证长度一致。 - 判断属性或方法存在时,使用
hasattr()或结合getattr()赋予默认回退值。 - 判断数据类型时,始终优先使用
isinstance()。 - 对任意复杂集合提取极值或排序时,充分利用
key=callable参数,而不是自行撰写复杂的冒泡或临时排序结构。
随着对这些内置函数的深入理解与灵活组合,你将能以更少、更健壮的代码,实现更高性能的数据流处理与业务逻辑。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









