

NGINX2Root 被利用能查出来吗?CVE-2026-123007 的连接级特征、检测规则与加固清单
CVE-2026-123007 的触发控制帧不进访问日志,链路又被 TLS 加密。本文给出连接级收发字节、HTTP/2 专用日志、worker 崩溃取证、auditd execve 四类可落地信号,以及命中后的处置顺序与加固基线。
核心判断:查这个漏洞别从 URL 和状态码下手,要换到连接维度。最有效的三条信号是:① 单条长连接上 bytes_received 一路猛涨而 bytes_sent 几乎不动;② error.log 里出现 signal 11 或 worker process ... exited 并伴随 core dumped;③ nginx worker 执行了外部命令(由 auditd 捕获 execve)——这条一旦坐实,基本可以按已 RCE 处理,不再只是「疑似」。
01 · 攻击长什么样:四步把窗口推过上限
CVE-2026-123007 本质是 HTTP/2 流控的记账错误。研究方(Xint)公开的链路可以简化成四步:
- 挂住 DATA,让额度一直被占着:客户端把
SETTINGS_INITIAL_WINDOW_SIZE设成 0,NGINX 就发不出响应体;再用 PING 洪水填满 TLS/TCP 缓冲,随后用WINDOW_UPDATE给流充值,使 NGINX 把 DATA 排进队列,并从连接窗口h2c->send_window扣掉额度 Q。 - 同一笔额度 Q 被加回两次:先对 Stream 0 发
WINDOW_UPDATE授予 Q,再发RST_STREAM取消该流,清理函数把未发送的 DATA 额度退还,又加了一次 Q——这一次没有上限校验。 - 无符号下溢绕开上限检查:
NGX_HTTP_V2_MAX_WINDOW - send_window在size_t上回绕成极大的正数,此后任意WINDOW_UPDATE都会被接受,窗口能被推到任意 64 位值。 - 转成越界拷贝:窗口转成有符号
off_t后变成负值-d,传进memcpy()时又变回2^64 - d的超大长度,在堆上形成越界读与越界写;攻击者据此泄露地址、覆盖 cleanup 回调指针,最终以 worker 权限执行命令。
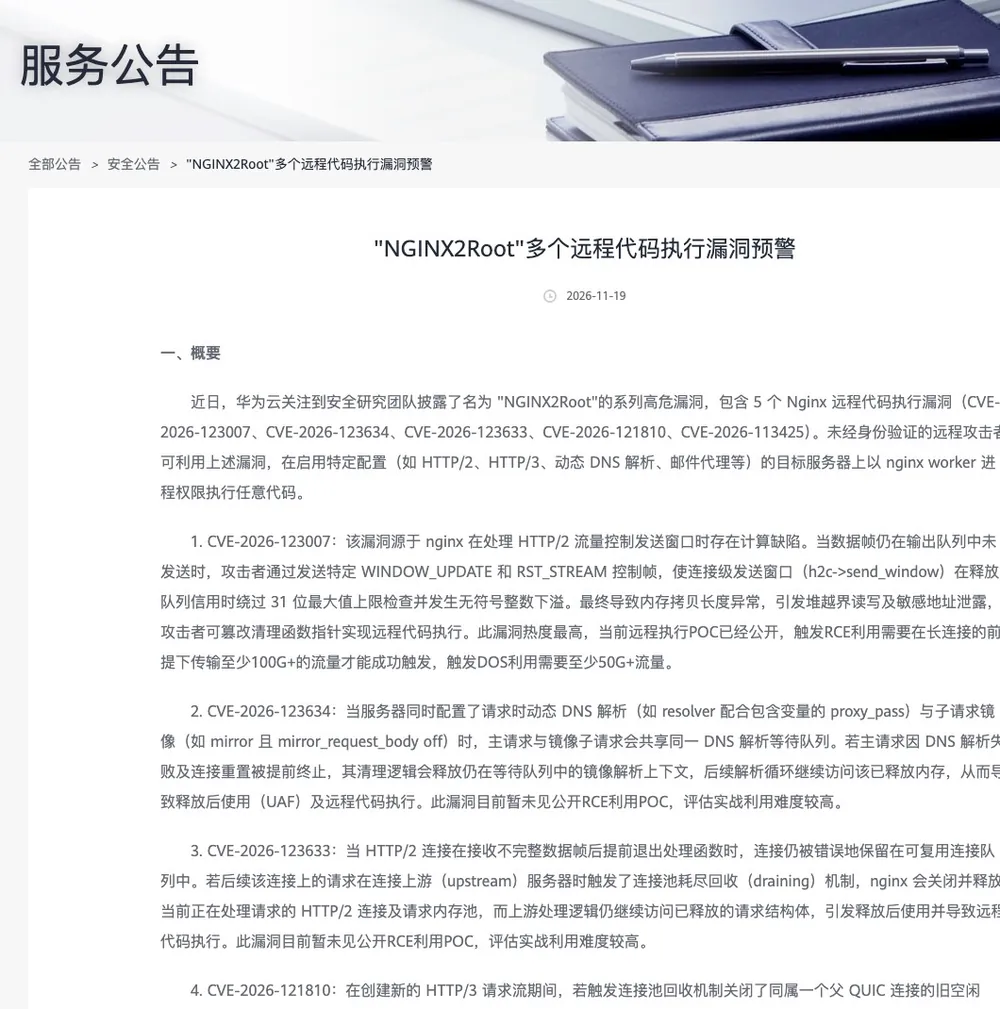
这条「100GB 级流量」的门槛在中文预警里写得很清楚,可以拿来作为内部立项整改的依据:
02 · 为什么访问日志看不见
常规 Web 攻击检测依赖访问日志里的 URI、状态码、User-Agent,这套办法在 NGINX2Root 上会失效,原因有两点:
- 控制帧不是请求:
WINDOW_UPDATE、RST_STREAM、SETTINGS、PING属于 HTTP/2 连接层帧,NGINX 不会把它们写成访问日志条目。 - 链路被 TLS 加密:中间的 IDS 只能看到长度与方向,看不到帧类型;若 NGINX 前面还有 CDN 或 L7 代理终结了 TLS,攻击者也可能改由后端复用连接发起,视角更碎。
结论:必须补两类数据源——连接级统计(每条连接的收发字节、持续时间)与主机级行为(worker 崩溃、子进程、文件写入)。访问日志只能当辅助。
研究方在披露文章里专门写了「检测」章节,明确指出这两个方向;版本发布信息也可以回官方首页核对:
03 · 信号一:连接级指标与自定义日志
临时排查:直接看每条连接的收发字节
# 观察所有 443 端口 ESTABLISHED 连接的字节计数(含 tcp_info 细节)
ss -tinp state established '( sport = :443 )'

# 两次采样间隔 30s,比较 bytes_received 增量最直观
ss -tinp state established '( sport = :443 )' > /tmp/a.txt
sleep 30
ss -tinp state established '( sport = :443 )' > /tmp/b.txt
判断口径:正常浏览或 API 调用通常是「发出去的多、收进来的少」;如果某条连接接收字节持续快速上涨、发送字节几乎不动,且已持续数分钟,就要进一步核实来源。
长期方案:给 HTTP/2 单独记一份日志
把连接标识、请求数、请求体长度一起记下来,就能看出「数据进来了但不构成请求」的错位:
# /etc/nginx/conf.d/h2-hunt.conf
log_format h2_hunt '$remote_addr [$time_local] conn=$connection '
 'req=$connection_requests ssl=$ssl_protocol/$ssl_cipher '
 'len=$request_length rt=$request_time '
 'body=$request_body_bytes status=$status';

# 在 server 块内启用(只需 HTTP/2 的 server)
access_log /var/log/nginx/h2_hunt.log h2_hunt;

# 事后筛出 HTTP/2 且请求体异常大的记录
awk '$4 ~ /HTTP\\/2/ || $0 ~ /len=[0-9]{7,}/' /var/log/nginx/h2_hunt.log | tail -50conn 值很少(甚至只有一条连接)、req 增长很慢、request_length 很小,但该连接入站字节以 GB 计。「连接在收数据,请求数却不涨」就是最值得告警的错位。
再加一层连接级限速兜底
# 限制单 IP 的并发连接与新建速率,抬高"单连接灌 100GB"的成本
limit_conn_zone $binary_remote_addr zone=perip:10m;
limit_req_zone $binary_remote_addr zone=peripr:10m rate=20r/s;

server {
 listen 443 ssl;
 http2 on;
 limit_conn perip 30;
 limit_req zone=peripr burst=40 nodelay;
 # 单连接读写超时,压缩"长连接"可利用的时间窗
 client_header_timeout 10s;
 client_body_timeout 15s;
 send_timeout 20s;
}
限速不会让漏洞消失,但能把「一条连接跑一小时」变成「跑不完」,同时给监控留出发现时间。
04 · 信号二:worker 崩溃与进程行为
错误日志与 core dump
# worker 异常退出、段错误
grep -Ei 'worker process.*exited|signal 11|signal 6|segfault|core dumped' /var/log/nginx/error.log

# 系统级 core 记录(systemd-coredump)
coredumpctl list nginx --no-pager | tail -20

# 崩溃频率:按小时统计,突增就是强信号
grep -Ei 'signal 11|worker process.*exited' /var/log/nginx/error.log \
 | awk '{print $1" "$2}' | uniq -c | tail -24
要注意:单个 worker 崩了之后 master 会自动拉起新 worker,服务「看起来正常」,很容易被忽略。所以要么把这类日志接进告警,要么定期对账。
最确凿的证据:worker 执行了外部命令
正常的 nginx worker 没有任何理由 fork/exec 外部程序。RCE 成功后的第一步几乎一定是执行命令,所以这条规则一旦命中,直接按「已失陷」处理:
# /etc/audit/rules.d/nginx-exec.rules
# 监控所有 nginx worker 的 execve / execveat
-a always,exit -F arch=b64 -S execve,execveat -F uid=nginx -k nginx_exec
-a always,exit -F arch=b32 -S execve,execveat -F uid=nginx -k nginx_exec

# 生效并查询
augenrules --load
ausearch -k nginx_exec -i --start recent

# 若 worker 以 root 运行(不推荐但常见于容器),把 uid 换成 0 单独加一条user nginx;,并用 systemd 的 NoNewPrivileges=yes、ProtectSystem=strict、PrivateTmp=yes 收窄影响面;容器内则避免 --privileged 与 root 用户。
主机侧还能看到哪些破绽
- worker 进程出现异常子进程(
ps --ppid <worker_pid>非空)。 - worker 对
/tmp、/dev/shm有写入(正常 nginx 只写临时缓冲目录)。 - 来自 nginx 用户的外连(反弹 shell、下载二阶段载荷)。
- NGINX 进程 RSS 异常增长后突然回落(对应越界读写与大块拷贝)。
05 · 规则怎么写:Zeek / Suricata / SIEM 思路
能解 HTTP/2 帧的传感器效果最好,解不了的只能退到「流量体量与行为」维度。三类规则的思路如下:
| 数据源 | 可用的判据 | 误报控制 |
|---|---|---|
| Zeek(http2 分析器) | 单连接 window_update 帧数量、rst_stream 与 DATA 帧比例、连接存活时长 | 对大文件上传/下载业务做白名单;阈值按 P99 设,例如单连接 WINDOW_UPDATE > 10 万次 |
| Suricata / 镜像流量 | 单连接入站字节 > N GB 且出站字节 < M MB、连接持续 > 5 分钟、同源 IP 并发大量短 TLS 连接 | 排除备份、镜像同步、视频上传等已知大流量通道 |
| 主机侧(auditd / Falco) | worker 进程 execve、异常子进程、写入 /tmp | 排除 logrotate、certbot 等合法钩子;按 worker uid + 父进程 ppid 双重限定 |
| 日志侧(SIEM) | error.log 中 signal 11 计数突增;同 IP 短时多次触发 worker 重启 | 与内核 OOM、硬件故障导致的崩溃区分(看是否伴随大量入站流量) |
伪规则:Zeek 单连接控制帧突增
# 思路示例(非可直接部署代码,需按你的 Zeek 版本调整)
event http2_window_update(c: connection, stream_id: count, delta: count)
{
 # 以连接为单位累计 WINDOW_UPDATE 次数
 ++c$h2_wu_count;
 if ( c$h2_wu_count > 100000 && c$h2_bytes_in > 5 * 1024 * 1024 * 1024 )
 NOTICE([$note=NGINX_H2_WINDOW_ABUSE,
 $conn=c,
 $msg=fmt("suspicious WINDOW_UPDATE burst: %d frames", c$h2_wu_count)]);
}
伪规则:SIEM 把两条弱信号合成一条告警
单独看「流量大」或「worker 崩了」都容易误报,但两者落在同一时间窗、同一源 IP 上就很可疑:
告警条件:
 在 15 分钟窗口内,满足以下任意两条:
 A. 某源 IP 到 443 的连接入站字节 > 20GB,且出站/入站 < 0.01
 B. 同一时段 error.log 出现 >= 2 次 'signal 11' 或 'worker process ... exited'
 C. 同一 IP 在 1 分钟内新建 TLS 连接数 > 200
 D. auditd 命中 worker 的 execve(单条即可直接升级为事件)
06 · 命中之后:处置顺序与提权排查
NGINX2Root 的完整链路是「先拿下 worker,再借内核 SCTP 漏洞提权到宿主机 root」,所以处置不能停在「升级 nginx」就结束:
- 先阻断来源:在边缘封禁源 IP/CIDR;对被灌流量的实例临时摘除负载均衡,避免持续被打崩。
- 先取证再动服务:保存
/var/log/nginx、journalctl -u nginx、coredumpctl的 core、ps -ef --forest与ss -tinp快照。coredump 是判断「只是 DoS」还是「内存已被改写」的关键证据。 - 升到 1.30.7 / 1.31.9 并重启或 USR2 热升级(reload 不替换旧 worker,详见运维篇)。
- 按「已失陷」排查:审计 worker 用户的 crontab、systemd unit、
/tmp与网站目录的近期变更文件、出站连接与 DNS 查询。 - 排查内核提权痕迹:
uname -r与内核 SCTP 修复状态;lsmod | grep sctp是否已加载;业务不需要 SCTP 就用install sctp /bin/false屏蔽加载,并在下个维护窗升级内核。 - 凭据与密钥:确认 RCE 后,轮换该主机上的 TLS 私钥、上游认证凭据、数据库口令与 API Key,并检查是否被用于横向移动。
- 复盘:补齐本批 10 个漏洞的修复(同一次升级即可覆盖),把「worker 崩溃告警」和「worker execve 告警」固化成常驻规则。
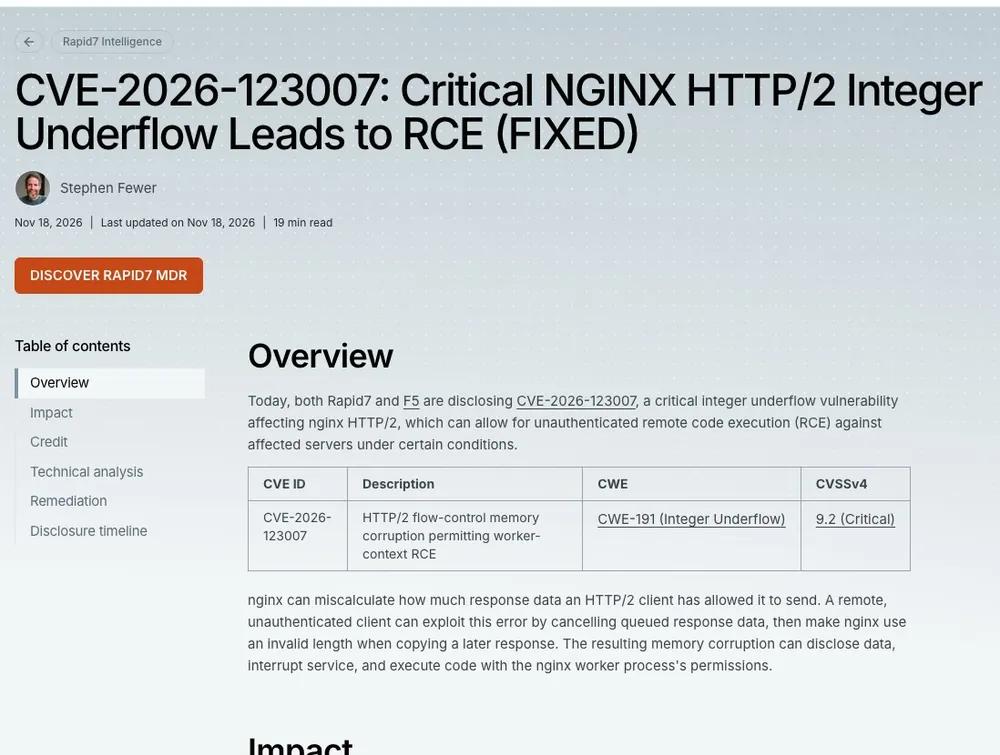
Rapid7 已公开针对 1.31.8 的未认证利用代码,PoC 不再停留在论文层面:
07 · 加固基线:从配置到内核
| 层面 | 措施 | 说明 |
|---|---|---|
| 版本 | 升到 1.30.7 / 1.31.9(Plus 37.3.0.1 / 37.0.8.1),重启或 USR2 | 唯一根治手段;同批修复 10 个漏洞 |
| 协议 | 非必要不开 HTTP/2;必须开则限制并发与超时 | 关闭可阻断 123007/123633,但不覆盖 121810/123634/113425 |
| 权限 | user nginx; + systemd 沙箱(NoNewPrivileges / ProtectSystem / PrivateTmp) | 把 RCE 后果限制在低权限 worker |
| 出站 | 默认拒绝 worker 用户出站,仅放行必要上游 | 阻断反弹 shell 与二阶段下载 |
| 内核 | 跟踪 SCTP 修复;不需要时 install sctp /bin/false | 阻止「worker→root」的提权链 |
| 内存防护 | 保持 ASLR 开启;内核开启 CONFIG_RANDOMIZE_BASE | 官方说明:ASLR 关闭时更易 RCE |
| 可见性 | HTTP/2 专用日志 + 连接级指标 + auditd execve 规则 | 弥补访问日志盲区 |
官方版本发布公告逐条列出本批修复的 10 个 CVE,可用来核对「我升到 1.31.9 是否已经全覆盖」:
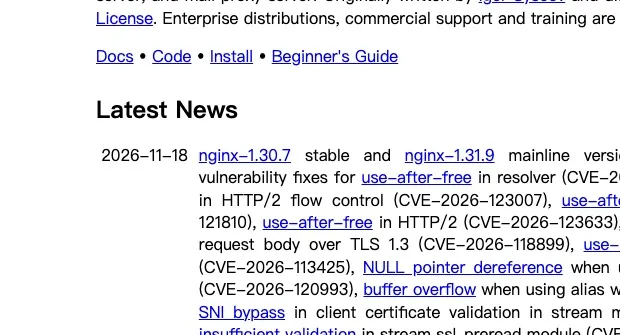
08 · 五个 CVE 的暴露面自查表
把这张表贴进资产台账逐行打勾,比笼统问一句「我们有没有 NGINX」有用得多:
| CVE | 需要什么配置才暴露 | 快速自查命令 |
|---|---|---|
| 2026-123007 | HTTP/2 开启 | nginx -T | grep -E 'http2 on|listen .*http2' |
| 2026-123633 | HTTP/2 + 转发到上游 | nginx -T | grep -E 'proxy_pass|grpc_pass' |
| 2026-121810 | HTTP/3 + 转发到上游 | nginx -T | grep -E 'http3 on|listen .*quic' |
| 2026-123634 | resolver + 变量 proxy_pass + mirror | nginx -T | grep -E 'resolver|mirror|proxy_pass .*\$' |
| 2026-113425 | 邮件代理 + auth_http | nginx -T | grep -E 'mail|auth_http|proxy on' |
09 · 常见问题解答
没有 WAF、也没有流量传感器,还能查吗?
ss -tinp 或 node_exporter 的 per-connection 指标看单连接收发比;② 给 HTTP/2 加一份 h2_hunt 日志;③ 给 error.log 里的 signal 11 加告警;④ 给 worker 用户加 auditd execve 规则。这四件事覆盖了从 DoS 到 RCE 的完整信号链。worker 崩溃就一定是被攻击吗?
攻击一定需要 TLS 吗?明文 HTTP/2(h2c)受影响吗?
为什么说这条链能拿到宿主机 root?
告警里抓到一条连接 60GB 入站,是被打了吗?
connection_requests 很少、request_length 很小、磁盘几乎不增长。再结合该 IP 是否同时造成 worker 重启,就能基本定性。PoC 公开后,检测规则要全开吗?会不会被误报淹没?
10 · 参考来源
- nginx.org 安全公告(CVE-2026-123007 条目、影响与修复版本)
https://nginx.org/en/security_advisories.html - nginx.org 首页 Latest News(2026-11-18 发布 1.30.7 / 1.31.9 及本批 10 个 CVE)
https://nginx.org/ - Xint 披露与检测建议(利用链四步、流量特征、ss/auditd 建议)
https://xint.io/blog/nginx2root-remote-code-execution - Rapid7 分析(1.31.8 未认证利用代码已公开)
rapid7.com/blog/post/ve-cve-2026-123007 - 华为云预警(5 个 CVE、100GB+ RCE 流量门槛)
https://www.huaweicloud.com/notice/20261119184415432.html - F5 安全公告 K000163926(CVSS、CWE-191、受影响产品矩阵)
https://my.f5.com/manage/s/article/K000163926 - NC4 通告(检测与缓解口径)
https://www.nc4.gov.my/alertAdvisory-detail/NC4-ALR-2026-000017
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









